Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
2407 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  42  43  44  ..  60  61  62  63  64  65
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°46085
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 10:08:53  profilanswer
 

Reprise du message précédent :
How Fast Can One RTX 3060 Actually Run 35B (llama.cpp enhancement)?
https://www.youtube.com/watch?v=k_LostFpatg
 
Vidéo intéressante de Codacus sur les experts MoE, il parle d'un patch qu'il fait pour llama.cpp mais explique aussi comment les experts fonctionnent aussi.


---------------
Faudra que je teste un jour :o
n°46088
Pipould's
Posté le 24-08-2026 à 10:47:27  profilanswer
 

the_fennec a écrit :

How Fast Can One RTX 3060 Actually Run 35B (llama.cpp enhancement)?
https://www.youtube.com/watch?v=k_LostFpatg
 
Vidéo intéressante de Codacus sur les experts MoE, il parle d'un patch qu'il fait pour llama.cpp mais explique aussi comment les experts fonctionnent aussi.


Dur dur la video ia...

n°46089
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 11:05:44  profilanswer
 

Pipould's a écrit :


Dur dur la video ia...


Tu veux dire la voix?  :lol:  
 
C'est pas de l'IA, c'est l'accent indien:
https://www.youtube.com/watch?v=9NfMNdqBKxE


---------------
Faudra que je teste un jour :o
n°46090
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 11:08:10  profilanswer
 

Unsloth Dynamic 3.0 GGUFs:
https://unsloth.ai/docs/basics/dynamic-3.0-ggufs
 

Citation :

Today, we’re releasing Qwen3.8-27B Dynamic v3.0 quants that deliver >10% top-1% better accuracy at the same size compared to every other provider. This is an update of our first shared early preview version of Dynamic v3.0. The new 3.0 GGUFs work with most inference engines including llama.cpp and Unsloth Desktop.
 
Dynamic v3.0 overall preserves more model quality while keeping the same size, with stronger results across metrics like Divergence-300 @32 and KL Divergence.


Mais bon, pas trop envie de relancer llama.cpp:
https://i.imgur.com/PeYbrQB.png

Message cité 1 fois
Message édité par the_fennec le 24-08-2026 à 11:08:18

---------------
Faudra que je teste un jour :o
n°46091
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 11:32:35  profilanswer
 

neo world a écrit :


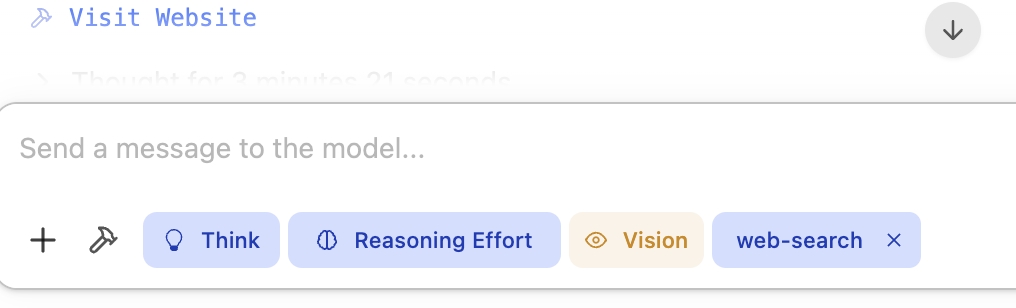
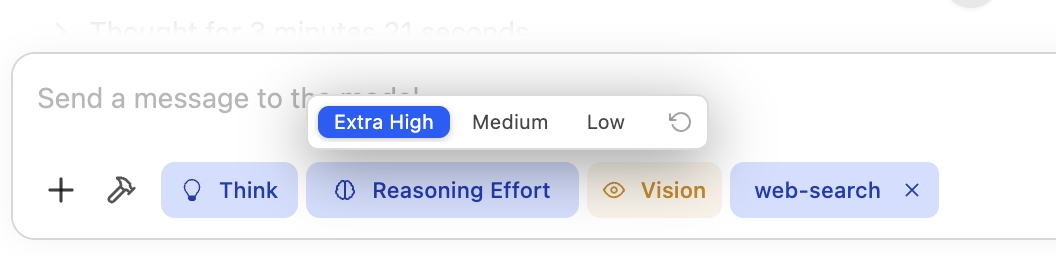
Tu as les flags sous la conversation, tu clic sur extra high et tu sélectionnes le niveau que tu veux avant d’envoyer ton message. Ils ont mis à jour LM studio genre 5h après la sortie du modèle pour ça :love:


j'suis en version stable et je vois pas du tout ces trucs.
j'dois être aveugle (ou neuneu) :(

n°46092
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 11:33:51  profilanswer
 

the_fennec a écrit :


De mon coté c'est du dev, Gemma tiens pas longtemps sans foirer un tool call.
 
Qwen 3.8 s'en sort mieux:
https://i.imgur.com/fDWY3en.png


punaise, 3j :lol:
j'ai déjà la flemme d'attendre 30min la fin du thinking !

the_fennec a écrit :

Unsloth Dynamic 3.0 GGUFs:
https://unsloth.ai/docs/basics/dynamic-3.0-ggufs
 

Citation :

Today, we’re releasing Qwen3.8-27B Dynamic v3.0 quants that deliver >10% top-1% better accuracy at the same size compared to every other provider. This is an update of our first shared early preview version of Dynamic v3.0. The new 3.0 GGUFs work with most inference engines including llama.cpp and Unsloth Desktop.
 
Dynamic v3.0 overall preserves more model quality while keeping the same size, with stronger results across metrics like Divergence-300 @32 and KL Divergence.


Mais bon, pas trop envie de relancer llama.cpp:
https://i.imgur.com/PeYbrQB.png


crash lamentablement chez moi : il charge mais il a rien à dire :/

Message cité 1 fois
Message édité par moyen_moins le 24-08-2026 à 11:35:48
n°46094
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 12:19:26  profilanswer
 

moyen_moins a écrit :


punaise, 3j :lol:
j'ai déjà la flemme d'attendre 30min la fin du thinking !


Je reste pas devant :D
 

moyen_moins a écrit :


crash lamentablement chez moi : il charge mais il a rien à dire :/


Unsloth Dynamic 3 ou claude code?


---------------
Faudra que je teste un jour :o
n°46096
morcok
Posté le 24-08-2026 à 12:35:32  profilanswer
 

Pipould's a écrit :


Dur dur la video ia...


pourtant c'est un des youtuber ai les plus interessants

n°46097
Pipould's
Posté le 24-08-2026 à 12:46:32  profilanswer
 

the_fennec a écrit :


J'avais trouvé un listing a $600 sur globalsources.com, mais sans surprise:
 

Citation :


About the USED CMP 170HX 8GB, let me share you the detail.
 
USED CMP 170HX  8Gb: 1309USD
DHL shipping cost : 65USD
Grand total is 1309+65=1374USD
...
yes, the price on the page was about 660USD, as the demand of this GPU card is soaring and the supply is limited, so the price is higher than the price i show on the page, sorry for not updating the price in time and makes you in trouble.  


Tu as un avis sur global sources en terme de site ? Un vendeur a 4 years + est recommandable ?

n°46098
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-08-2026 à 12:49:25  profilanswer
 

Je passerais plutôt par alibaba, attention les prix sont hors fdp et hors taxes.


---------------
Victime de girafophobie, mais se soigne.
n°46099
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 12:49:49  profilanswer
 

Pipould's a écrit :


Tu as un avis sur global sources en terme de site ? Un vendeur a 4 years + est recommandable ?


Non j'ai jamais commandé, j'ai trouvé ce site en tant qu'alternative a Alibaba, mais j'ai aucune commande la-bas non plus. Pour l'instant mes BC250 viennent d'Aliexpress.
 
Je pense que vu les moyens de paiement (virement, Bitcoin, etc.) c'est DTC si un truc se passe mal. A 200 balles j'aurais pris le risque, 600 probablement pas.


---------------
Faudra que je teste un jour :o
n°46100
bifidusse
(actif)
Posté le 24-08-2026 à 13:04:56  profilanswer
 

J'ai besoin d'un humain  :D  
 
Je continue mon petit voyage dans le monde fascinant de l'IA locale.
 
J'utilise Unsloth Desktop.
 
Mon but pour le moment : associer un petit modèle à un set de données.
 
A priori ce que je veux donc faire c'est du RAG (on verra plus tard pour le fine tuning).
 
Mais je ne vois pas comment faire dans Unsloth.
 
Anything LLm était plus simple à comprendre pour moi avec ses espaces de travail.
 
Idéalement j'aurais aimé demander à Unsloth d'utiliser un set de données tels que ceux que l'on peut trouver sur HF.
 
À terme, je lui fournirai des docs persos.
 
Merci !

n°46102
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 13:12:59  profilanswer
 

the_fennec a écrit :


Unsloth Dynamic 3 ou claude code?


UD3
j'avais tenté le Q6_KM et échec.

n°46106
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 13:49:03  profilanswer
 

moyen_moins a écrit :


UD3
j'avais tenté le Q6_KM et échec.


T'as un llama.cpp récent?


---------------
Faudra que je teste un jour :o
n°46108
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 13:53:04  profilanswer
 

the_fennec a écrit :


T'as un llama.cpp récent?


J'avoue que par feignantise, je reste avec lmsutdio mais c'est trop lent les màj (j'suis sur le canal 'stable').
J'ai pas testé un llama.cpp récent.


Quelqu'un se dévoue pour faire un gui bien conçu pour les feignants pour llama.cpp avec qwen 3.8 en xtra high ? :o
(ça sert à rien mais bon)

Message cité 1 fois
Message édité par moyen_moins le 24-08-2026 à 13:58:46
n°46109
lapin
Posté le 24-08-2026 à 14:06:07  profilanswer
 

moyen_moins a écrit :


J'avoue que par feignantise, je reste avec lmsutdio mais c'est trop lent les màj (j'suis sur le canal 'stable').
J'ai pas testé un llama.cpp récent.
 
Quelqu'un se dévoue pour faire un gui bien conçu pour les feignants pour llama.cpp avec qwen 3.8 en xtra high ? :o
(ça sert à rien mais bon)


Peut-être un client Llama.cpp via Pinokio, mais assez relou à configuré: https://pinokio.co/
 
Il y a tout plein de plugins et de serveurs et de bibliothèques à installer par exemple gepeto.
 
 
https://pinokio.co/apps/github-com- [...] abs-gepeto
https://pinokio.co/apps/github-com- [...] ui-pinokio


Et des clients, par exemple genre https://antigravity.google/terms
 

n°46112
neo world
Posté le 24-08-2026 à 14:29:48  profilanswer
 

moyen_moins a écrit :


j'suis en version stable et je vois pas du tout ces trucs.
j'dois être aveugle (ou neuneu) :(


https://rehost.diberie.com/Picture/Get/f/538494
 
https://rehost.diberie.com/Picture/Get/f/538495
 
Version 0.4.21+2 (0.4.21+2) :jap:

n°46113
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 14:34:04  profilanswer
 

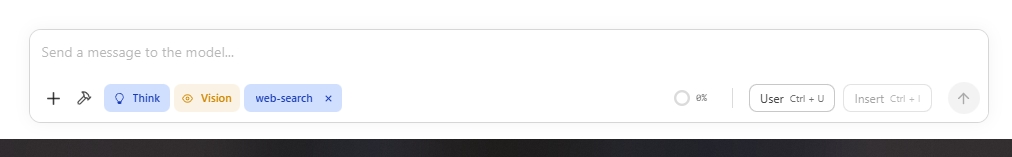
je pige pas pourquoi j'ai pas ce truc (et je suis soi disant à jour) :??:


edit: peut être parce que je n'utilise pas le model LM Studio mais un DavidAU ou unsloth ?

Message cité 1 fois
Message édité par moyen_moins le 24-08-2026 à 14:43:43
n°46114
Pipould's
Posté le 24-08-2026 à 14:40:20  profilanswer
 

the_fennec a écrit :


Non j'ai jamais commandé, j'ai trouvé ce site en tant qu'alternative a Alibaba, mais j'ai aucune commande la-bas non plus. Pour l'instant mes BC250 viennent d'Aliexpress.
 
Je pense que vu les moyens de paiement (virement, Bitcoin, etc.) c'est DTC si un truc se passe mal. A 200 balles j'aurais pris le risque, 600 probablement pas.


Je me tatte, sur alibaba t'as des vendeurs au vietnam, si les mecs livrent au vietnam, je prend un billet pour aller les chercher  :lol:

n°46115
neo world
Posté le 24-08-2026 à 14:43:08  profilanswer
 

moyen_moins a écrit :

je pige pas pourquoi j'ai pas ce truc (et je suis soi disant à jour) :??:


quelle version ?  :pt1cable:

n°46116
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 14:54:18  profilanswer
 

neo world a écrit :


quelle version ?  :pt1cable:


je regarderai ce soir, c'est la reprise aujourd'hui :'(

n°46117
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-08-2026 à 15:18:00  profilanswer
 

Pipould's a écrit :


Je me tatte, sur alibaba t'as des vendeurs au vietnam, si les mecs livrent au vietnam, je prend un billet pour aller les chercher  :lol:


Y a des vendeurs safe sur alibaba, inutile de prendre autant de risques ^^'
 
Si tu as pas trop de pognon y a des mi50 16gb a 120e HT , le deal est pas mauvais


---------------
Victime de girafophobie, mais se soigne.
n°46118
Pipould's
Posté le 24-08-2026 à 15:34:46  profilanswer
 

Tronklou a écrit :


Y a des vendeurs safe sur alibaba, inutile de prendre autant de risques ^^'
 
Si tu as pas trop de pognon y a des mi50 16gb a 120e HT , le deal est pas mauvais


L'idee serait de recycler une mobo en PCIE3.0.  
 
Donc soit NVLINK
 
Soir grosse Vram
 
Dual de 2080Ti NVLINK  
 
ou  
 
CMP 170HX

n°46119
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 15:41:55  profilanswer
 

Pipould's a écrit :

Je me tatte, sur alibaba t'as des vendeurs au vietnam, si les mecs livrent au vietnam, je prend un billet pour aller les chercher  :lol:


J'avais trouvé un vendeur en Malaisie, mais zéro avis, 100% de chances de rien recevoir.
 
Je pense que tous les vendeurs sur internet savent que les 170hx partent a plus de 1000 balles sans soucis. :(


---------------
Faudra que je teste un jour :o
n°46120
neo world
Posté le 24-08-2026 à 15:43:17  profilanswer
 

Pipould's a écrit :


Dual de 2080Ti NVLINK  


c'est possible ça ?  [:theredled]

n°46121
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 15:45:03  profilanswer
 

Tronklou a écrit :


Y a des vendeurs safe sur alibaba, inutile de prendre autant de risques ^^'
 
Si tu as pas trop de pognon y a des mi50 16gb a 120e HT , le deal est pas mauvais


16Go c'est vraiment pas assez. Mais la diff avec les modèles 32Go c'est abusé.
Et splitter le modèle, faut que la cm suive derrière.

n°46122
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 15:48:33  profilanswer
 

moyen_moins a écrit :

16Go c'est vraiment pas assez. Mais la diff avec les modèles 32Go c'est abusé.


Pas de miracle, tout le monde a le même problème :(


---------------
Faudra que je teste un jour :o
n°46123
neo world
Posté le 24-08-2026 à 15:52:50  profilanswer
 

faut prendre un Mac et absorber le cout démentiel de la (v)RAM en le noyant dans celui du renouvellement de votre poste client (mon ancien laptop "gaming" (3070ti avec le TDP max possible pour les puces mobiles) est passé au grenier mais accessible en HDMI / USB depuis la TV du salon et j'ai acheté un Mac pour la deuxième fois de ma vie (le premier c'était pour une ex il y a environ 20 ans). 3k balles quand même avec quelques pourcents de réduction chez carrefour il y a quelques mois :sweat:  
 

n°46125
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-08-2026 à 16:11:18  profilanswer
 

moyen_moins a écrit :


16Go c'est vraiment pas assez. Mais la diff avec les modèles 32Go c'est abusé.
Et splitter le modèle, faut que la cm suive derrière.


Les perfs sont pas dégueux tout de même, au ratio prix/VRAM c'est très bon dans le classement, et en perf pure c'est loin d'être les dernières aussi.
 
Pour le PCIe c'est pas absolu :
- Si tu tournes en layer, la vitesse du PCIe est assez secondaire. Il y a peu d'échanges entre les GPU, donc même du PCIe 3.0 fait largement le taf dans pas mal de cas.
- Si tu es en tensor, effectivement là ça devient primordial, vu que les GPU doivent communiquer plusieurs fois par couche. En gardant en tête que le NVLink peut être une roue de secours très intéressante. Il y a également le P2P PCIe qui peut aider, notamment avec des cartes à base de switch PLX/PEX88048, mais ça commence à coûter cher (environ 300€ la carte) et le P2P dépend aussi du GPU/driver.
 
Mais ! Sur AMD, le tensor c'est pas forcément la joie actuellement. llama.cpp le considère encore expérimental et garantit surtout les perfs sur CUDA/NVIDIA. RCCL existe côté AMD mais est même désactivé par défaut parce qu'il n'améliorait pas systématiquement les perfs. Donc pas forcément utile non plus de se saigner pour avoir du gros PCIe qui envoie du lourd.
 
Au final avec du vieux matos le choix est assez clair :
 
- soit du AMD pas cher en VRAM avec du layer
- soit du NVIDIA avec NVLink (2080 Ti 22GB bonjour)
-soit du mono-carte (CMP170HX, R9700)
 
Et ça tombe bien car c'est à peu près les seuls trucs qu'on peut encore se payer :sweat:
 
À côté de ça on peut viser une vieille plateforme pas chère en C612 pour lui balancer de la DDR3/DDR4 RDIMM. ( 100 balle la cm, 10/20e le cpu... et j'ai payé 140e les 64gb de ram )
 
Car au final le fond du problème c'est qu'avoir plein de lignes PCIe très rapides, c'est aussi partir sur une plateforme récente avec CPU/CM et surtout RAM beaucoup plus chers. Donc autant économiser cet argent et le mettre dans plus de VRAM, voire directement dans une grosse mono-carte...


---------------
Victime de girafophobie, mais se soigne.
n°46127
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 16:27:00  profilanswer
 

t'as bien résumé mes pensées du moment.
du coup j'hésite à dégager une de mes cartes 16GB (la 9060XT qui a moins de BP) et à la remplacer par une R9700pro car je suis bloqué sur ma vieille plateforme (B550 + 5900X et 96GB de DDR4) vu les prix de tarés pour de la ddr en ce moment.
mais faut sortir 1600 balles quoi (sauf si je revends la 9060XT) :/

n°46128
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-08-2026 à 16:48:43  profilanswer
 

Ta plateforme est déjà plus que correcte !
 
À ta place je regarderais surtout une CM AM4 avec plus de PCIe dispo, histoire de garder ton 5900X et surtout tes 96GB de DDR4, puis je compléterais ta 9060XT avec une deuxième.
 
si tu fais les comptes :
Revente 9060XT (400€) + achat R9700 : 1600 - 400 = 1200€ pour 32GB sur une seule carte.
Achat d'une deuxième 9060XT (500€) + CM correcte (120€) : 620€ pour 2×16GB.
Idem mais avec un petit GPU dédié à Windows pour laisser les deux 9060XT tranquilles : 650/700€
Et si tu veux vraiment faire le foufou :O : troisième 9060XT + éventuellement nouvelle alim : on arrive dans les 1200/1300€, mais avec 48GB de VRAM.
 
Et après la dernière option :
 
Revendre ta 9060xt qui a peu de BP (400€) et tu rachète cm (120€) + 2x6800 (600€) = 320€ d'upgrade pour avoir 2x16gb  
 
Après oui la R9700 restera nettement plus rapide en génération avec ses 640GB/s et surtout sans les emmerdes du multi-GPU.
 
Mais niveau prix/VRAM, ça fait quand même sacrément mal la R9700.


---------------
Victime de girafophobie, mais se soigne.
n°46129
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 17:03:41  profilanswer
 

j'ai déjà testé 3 GPU sur ma cm : 9070XT en pcie4 16x, 9060XT en pcie3 2X (il me semble) et une RX6700 (10Go) en pcie3 1X.
obligé d'utiliser des risers/extensions PCIE car la 9070XT est une putain d'armoire dans la tour...
franchement, c'était pas foufou niveau perf (et avec 42GO de VRAM, je testais du q8 pour me faire plaisir [:joce]) et y'a tout qui pendouillait, c'est pour ça que je suis moyen chaud pour 3 cartes :(
(et en plus, je viens de changer l'alim pour une 1000W platinum)
 
edit: tout ça pour bricoler, faire des tests et des conneries de rien du tout avec l'IA... [:mister yoda]


Message édité par moyen_moins le 24-08-2026 à 17:07:26
n°46130
neo world
Posté le 24-08-2026 à 17:09:09  profilanswer
 

Mac mini avec 48GB de ddr5 + 1 to : 2889
 
Pas besoin de sources de composants, pas de sujets sur la consommation ou le WAF non plus
 
Autrement pour 2500€ y’a le strix halo et ses 128go.
 
Ça souffle un peu mais pas tant :o

n°46131
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-08-2026 à 17:10:52  profilanswer
 

Non mais là tu force aussi  :D


---------------
Victime de girafophobie, mais se soigne.
n°46132
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 17:11:38  profilanswer
 

le mac mini est plus perf non ?

n°46144
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 18:15:43  profilanswer
 

neo world a écrit :


quelle version ?  :pt1cable:


LM Studio 0.4.21 (Build 2)
https://rehost.diberie.com/Picture/Get/f/538556

n°46149
neo world
Posté le 24-08-2026 à 18:40:38  profilanswer
 

Réinstaller ? C’est peut être pas disponible sur windows mais je n’ai pas d’explication logique qui me vient :pt1cable:

n°46150
moyen_moin​s
chat réincarné
Posté le 24-08-2026 à 19:14:26  profilanswer
 

avec le template jinja corrigé, par défaut il est en medium mais si je mets <|think_xhigh|> en début de message, il passe en mode je réfléchis pour gagner le prix nobel :o
un peu relou mais suffit que j'oublie pas.

n°46155
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 19:43:55  profilanswer
 

Faut peut être acheter l'option pro?
:o


---------------
Faudra que je teste un jour :o
n°46157
neo world
Posté le 24-08-2026 à 19:49:15  profilanswer
 

Tronklou a écrit :

Non mais là tu force aussi  :D


 [:gidoin]  C'est une fois tous les 30 ans qu'Apple est vaguement compétitif dans ses prix. Faut pas louper le créneau :o

n°46169
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 20:38:17  profilanswer
 

Qwen 3.8 27B Quantizations Q1 - Q8 compared
Luke's Dev Lab
https://www.youtube.com/watch?v=WNMnbba35VI
 
Il teste la création d'une board Kanban, une lampe sous Blender et un un jeu dans Godot!
TL;DR: Q2 est viable en code, Blender/Godot Q4 au moins.


---------------
Faudra que je teste un jour :o
 Page :   1  2  3  4  5  ..  42  43  44  ..  60  61  62  63  64  65

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)