Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4187 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  40  41  42  ..  61  62  63  64  65  66
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°45838
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 20-08-2026 à 20:41:44  profilanswer
 

Reprise du message précédent :
Bravo pour ta pugnacité et merci pour le petit reportage, c'est ce genre de config de type Frankenstein qui donne envie de se lancer avec ses propres moyens :D


---------------
Victime de girafophobie, mais se soigne.
n°45839
the_fennec
f3nn3cUs z3rd4
Posté le 20-08-2026 à 20:59:05  profilanswer
 

Pipould's a écrit :

J'ai une possibilité de prendre une cmp170hx pour 1650 balles mais je trouve que ça vaut pas le coup vu le risque a lunlock :(


une 8GB -> 64GB  ou 10GB -> 40GB?
 
Elles sont moins chères sur allibaba je pense, mais ça reste dans les 1200, perso je prendrais pas la risque.
 

moyen_moins a écrit :

le Q6 sur le 3.8 27B, c'est limite 32Go pour le contexte.
j'ai pris la version atomicchat (24.15Go) et en q8/q5_1, j'accroche péniblement les 64k de contexte


T'es sous Windows ou Linux?


---------------
Faudra que je teste un jour :o
n°45841
the_fennec
f3nn3cUs z3rd4
Posté le 20-08-2026 à 21:13:26  profilanswer
 

epsiloncentaury a écrit :

Petit retour d’expérience sur un montage IA local  improbable.
 
...
Quelque temps plus tard, je suis tombé sur une vidéo d’un gars qui disait réussir à faire tourner Qwen 35B sur une GTX 1060.  :??:  


Je parie que c'est une vidéo de Codacus :D  
 

epsiloncentaury a écrit :


Puisque llama.cpp permettait des réglages beaucoup plus fins, je me suis dit qu’il fallait retenter l’expérience qui avait échoué sous LM Studio. Avec l’aide de l’IA, j’ai compilé une version de llama.cpp avec deux backends différents dans la même build :
 
GTX 1650 4 Go : CUDA
RX 5600 XT 6 Go : Vulkan


Perso je suis un fainéant, je prends directement les builds Vulkan, même pour ma RTX:
https://github.com/ggml-org/llama.cpp/releases
 
J'ai l'impression que c'est plus stable, mais surtout j'ai plus a m’embêter avec les versions de CUDA.
 

epsiloncentaury a écrit :


Je ne pensais franchement pas arriver à ça avec cette machine quand j’ai commencé.   :D


Et bien félicitations :jap: pour quelqu'un qui dit ne pas s'y connaître, c'est un sacré boulot, mais en s'aidant d'une IA!


Message édité par the_fennec le 20-08-2026 à 21:14:01

---------------
Faudra que je teste un jour :o
n°45844
lapin
Posté le 20-08-2026 à 21:17:51  profilanswer
 

De mon coté, ça n'est pas ça:
 

Citation :


<svg width="500" height="500" viewBox="0 0 500 500" xmlns="http://www.w3.org/2000/svg">
  <!-- Fond blanc -->
  <rect width="100%" height="100%" fill="white" />
 
  <!-- Groupes des lignes -->
  <g stroke="black" stroke-width="2" fill="none">
    <!-- Ligne de gauche (A-D-G) -->
    <line x1="100" y1="50" x2="100" y2="450" />
     
    <!-- Ligne de droite (B-C) -->
    <line x1="400" y1="150" x2="400" y2="450" />
     
    <!-- Ligne horizontale supérieure (A-E-B) -->
    <line x1="100" y1="50" x2="400" y2="150" />
     
    <!-- Ligne horizontale médiane (D-H-E) -->
    <line x1="100" y1="250" x2="400" y2="250" />
     
    <!-- Ligne horizontale inférieure (G-F-C) -->
    <line x1="100" y1="450" x2="400" y2="450" />
     
    <!-- Ligne verticale centrale (E-H-F) -->
    <line x1="250" y1="100" x2="250" y2="450" />
     
    <!-- Correction pour correspondre exactement au tracé de l'image -->
    <!-- On redessine les segments pour la structure spécifique de l'image -->
    <line x1="100" y1="50" x2="400" y2="150" /> <!-- AB -->
    <line x1="400" y1="150" x2="400" y2="450" /> <!-- BC -->
    <line x1="400" y1="450" x2="100" y2="450" /> <!-- CG -->
    <line x1="100" y1="450" x2="100" y2="50" />  <!-- DA -->
    <line x1="100" y1="250" x2="400" y2="250" /> <!-- DE -->
    <line x1="250" y1="100" x2="250" y2="450" /> <!-- EF -->
  </g>
 
  <!-- Labels des points -->
  <g font-family="Arial, sans-serif" font-size="18" font-weight="bold">
    <text x="85" y="55">A</text>
    <text x="405" y="155">B</text>
    <text x="405" y="465">C</text>
    <text x="85" y="265">D</text>
    <text x="240" y="100">E</text>
    <text x="240" y="465">F</text>
    <text x="85" y="475">G</text>
    <text x="255" y="265">H</text>
  </g>
</svg>


 [:jblover]  [:fez666]  
 

Citation :


<svg width="500" height="500" viewBox="0 0 500 500" xmlns="http://www.w3.org/2000/svg">
  <!-- Fond blanc -->
  <rect width="100%" height="100%" fill="white" />
 
  <!-- Groupes des lignes -->
  <g stroke="black" stroke-width="2" fill="none">
    <!-- Parallélogramme extérieur A-B-C-D -->
    <!-- Segment AB (haut) -->
    <line x1="50" y1="50" x2="450" y2="150" />
    <!-- Segment BC (droite) -->
    <line x1="450" y1="150" x2="450" y2="450" />
    <!-- Segment CD (bas) -->
    <line x1="450" y1="450" x2="50" y2="350" />
    <!-- Segment DA (gauche) -->
    <line x1="50" y1="350" x2="50" y2="50" />
 
    <!-- Ligne médiane D-E-B (en réalité D-E et E-B sur l'image) -->
    <line x1="50" y1="250" x2="450" y2="250" />
 
    <!-- Ligne verticale centrale E-F -->
    <line x1="250" y1="150" x2="250" y2="450" />
 
    <!-- Ligne de base G-F-C -->
    <!-- Segment GF -->
    <line x1="50" y1="450" x2="250" y2="450" />
    <!-- Segment FC (la partie droite de la base) -->
    <line x1="250" y1="450" x2="450" y2="450" />
  </g>
 
  <!-- Labels des points -->
  <g font-family="Arial, sans-serif" font-size="20" font-weight="bold">
    <text x="35" y="45">A</text>
    <text x="460" y="145">B</text>
    <text x="460" y="465">C</text>
    <text x="35" y="365">D</text>
    <text x="40" y="245">G</text>
    <text x="240" y="145">E</text>
    <text x="240" y="465">F</text>
    <text x="260" y="260">H</text>
  </g>
</svg>


Citation :


<svg width="500" height="400" viewBox="0 0 500 400" xmlns="http://www.w3.org/2000/svg">
  <!-- Fond blanc -->
  <rect width="100%" height="100%" fill="white"/>
   
  <!-- Groupe des lignes -->
  <g stroke="black" stroke-width="2" fill="none">
    <!-- Parallélogramme ABCD -->
    <!-- A=(100,50), B=(400,100), C=(350,300), D=(50,250) -->
    <line x1="100" y1="50" x2="400" y2="100" /> <!-- AB -->
    <line x1="400" y1="100" x2="350" y2="300" /> <!-- BC -->
    <line x1="350" y1="300" x2="50" y2="250" /> <!-- CD -->
    <line x1="50" y1="250" x2="100" y2="50" /> <!-- DA -->
     
    <!-- Ligne verticale EF -->
    <line x1="200" y1="75" x2="200" y2="275" /> <!-- EF -->
     
    <!-- Ligne horizontale passant par D et C (ou médiane) -->
    <!-- Ajustée pour correspondre à la perspective de l'image -->
    <line x1="50" y1="250" x2="350" y2="250" />  
     
    <!-- Ligne de base prolongée vers G -->
    <line x1="50" y1="250" x2="0" y2="275" /> <!-- Prolongement vers G -->
  </g>
 
  <!-- Groupe des étiquettes (Points) -->
  <g font-family="Arial, sans-serif" font-size="18" font-weight="bold">
    <text x="90" y="45">A</text>
    <text x="405" y="95">B</text>
    <text x="355" y="320">C</text>
    <text x="40" y="265">D</text>
    <text x="195" y="70">E</text>
    <text x="195" y="285">F</text>
    <text x="25" y="260">G</text>
    <text x="205" y="230">H</text>
  </g>
</svg>


C'est peut-être de l'art, mais le petit google/gemma-4-12b-qat ira quand même en SES au collège l'année prochaine !!!!

n°45847
neo world
Posté le 20-08-2026 à 21:44:59  profilanswer
 

epsiloncentaury a écrit :

Petit retour d’expérience sur un montage IA local  improbable.  


 bienvenue et bravo ! [:implosion du tibia]  
 
Les interventions sur ce topic me rappelle l'informatique dans les années 90/début 2000 : ça intéresse beaucoup de monde mais c'est encore vachement artisanal. A la limite entre la centrale nucléaire et la magie noire ( :o ). Ca nous change de l'aseptisé "j'ai branché une prise. Ca marche. Je vais regarder/faire un foot avec les copains maintenant" :o

Message cité 1 fois
Message édité par neo world le 20-08-2026 à 21:45:27
n°45848
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 20-08-2026 à 21:55:10  profilanswer
 

Rendez moi le debut du watercooling avec jacky pc :O
 
Mes radiateurs de clio 2, mes tubes d'aquarium avec la pompe 220v.
Les waterblock grattés contre des bières aux éleves apprentis tourneurs fraiseurs du lycée d'a coté.
Les heures de débat entre high flow et low flow  
 
[:fedefail:4]


---------------
Victime de girafophobie, mais se soigne.
n°45849
lapin
Posté le 20-08-2026 à 21:59:30  profilanswer
 

neo world a écrit :


 bienvenue et bravo ! [:implosion du tibia]  
 
Les interventions sur ce topic me rappelle l'informatique dans les années 90/début 2000 : ça intéresse beaucoup de monde mais c'est encore vachement artisanal. A la limite entre la centrale nucléaire et la magie noire ( :o ). Ca nous change de l'aseptisé "j'ai branché une prise. Ca marche. Je vais regarder/faire un foot avec les copains maintenant" :o


En même temps avec des applications en version 0.4.21(Build 2) et moteur Llama.cpp en version V2.28.2, donc tu m'étonnes qu'on en est au tout début des IA sur LLM locaux !!!

n°45850
Big Blue
Live/Psn/Nid legeantbleu
Posté le 20-08-2026 à 22:14:16  profilanswer
 

Tronklou a écrit :

Rendez moi le debut du watercooling avec jacky pc :O
 
Mes radiateurs de clio 2, mes tubes d'aquarium avec la pompe 220v.
Les waterblock grattés contre des bières aux éleves apprentis tourneurs fraiseurs du lycée d'a coté.
Les heures de débat entre high flow et low flow  
 
[:fedefail:4]


Twingo ici :D

n°45851
neo world
Posté le 20-08-2026 à 22:18:59  profilanswer
 

Tout ça pour gagner combien de MHz ? :o

n°45854
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 20-08-2026 à 22:36:06  profilanswer
 

Nous on faisait ça pour la gloire, le sport, le vrai, dans toute sa beautés innocente :O  
Et aussi parce qu’on avait pas un rond :D  
 
De base je voulais juste ne plus mourir avec le bruit de sèche cheveux de mon pc :D


---------------
Victime de girafophobie, mais se soigne.
n°45862
moyen_moin​s
chat réincarné
Posté le 21-08-2026 à 00:09:02  profilanswer
 

the_fennec a écrit :


une 8GB -> 64GB  ou 10GB -> 40GB?


Elles sont moins chères sur allibaba je pense, mais ça reste dans les 1200, perso je prendrais pas la risque.


the_fennec a écrit :


T'es sous Windows ou Linux?


Windows win10.
Quand faudra passer sous win11 peut être je lâcherais complètement cet OS pourri.

n°45867
the_fennec
f3nn3cUs z3rd4
Posté le 21-08-2026 à 08:30:54  profilanswer
 

moyen_moins a écrit :


Windows win10.
Quand faudra passer sous win11 peut être je lâcherais complètement cet OS pourri.


Fait attention aux apps qui tournent et utilisent le GPU et gaspillent de la VRAM. Sur mon Win Server 2019 j'ai désactivé le hardware rendering de Firefox et viré certaines applis du systray aussi. Tu peux voir quelles applis utilisent de la VRAM avec System Informer par exemple.

Message cité 1 fois
Message édité par the_fennec le 21-08-2026 à 08:31:30

---------------
Faudra que je teste un jour :o
n°45872
Pipould's
Posté le 21-08-2026 à 09:16:17  profilanswer
 

Citation :


C'est peut-être de l'art, mais le petit google/gemma-4-12b-qat ira quand même en SES au collège l'année prochaine !!!!


lapin, toujours premier sur les bonnes carottes  :love:

n°45878
moyen_moin​s
chat réincarné
Posté le 21-08-2026 à 10:29:28  profilanswer
 

the_fennec a écrit :


Fait attention aux apps qui tournent et utilisent le GPU et gaspillent de la VRAM. Sur mon Win Server 2019 j'ai désactivé le hardware rendering de Firefox et viré certaines applis du systray aussi. Tu peux voir quelles applis utilisent de la VRAM avec System Informer par exemple.


J'ai toujours 2-3Go de pris à rien faire dans le task manager.
Faut que je regarde cette histoire effectivement.
C'est pour ça que j'ai du mal à aller gratter les 30Go sur les 2 cartes :jap:

n°45943
lapin
Posté le 22-08-2026 à 10:27:25  profilanswer
 

Dans LM STUDIO dans Runtime à Engine & Framework, CPU llama.cpp (Windows) CPU-only llama.cpp engin vient de passer en version v2.29.1.
 
Bon c'est du llama.cpp en version CPU-Only donc très très lent, à comparer à Llama.cpp version CUDA ou Vulkan ou ROCm.
 

n°45954
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 12:32:49  profilanswer
 

Cette version n'a rien a voir avec la vrai version de llama.cpp qui est actuellement de b10581 en pre-release ou 0.2.0 en release.


---------------
Faudra que je teste un jour :o
n°45955
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 12:37:39  profilanswer
 

Infatigable Qwen 3.8 et Claude-code:
https://i.imgur.com/rC1fTuL.png
 
Et j'utilise aussi le template de froggeric:
https://huggingface.co/froggeric/Qw [...] -Templates


---------------
Faudra que je teste un jour :o
n°45961
XaTriX
Posté le 22-08-2026 à 13:39:08  profilanswer
 

et ça vaut quoi face à des models frontiers ?
 
ah aussi pourquoi cc en harness ? :o


---------------
[:dawa]
n°45962
yohaskan
Posté le 22-08-2026 à 13:56:06  profilanswer
 

J'ai fini mon opti. :bounce:  
Et après un test de session de jeu pendant un stream de 2 heures, on peut mesure la latence TTFA (Time to First Audio)
Elle répond en moyenne sous les 4s en conversation simple (Generation LLM+ Generation TTS)
 
Y'a 3 ans elle répondait sur Skyrim en 45 seconde...  
Quasiment un X10... (bon j'étais en VR aussi)  
 

Code :
  1. ## 2. TTFA par type d'outil
  2. ```
  3. ┌──────────────────────────────────────────┬─────┬─────────┬─────────┬────────┬─────────┬─────────┐
  4. │ Type d'échange                           │   n │ moyenne │ médiane │    min │     p90 │     max │
  5. ├──────────────────────────────────────────┼─────┼─────────┼─────────┼────────┼─────────┼─────────┤
  6. │ Global (tous confondus)                  │ 105 │  5,23 s │  4,56 s │ 0,09 s │  8,04 s │ 13,82 s │
  7. │ conversation (discussion simple)         │  41 │  3,42 s │  3,49 s │ 0,09 s │  4,50 s │  5,55 s │
  8. │ search_wiki (recherche wiki)             │  18 │  6,06 s │  5,99 s │ 1,07 s │  9,41 s │ 10,61 s │
  9. │ analyze_screen (regarde l'écran)         │  22 │  7,21 s │  6,69 s │ 5,39 s │  8,50 s │ 13,58 s │
  10. │ analyze_visual_memory (mémoire visuelle) │  13 │  8,26 s │  7,33 s │ 6,32 s │ 11,83 s │ 13,82 s │
  11. │ store_memory                             │   6 │  3,98 s │  3,83 s │ 3,46 s │  4,63 s │  4,71 s │
  12. │ search_memory                            │   1 │  3,67 s │  3,67 s │ 3,67 s │  3,67 s │  3,67 s │
  13. └──────────────────────────────────────────┴─────┴─────────┴─────────┴────────┴─────────┴─────────┘
  14. ```
  15. ## 2bis. Distribution des TTFA (global, n=105)
  16. Chaque ligne = une tranche de durée ; **nb d'échanges** = nombre d'échanges dont le
  17. TTFA tombe dans cette tranche (la barre est proportionnelle à ce nombre).
  18. ```
  19. Tranche distribution                     nb d'échanges
  20. 00-03s  ████████████                              16   ← très réactif
  21. 03-05s  ██████████████████████████████            39   ← le pic : la grande majorité
  22. 05-07s  ████████████████████                      26
  23. 07-09s  █████████████                             17
  24. 09-12s  ███                                        4
  25. 12-15s  ██                                         3
  26. >=15s                                              0
  27. ```


L'opti du code a été refaite avec Qwen3.8 27B, et pour la session de stream, j'utilise un gemma 4 12B plus simple (pas besoin de coder) juste d'etre rapide et de choisir le bon outil
 
Un extrait de la consol CHESIREAI 2.0 est ici (le reste, c'est les 2 heures de stream du jeu... c'est secondaire...)
https://youtube.com/shorts/nm1e77ry5nw?feature=share
 
PS: Je rapelle que tout est local sur le même PC

n°45964
Big Blue
Live/Psn/Nid legeantbleu
Posté le 22-08-2026 à 15:58:30  profilanswer
 

neo world a écrit :

Tout ça pour gagner combien de MHz ? :o


Pour le silence, noctua n’existait pas à l’époque :o
 
C’était extrêmement silencieux une fois que le réservoir d’eau au dessus de la carte mère, en plexi fait maison, avait explosé :o


Message édité par Big Blue le 22-08-2026 à 16:01:44
n°45965
Big Blue
Live/Psn/Nid legeantbleu
Posté le 22-08-2026 à 15:59:44  profilanswer
 

Je suis en pleine tentative d’installation de ornith 1.5 A3B, bon pas en Q4 apparemment, peut être en Q2 XS ( en version libre libre :o ).


Faut pas que ca fonctionne trop bien, y’a des bc-250 pas trop cher :o


Message édité par Big Blue le 22-08-2026 à 16:02:04
n°45969
moyen_moin​s
chat réincarné
Posté le 22-08-2026 à 17:34:14  profilanswer
 

les modèles récents 12B-14B, à part gemma 4, il y a pas non ?
ça vaut quoi les LFM 2.5 ?

Message cité 1 fois
Message édité par moyen_moins le 22-08-2026 à 17:34:38
n°45970
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 18:13:21  profilanswer
 

XaTriX a écrit :

et ça vaut quoi face à des models frontiers ?
 
ah aussi pourquoi cc en harness ? :o


Qwen 27B est très fort, mais très lent aussi. Les benchs le donnent au niveau d'Opus 4.6, même si j'ai un peu de mal a y croire. En tout cas il avance bien sur mon projet alacon.
 
Je reviens régulièrement sur CC, car tous les autres finissent par partir en couille sur mes prompts (qui sont longs :o ).
 
Opencode est fini a la pisse et déconne souvent, genre il s'arrête sans raison. Quelques post plus haut j'ai linké un bug, si le modèle contient "qwen" il force le top_p a 1 [:wisi gaud:5]. Je comprends mieux mes boucles, problème de tooling ou les stop...
Pi est trop limité, OK il faut mettre/faire des plugins, mais il devient ensuite trop sensible aux changement de modèles.
Little-coder est trop directif et vibe-codé. Ses interruptions de thinking font plus de mal qu'autre chose. En plus il gère mal le contexte. Je l'ai configuré pour compacter a 80% de 256K, une fois sur deux, llama.cpp l'envoie bouler car il ajoute des trucs pour la compaction et dépasse les 256K alors qu'il lui reste 50K... Je suis obligé de clear le contexte et repartir a zéro.
Codex marchait pas bien avec llama.cpp, il finissait par avoir des erreurs 500 et s'est auto-détruit quand je lui ait dit de régler le problème.
open-claw déconne a plein tube, ne peut pas marcher avec du local, du frontier non plus d'ailleurs.
Hermess bouffe trop de contexte pour sa propre config, il reste rien pour bosser avec sur des trucs sérieux.
 
Il y a trois types de harness:
- ceux qui ne marchent que parce que le modèle derrière est balaise et est capable de tout rattraper (OClaw, Hermes)
- les bouses vibe-codées tout juste bonnes a faire un post Reddit ou une vidéo YT (OCode, Pi, LC)
- ceux ou des gens sont payer pour en faire le dev, comme CC ou codex.


---------------
Faudra que je teste un jour :o
n°45974
XaTriX
Posté le 22-08-2026 à 19:27:53  profilanswer
 

Opencode2 t'as pas test ? :o


---------------
[:dawa]
n°45975
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 19:56:58  profilanswer
 

moyen_moins a écrit :

les modèles récents 12B-14B, à part gemma 4, il y a pas non ?
ça vaut quoi les LFM 2.5 ?


Ya Ling tiny 8B A1B, mais c'est plus petit, j'ai pas testé. Je trouve intéressant un MoE aussi petit  [:perco_35:2]


---------------
Faudra que je teste un jour :o
n°45976
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 20:03:13  profilanswer
 

XaTriX a écrit :

Opencode2 t'as pas test ? :o


Non, c'est prévu, mais pas motivé.
 
Comme derrière ils vendent du Cloud il n'ont aucun intérêt a ce que le local marche bien...
 
J'ai qwen-code dans ma liste aussi.


Message édité par the_fennec le 22-08-2026 à 20:03:41

---------------
Faudra que je teste un jour :o
n°45977
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 22-08-2026 à 21:39:10  profilanswer
 

Très content d'open code 2 perso, j'ai tout viré et migré dessus.  
Apres je l'utilise pas en petit model donc pour du local je sais pas du tout


---------------
Victime de girafophobie, mais se soigne.
n°45978
totosssfr
Pousse-testa
Posté le 22-08-2026 à 21:48:15  profilanswer
 

the_fennec a écrit :

Infatigable Qwen 3.8 et Claude-code:
https://i.imgur.com/rC1fTuL.png
 
Et j'utilise aussi le template de froggeric:
https://huggingface.co/froggeric/Qw [...] -Templates


Merci pour le template, faut que je teste. :jap:  
 

yohaskan a écrit :

J'ai fini mon opti. :bounce:  
...
 
Un extrait de la consol CHESIREAI 2.0 est ici (le reste, c'est les 2 heures de stream du jeu... c'est secondaire...)
https://youtube.com/shorts/nm1e77ry5nw?feature=share
 
PS: Je rapelle que tout est local sur le même PC


Beau projet !
 
 
De mon coté, je suis passé de llm-scaler-vllm 0.21.b3 (fork vllm maintenu par intel) à vllm-openai-xpu 0.27.1.  
Contrairement à llm-scaler-vllm, vllm-openai-xpu est une version up to date du projet principal.
J'obtiens les mêmes performances sur les deux (20tg/s avec les options les plus efficaces).
 
J'utilise entre autre VLLM_XPU_ENABLE_XPU_GRAPH=1.  
Avec cette option, je passe de 17tg/s à 20tg/s mais ça consomme presque 2 Go de Vram supplémentaire et, actuellement, l'option est incompatible multi GPU.
Je vérifierai ça la semaine prochaine quand la seconde arc B60 sera arrivée.
 
En parlant de harness, j'ai vu passer Deepseek Harness. Quelqu'un a testé?


n°45979
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 22:07:12  profilanswer
 

totosssfr a écrit :


En parlant de harness, j'ai vu passer Deepseek Harness. Quelqu'un a testé?


Pas testé encore, intéressé par des retours :o


---------------
Faudra que je teste un jour :o
n°45980
the_fennec
f3nn3cUs z3rd4
Posté le 22-08-2026 à 22:07:45  profilanswer
 

Tronklou a écrit :

Très content d'open code 2 perso, j'ai tout viré et migré dessus.  
Apres je l'utilise pas en petit model donc pour du local je sais pas du tout


 :jap: t'en fais quoi?


---------------
Faudra que je teste un jour :o
n°45982
neo world
Posté le 22-08-2026 à 23:23:52  profilanswer
 

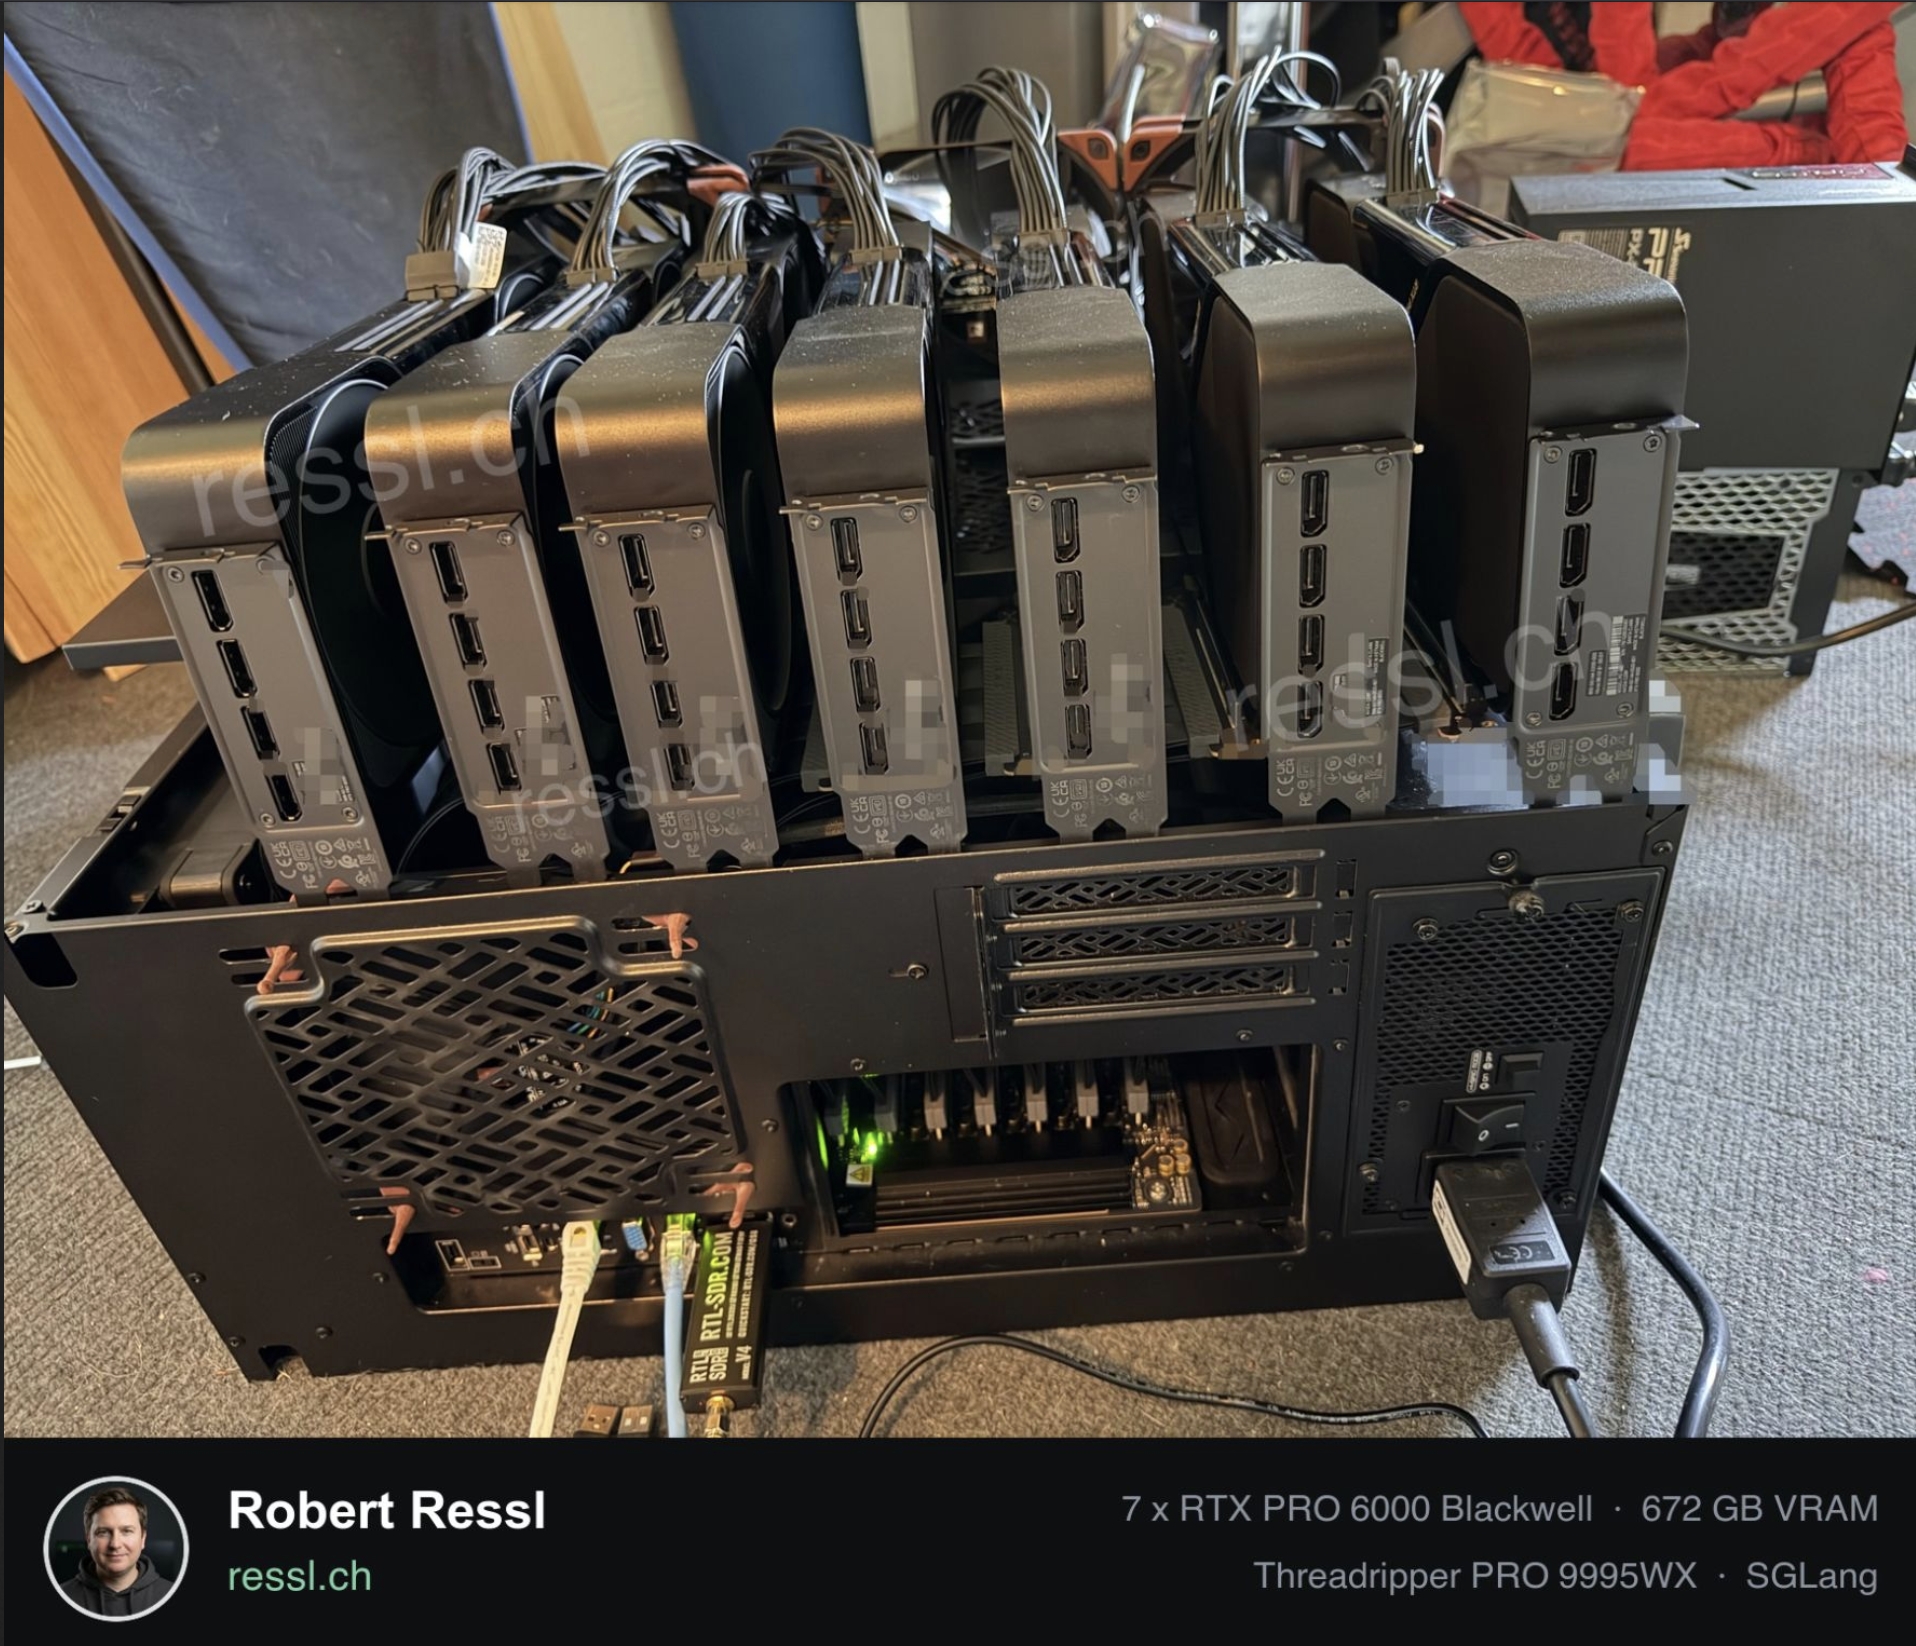
Pour ceux qui hésitent à s'équiper parce que "personne n'est assez fou pour ..." On sera toujours le petit joueur de quelqu'un :o
 
https://rehost.diberie.com/Picture/Get/f/538197

n°45983
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 07:54:48  profilanswer
 

Bon finalement, les test de ornith 1.5 sur la bc-250.  
 
Le modèle tourne en IQ2_XS sans vision, 100 tok/s :jap:
 
À voir à l’usage, pour l’instant j’ai la version uncensored ( bof ) a voir avec la version de base :jap:

n°45986
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 08:50:03  profilanswer
 

neo world a écrit :

Pour ceux qui hésitent à s'équiper parce que "personne n'est assez fou pour ..." On sera toujours le petit joueur de quelqu'un :o
 
https://rehost.diberie.com/Picture/Get/f/538197


Ouais, enfin c'est un "pro"... enfin il semble faire du conseil IA d’après son site.  
 

Big Blue a écrit :

Bon finalement, les test de ornith 1.5 sur la bc-250.  
 
Le modèle tourne en IQ2_XS sans vision, 100 tok/s :jap:
 
À voir à l’usage, pour l’instant j’ai la version uncensored ( bof ) a voir avec la version de base :jap:


Pas mal pour la vitesse!
T'as mis quoi comme Linux?
Tu peux utiliser amdgpu_top pour voir l'utilisation VRAM.


---------------
Faudra que je teste un jour :o
n°45991
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 10:20:47  profilanswer
 

C’est pas opti du tout niveau systeme, c’est pour voir si l’achat d’un deuxième bc250 vaut le coût :o  
 
C’est sur steamOS :D  
 

Citation :

GGUF installés
 
- Ornith normal — ornith-normal.gguf  
  11 406 040 544 octets — 10,62 Gio  
  Source : vcruz305/Ornith-1.5-35B-A3B-GGUF
 
- Ornith CRACK — ornith-crack.gguf  
  11 406 040 672 octets — 10,62 Gio  
  Fabriqué depuis le Q8 CRACK avec imatrix agentique/code fusionnée, blk.40.* conservés en Q8.
 
Performances
 
- Normal : ≈96,8 tok/s
- CRACK : ≈95,4 tok/s
- Test direct CRACK llama.cpp : réponse non vide, sans refus détecté.
 
Mémoire
 
- Normal
  - VRAM : 7,841 / 8 Gio
  - GTT : 4,258 / 12 Gio
  - Service : 1,964 Gio, pic 3,173 Gio
 
- CRACK
  - VRAM : 7,841 / 8 Gio
  - GTT : 4,262 / 12 Gio
  - Service : 2,024 Gio, pic 3,210 Gio
 
État final
 
- ornith-normal actif sur 192.168.1.99:8080
- Un seul llama-server
- Contexte 131072
- Vulkan/RADV, Vulkan0
- KV Q8_0
- Pas de mmproj/vision
- MTP/speculative désactivé
 

n°45992
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 10:28:55  profilanswer
 

T'es par en VRAM auto?
Sur ma Debian j'arrive a utiliser 14GB, voire 15GB mais c'est difficile de prévoir exactement a cause des buffers. Je table sur 14GB de VRAM dans mes calculs.


---------------
Faudra que je teste un jour :o
n°45993
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 10:42:44  profilanswer
 

Non, c’est la config proposé par les toolkit steamOS pour la bc250.


Ca demande de l’opti, pour l’instant je test le modèle sur Hermes, ca tombe bien, je viens de bouffer en 24h 30€ de crédit gpt sur mon compte plus :o

Message cité 2 fois
Message édité par Big Blue le 23-08-2026 à 10:45:39
n°45994
Pipould's
Posté le 23-08-2026 à 10:45:22  profilanswer
 

Big Blue a écrit :

Non, c’est la config auto proposé par les toolkit steamOS pour la bc250.


Ca demande de l’opti, pour l’instant je test le modèle sur Hermes, ca tombe bien, je viens de bouffer en 24h 30 de crédit gpt sur mon compte plus :o


Tu fais tourner 1 bc ou 2 bc ?

n°45995
Pipould's
Posté le 23-08-2026 à 11:08:21  profilanswer
 

the_fennec a écrit :


une 8GB -> 64GB  ou 10GB -> 40GB?


Elles sont moins chères sur allibaba je pense, mais ça reste dans les 1200, perso je prendrais pas la risque.


Clairement... 400 balles pour le risque, ok, 1600 de Chine... Bof

n°45996
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 11:30:25  profilanswer
 

Pipould's a écrit :


Tu fais tourner 1 bc ou 2 bc ?


Une seule, j’utilise celle pour steamOS :jap:  
 
Je suis étonné, le modèle est vraiment à l’aise avec Hermes, les appels d’outils fonctionnent parfaitement, à voir s’il ne fait pas de la merde :jap:

n°45997
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 11:46:33  profilanswer
 

Big Blue a écrit :

Non, c’est la config proposé par les toolkit steamOS pour la bc250.  
 
Ca demande de l’opti, pour l’instant je test le modèle sur Hermes, ca tombe bien, je viens de bouffer en 24h 30€ de crédit gpt sur mon compte plus :o


Avant la doc bc250 disait de régler ça dans le BIOS, mais c'est plus le cas:
https://elektricm.github.io/amd-bc250-docs/bios/vram/
 

Citation :

It is commonly stated that 512MB VRAM split is a "dynamic allocation" mode, where the system will automatically reassign RAM to the VRAM pool as needed, but then will return that VRAM back to RAM when the game is closed.
 
In truth, ALL VRAM split settings are dynamic! There is nothing special about the 512MB mode except that it has a very small MINIMUM VRAM allocation.


Donc ta config est bonne :D


---------------
Faudra que je teste un jour :o
n°45998
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 11:49:05  profilanswer
 

Pipould's a écrit :


Clairement... 400 balles pour le risque, ok, 1600 de Chine... Bof


J'avais trouvé un listing a $600 sur globalsources.com, mais sans surprise:
 

Citation :


About the USED CMP 170HX 8GB, let me share you the detail.
 
USED CMP 170HX  8Gb: 1309USD
DHL shipping cost : 65USD
Grand total is 1309+65=1374USD
...
yes, the price on the page was about 660USD, as the demand of this GPU card is soaring and the supply is limited, so the price is higher than the price i show on the page, sorry for not updating the price in time and makes you in trouble.  


---------------
Faudra que je teste un jour :o
 Page :   1  2  3  4  5  ..  40  41  42  ..  61  62  63  64  65  66

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)