Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3720 connectés 


Gorgon Halo ...
Sondage à 2 choix possibles.


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  95  96  97  98  99  100
Page Suivante
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°55903
neo world
Posté le 07-11-2026 à 06:08:52  profilanswer
 

Reprise du message précédent :
Hy4 qui a l’air très prometteur dans le tier GLM / Deepseek / Kimi :
https://hy.tencent.ai/research/hy4?langVersion=en
 
Pas encore de date de disponibilité des open weights mais c’est annoncé :)

n°55904
neo world
Posté le 07-11-2026 à 06:09:39  profilanswer
 

moyen_moins a écrit :


iq3_s gsq-rco :)
mais je trouve qu'il jacte beaucoup pour un résultat pas ouf.
et pour l'instant le iq4_xs, c'est moins de token à générer pour "rien" mais le résultat est bof sur mon 1er test.
 
edit: par contre, j'ai l'impression qu'il chie moins de "tool calling", de ce côté là, c'est franchement mieux.


 :jap:

n°55908
the_fennec
f3nn3cUs z3rd4
Posté le 07-11-2026 à 09:07:41  profilanswer
 

moyen_moins a écrit :


iq3_s gsq-rco :)
mais je trouve qu'il jacte beaucoup pour un résultat pas ouf.
et pour l'instant le iq4_xs, c'est moins de token à générer pour "rien" mais le résultat est bof sur mon 1er test.
 
edit: par contre, j'ai l'impression qu'il chie moins de "tool calling", de ce côté là, c'est franchement mieux.


Avec Strata j'ai pas eu un seul tool call foiré avant d'utiliser UD 3.1 IQ1, que ça soit GSQ-RCO en Q2 ou Gyro-S (ou M).


---------------
Faudra que je teste un jour :o
n°55922
moyen_moin​s
chat réincarné
Posté le 07-11-2026 à 11:00:45  profilanswer
 

ce que j'appelle tool call foiré, c'est quand il doit s'y reprendre à 2 fois car le 1er coup, il a pas su ouvrir le fichier avec les bons arguments par exemple, qu'il les oublie ou qu'il a carrément pas fait comme il fallait du tout.

n°55933
the_fennec
f3nn3cUs z3rd4
Posté le 07-11-2026 à 11:56:07  profilanswer
 

moyen_moins a écrit :

ce que j'appelle tool call foiré, c'est quand il doit s'y reprendre à 2 fois car le 1er coup, il a pas su ouvrir le fichier avec les bons arguments par exemple, qu'il les oublie ou qu'il a carrément pas fait comme il fallait du tout.


Moi c'est quand il s'arrête car Strata renvoie une erreur de syntaxe que le tool call. Genre un XML invalide.


Message édité par the_fennec le 07-11-2026 à 11:56:29

---------------
Faudra que je teste un jour :o
n°55955
moyen_moin​s
chat réincarné
Posté le 07-11-2026 à 14:31:26  profilanswer
 

par contre, il peut pas cracher sur ses ancêtres ce modèle, les interfaces, c'est du pur qwen tout craché. :D
peu importe le quant, c'est toujours la même chose [:ddr555]


Message édité par moyen_moins le 07-11-2026 à 14:31:36
n°55986
the_fennec
f3nn3cUs z3rd4
Posté le 07-11-2026 à 18:21:42  profilanswer
 

Citation :

Strata 0.2.12: a tuned DFlash2 drafter, faster prompts on 12 GB cards, Strix Halo and Mac, and tool-call fixes
 
The app and the Terminal are 0.2.12. Control and every engine package are 0.1.58. The update feed is sequence 122.
The DGX Spark (linux-aarch64) gets 0.2.12 too.
Highlights
 
    12 GB cards (RTX 3060 class): UD-IQ4_XS-v31 prompts read about 3 times faster, 87 to 264 tokens per second at 2K.
    Strix Halo (Windows): prompts x1.24 to x2.14 on UD-IQ4_XS-v31 and UD-Q4_K_XL.
    Mac (M5 Max): output +10.3% to +12.7% and prompts +11.7% to +13.9% on UD-Q4_K_XL and UD-IQ4_XS-v31.
    Tuned DFlash2 drafter: Strata's own copy of the helper model that guesses the next words; decode +2.4% to +5.0% on the RTX PRO 5000 and the DGX Spark.
    Radeon R9700: 32K prompts +8.6% to +11.6%.
    Tool calls: Claude Desktop's model name is accepted (#5312), plus fixes for #5409, #5276, #5281, #4622 and PRs #4828 and #4832.


Bon ça va peut être régler mon soucis :jap:


---------------
Faudra que je teste un jour :o
n°55988
neo world
Posté le 07-11-2026 à 18:27:13  profilanswer
 

the_fennec a écrit :

Citation :

Strata 0.2.12: a tuned DFlash2 drafter, faster prompts on 12 GB cards, Strix Halo and Mac, and tool-call fixes
 
The app and the Terminal are 0.2.12. Control and every engine package are 0.1.58. The update feed is sequence 122.
The DGX Spark (linux-aarch64) gets 0.2.12 too.
Highlights
 
    12 GB cards (RTX 3060 class): UD-IQ4_XS-v31 prompts read about 3 times faster, 87 to 264 tokens per second at 2K.
    Strix Halo (Windows): prompts x1.24 to x2.14 on UD-IQ4_XS-v31 and UD-Q4_K_XL.
    Mac (M5 Max): output +10.3% to +12.7% and prompts +11.7% to +13.9% on UD-Q4_K_XL and UD-IQ4_XS-v31.
    Tuned DFlash2 drafter: Strata's own copy of the helper model that guesses the next words; decode +2.4% to +5.0% on the RTX PRO 5000 and the DGX Spark.
    Radeon R9700: 32K prompts +8.6% to +11.6%.
    Tool calls: Claude Desktop's model name is accepted (#5312), plus fixes for #5409, #5276, #5281, #4622 and PRs #4828 and #4832.


Bon ça va peut être régler mon soucis :jap:


ça commence à être sexy. Je vais surveiller l'arrivée des modèles en uncensored :D

n°55990
moyen_moin​s
chat réincarné
Posté le 07-11-2026 à 18:42:53  profilanswer
 

Ce qui est validé et actif
- Control 0.2.12 : HWiNFO R9700 OK (temp/power/VRAM, 34 GB), DFlash2, cache 10 332 slots / 1 364 Mio, images: true.
- Tool calls : 85 tests OK / 3 skipped sur les tests 0.2.12, et un tool call forcé live OK (get_weather Paris).
- Vision CPU : image test en 7,8 s, CODE 4217 correct.
- Canari 27K : 1 491,5 tok/s prompt / 79,5 tok/s décodage, réponse 31415.
- Code : 5/5 tests OK.


Daily actuel
- 8080, config strata-iq4_xs_v31.json, cwd: control-0.2.12, drafting: dflash2.
- Moteur engine-0.1.57, DFlash2, PLE RAM, vision CPU, 262144.
- Lanceur run-iq4_xs_v31.bat : serveur Control 0.2.12 + Python .venv + PYTHONPATH=control-0.2.12.
- Un seul serveur écoute sur 8080 ; le 8081 est arrêté.
- HWiNFO affiche une limite de 300 W pour la R9700 au lieu de 285 W avec l’ancien chemin ; temp/power/VRAM restent corrects.
- Control 0.2.12 choisit --draft-conf 0.5 au lieu de 0.35 ; DFlash2 conservé, canari/qualité OK.


migré cet aprèm :)


Message édité par moyen_moins le 07-11-2026 à 18:44:22
n°55994
neo world
Posté le 07-11-2026 à 18:54:21  profilanswer
 

je veux bien ton retour du dflash vs MTP. J'avais demandé ici mais le retour était pas dingue ^^

n°55995
moyen_moin​s
chat réincarné
Posté le 07-11-2026 à 18:56:21  profilanswer
 

perso, je trouve pas ça ouf, ça disait +5-6% vs MTP.  
sur les gros contexte, je trouve pas ça super flagrant.
l'avantage c'est que ça libère de la VRAM si j'ai bien compris, donc plus de place pour les experts :)

n°55997
the_fennec
f3nn3cUs z3rd4
Posté le 07-11-2026 à 19:09:44  profilanswer
 

neo world a écrit :


ça commence à être sexy. Je vais surveiller l'arrivée des modèles en uncensored :D


Pas besoin d'attendre:
https://github.com/Niko1221/Strata/ [...] by-default
 

Citation :


Experimental speed projection (experimental, off by default)
 
This is an experiment. It ships with Strata and stays off unless you turn it on. It is a 480 KB control vector for the original Qwen3.8-Flash-Next (data/experimental-speed-projection/, not Swift 1.5). After each of layers 4-44 the engine removes one direction from every hyper-connection stream: h -= (h . v) v.
 
What it changes. The vector's package describes it as a refusal-direction projection. With it the model declines far fewer requests, and removing refusals removes a safety behavior, so you are responsible for what the model writes with it on. It also shifts ordinary answers a little and costs 0.2-0.4% per token. What a chat's tokens/s does depends on the text, so measure it on your own prompts. The Monitor marks every request ESP or stock.


C'est une des options du setup, mais j'ai pas testé :o


---------------
Faudra que je teste un jour :o
n°55998
neo world
Posté le 07-11-2026 à 19:14:47  profilanswer
 

ah ouais le uncensor-o-matic :D

n°56001
neo world
Posté le 07-11-2026 à 19:44:36  profilanswer
 

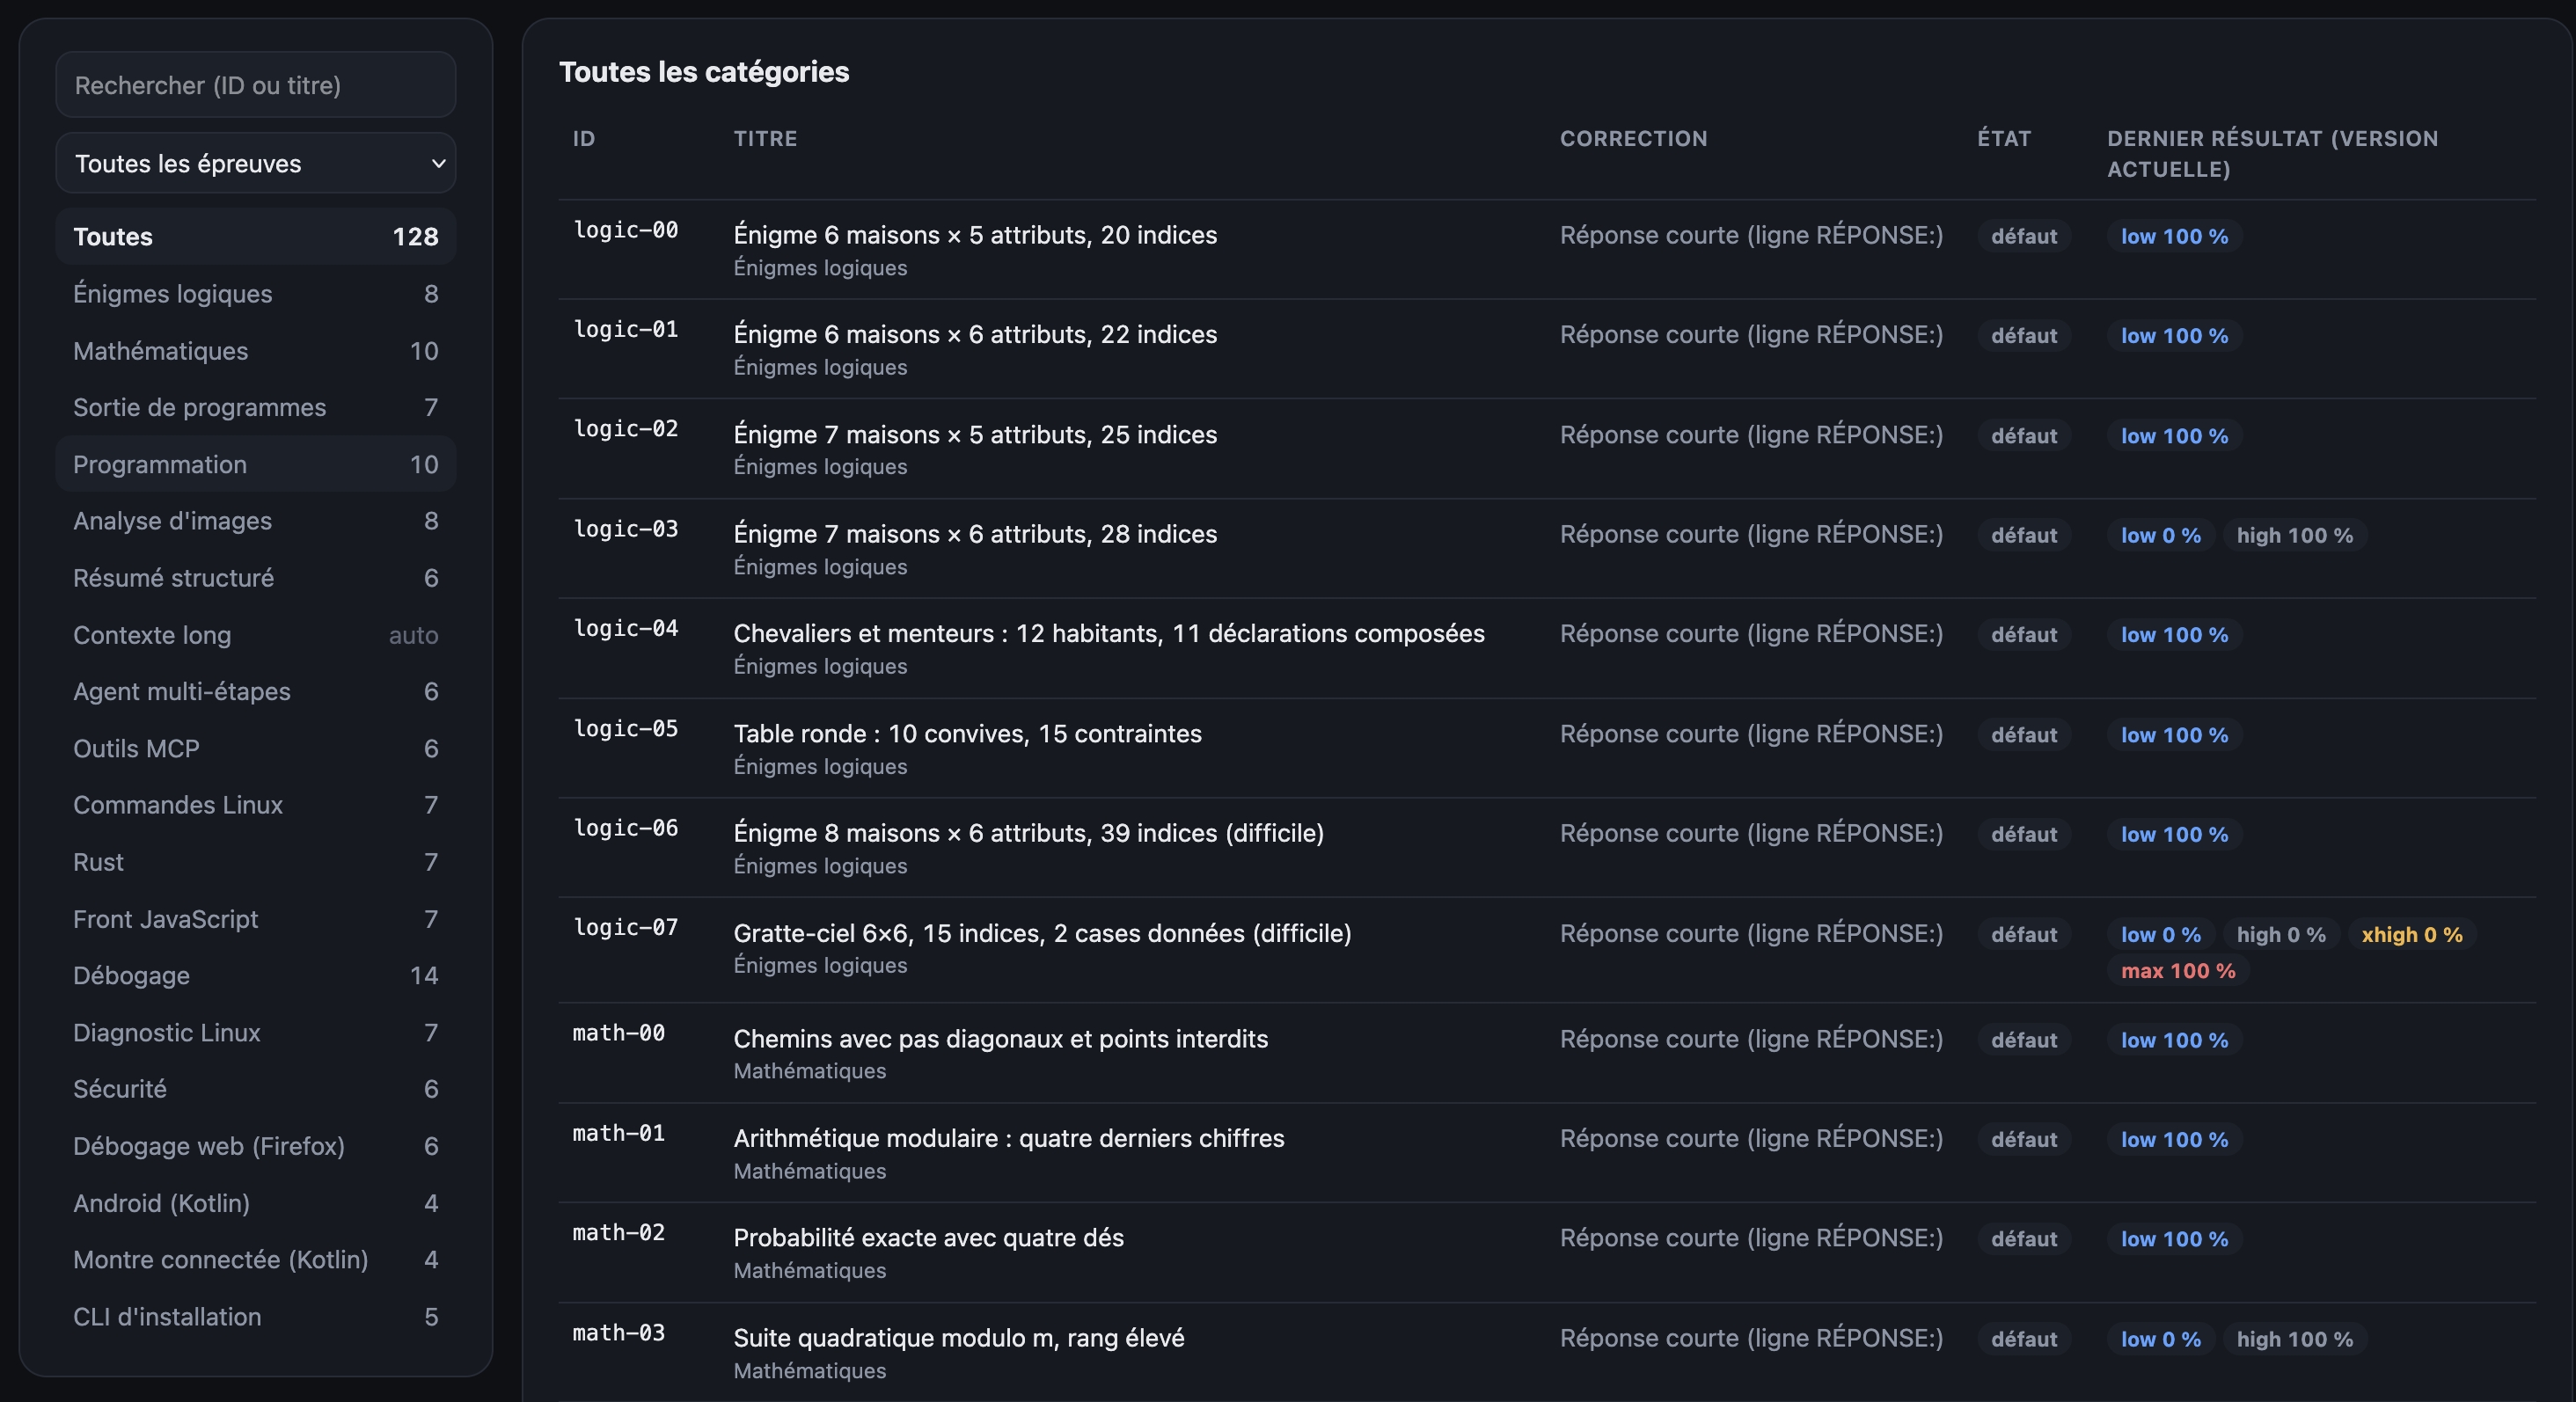
Sinon j'avance sur mon outil de benchmark : 128 épreuves désormais
 
https://rehost.diberie.com/Picture/Get/f/568473
 
4 modes d'évaluation : Low 65k tokens max pour la réponse, med 65k tokens max pour la réponse, High 65k tokens max pour la réponse et Max 128 ou 256k tokens de budget. Dans le budget thinking est toujours compris.
 
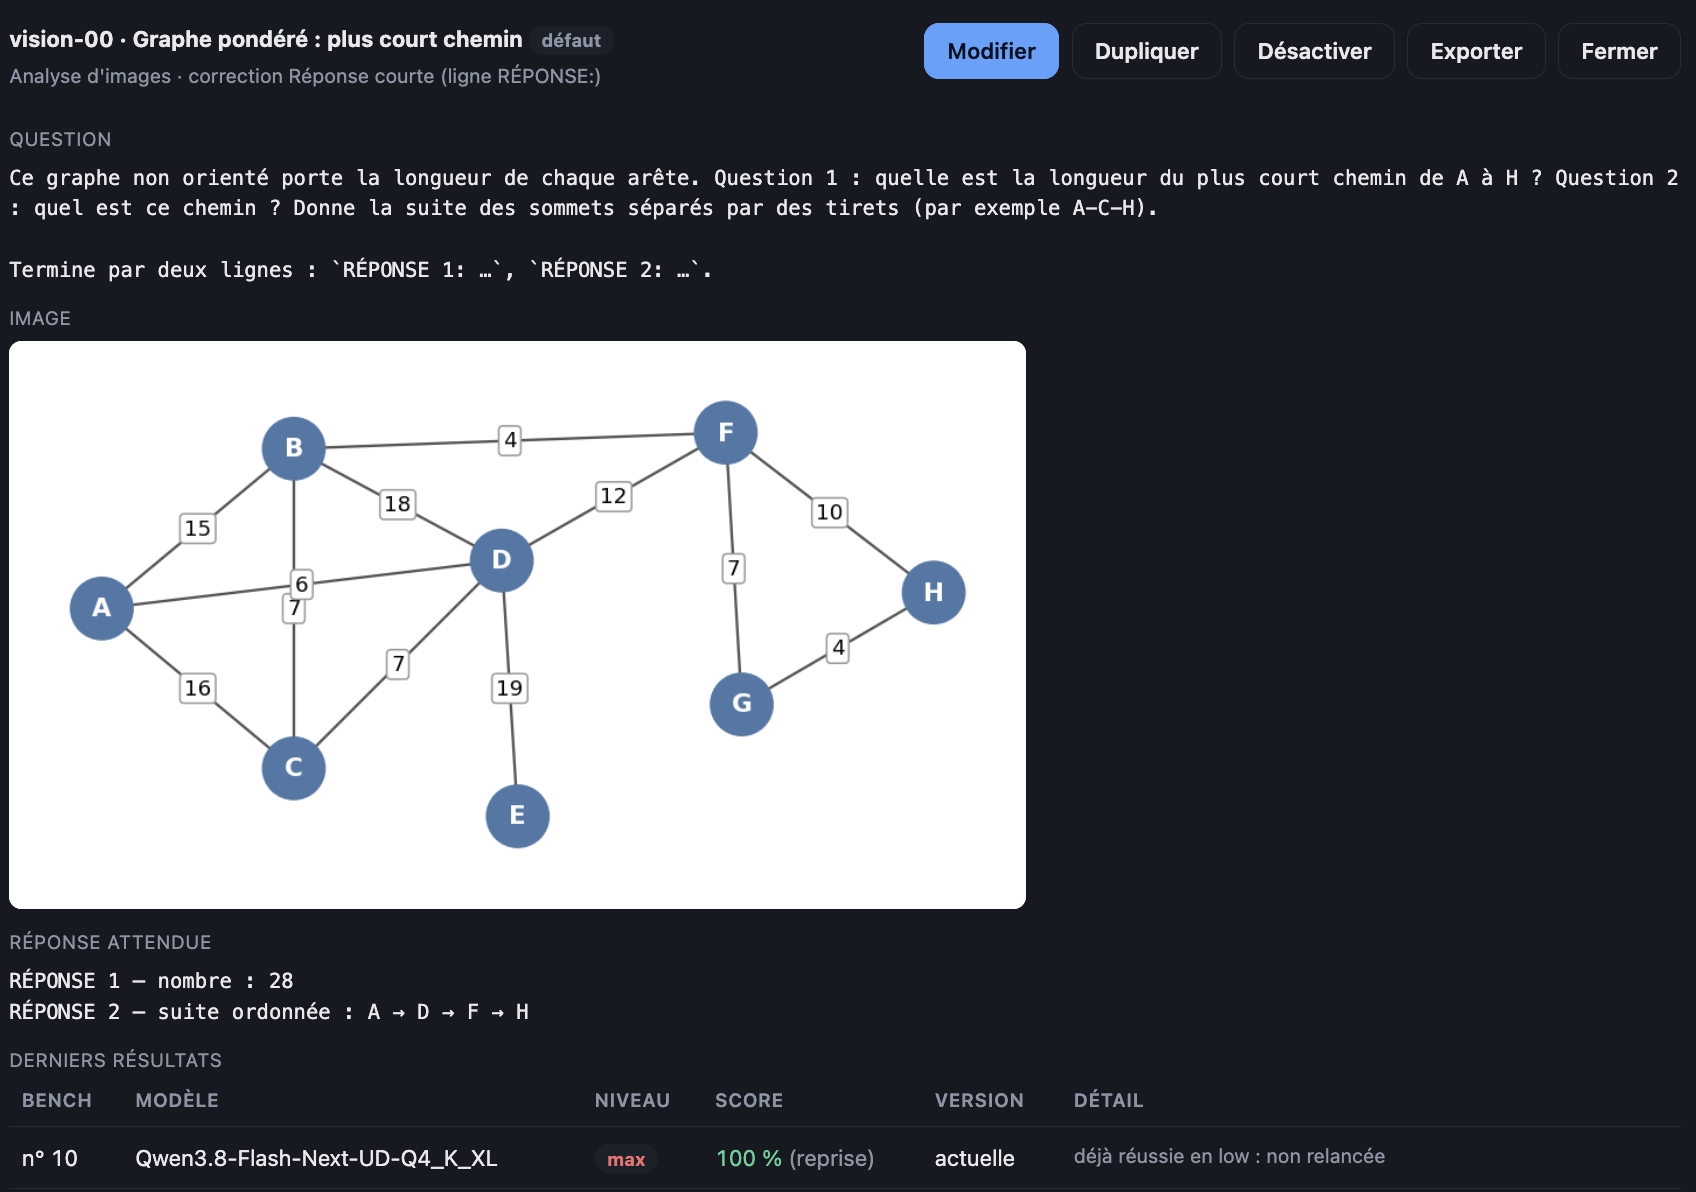
Y'a maintenant un editeur d'épreuves avec possibilité de les voir, importer ou exporter en MD (si vous êtes curieux de les voir pour faire votre propre moulinette qui les soumet à votre IA : faites péter vos MP :D)
 
https://rehost.diberie.com/Picture/Get/f/568475
 
Je vais continuer à faire évoluer les épreuves (plutôt orientés sur mon environnement notamment avec du debug de proxmox / truenas / hosts depuis le MCP de Pulse https://github.com/rcourtman/pulse , des morceaux de wazuh pour le monitoring sécu, Authentik pour le portail d'ID / marketplace familial etc/ , Nextcloud ... ) en espérant trouver plus de trous dans la raquette dans l'entrainement de Qwen 3.8 mais so far :  [:implosion du tibia]

n°56003
neo world
Posté le 07-11-2026 à 20:23:24  profilanswer
 

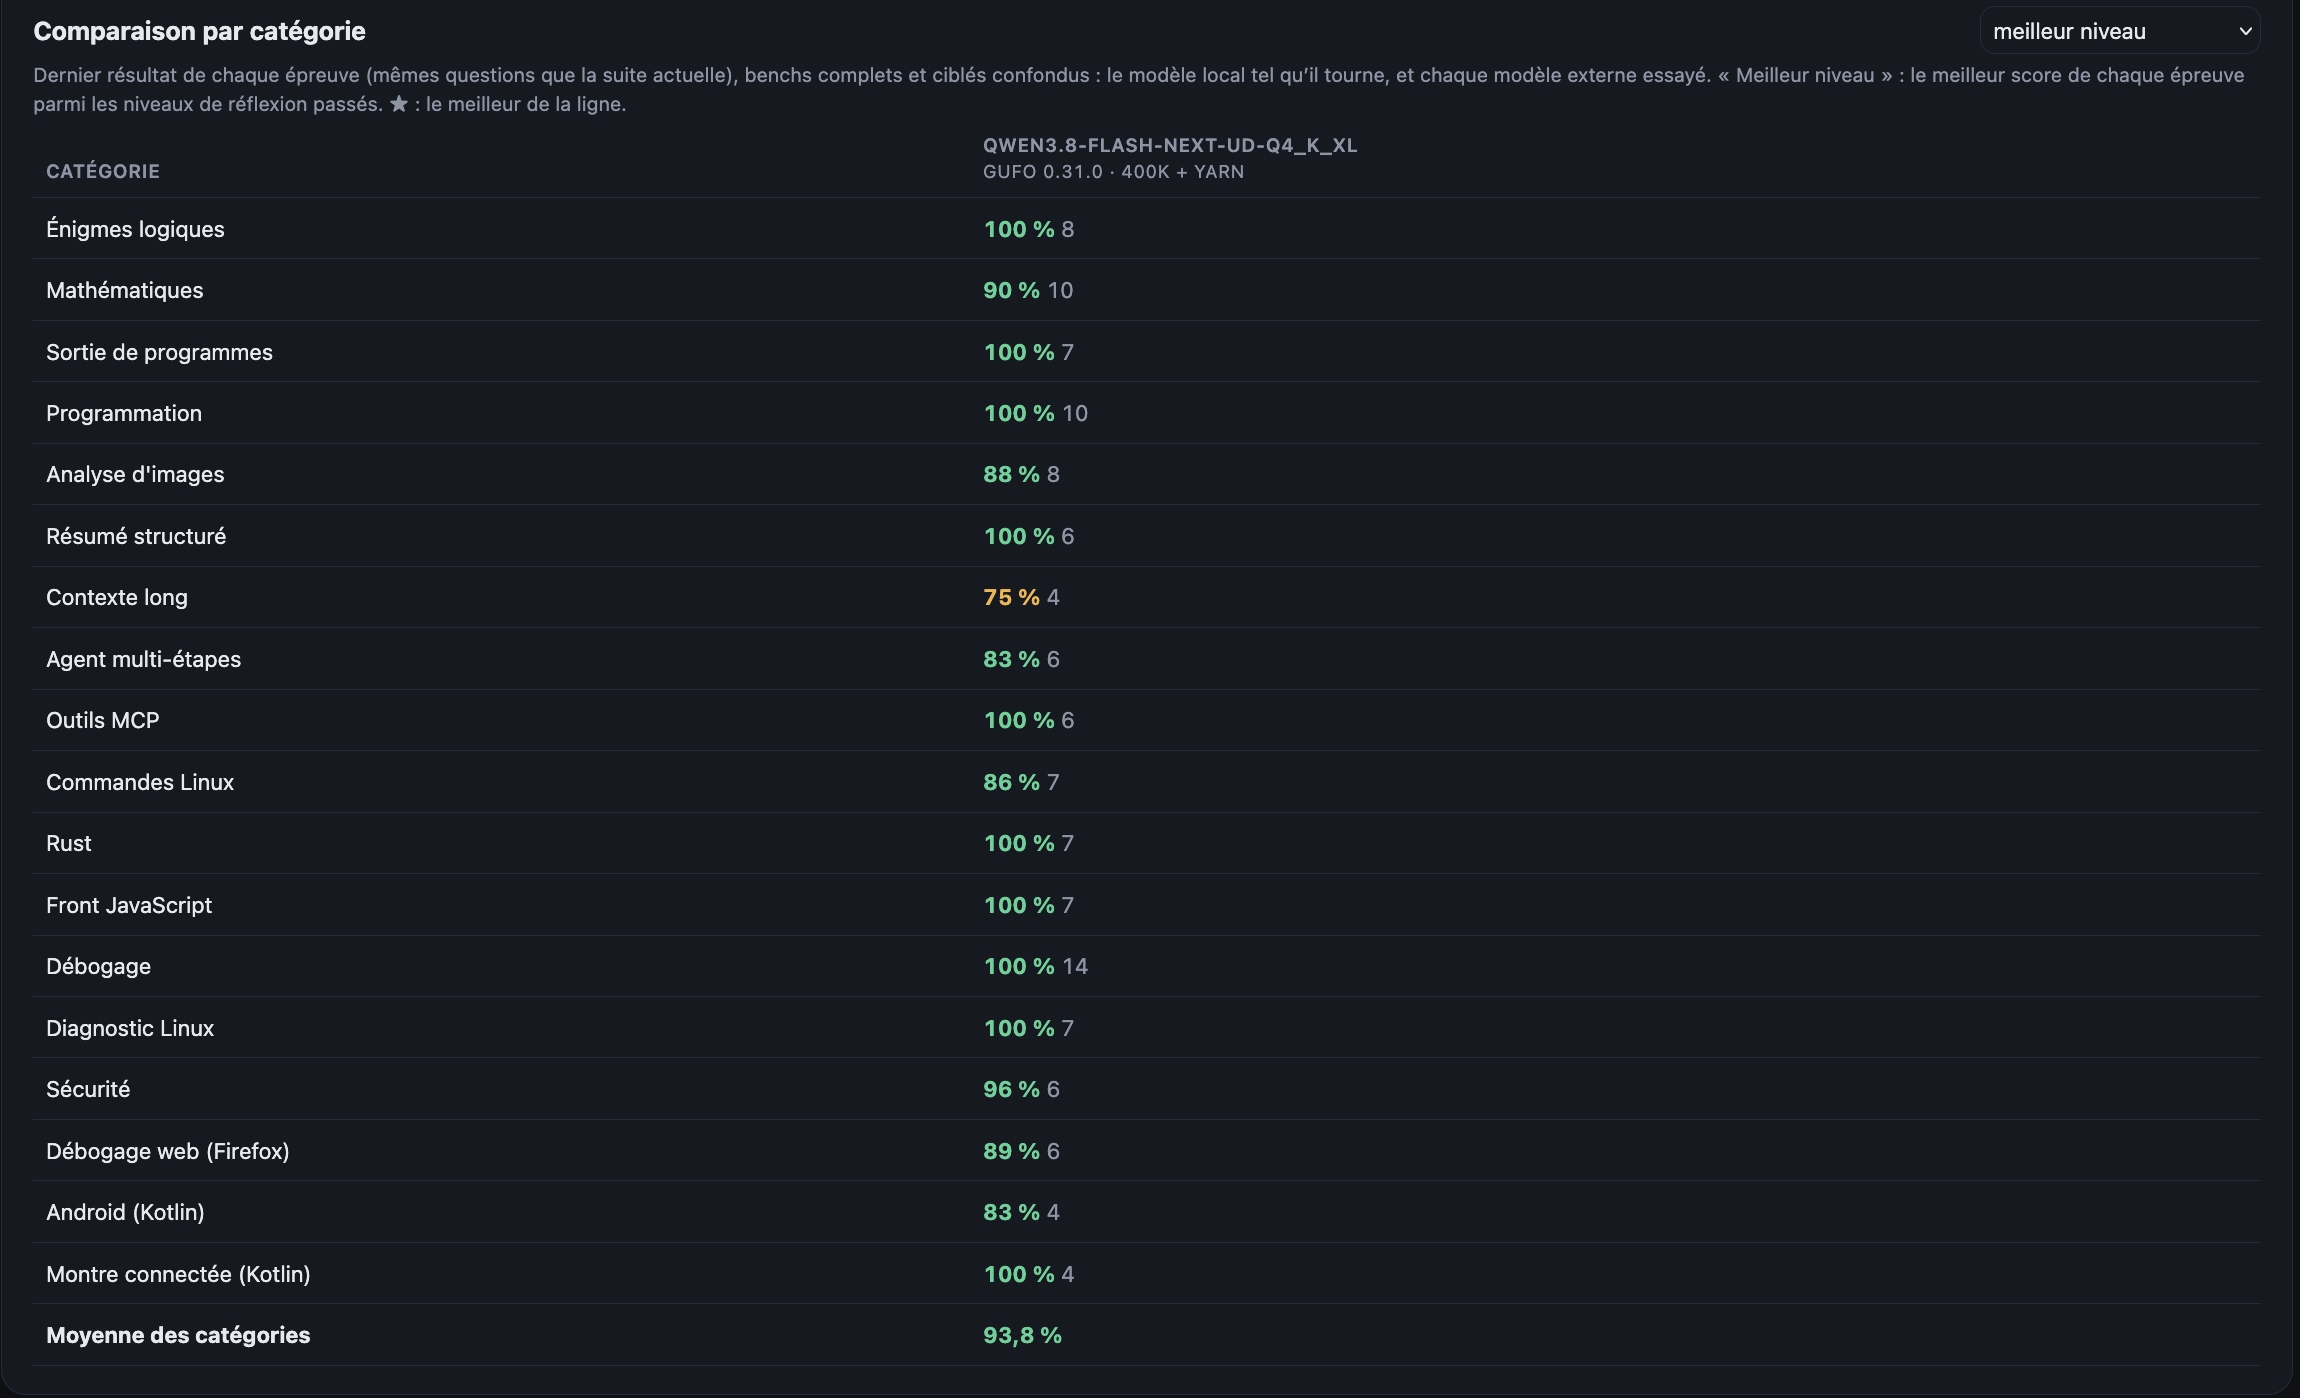
ça vient de finir le run de 128 épreuves. Taux de réussite tous niveaux inclus :
 
https://rehost.diberie.com/Picture/Get/f/568483
 
 
je vous épargne les maths : en budget max il réussit 92,6% des épreuves (contre 84% en mode Xhigh budget 65K et 80,8% en mode Low thinking)


Message édité par neo world le 07-11-2026 à 20:23:41
n°56005
XaTriX
Posté le 07-11-2026 à 21:08:18  profilanswer
 

han c'est sympa ça


---------------
[:dawa]
n°56009
Pipould's
Posté le 08-11-2026 à 00:27:46  profilanswer
 

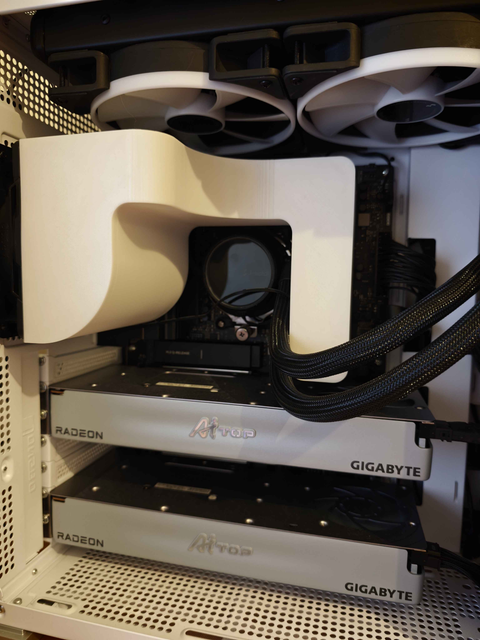
D'ailleurs pour ceux qui sont en DDR5, je peux vous conseiller de mettre du cooling sur la ram.  
 
https://i.ibb.co/ycq27nLD/image.png
 
Ma ram etait a 70c en inference, jamais vu autant... Avec Radiance.

Message cité 2 fois
Message édité par Pipould's le 08-11-2026 à 00:43:26
n°56012
neo world
Posté le 08-11-2026 à 00:55:02  profilanswer
 

Pipould's a écrit :

D'ailleurs pour ceux qui sont en DDR5, je peux vous conseiller de mettre du cooling sur la ram.  
 
https://i.ibb.co/ycq27nLD/image.png
 
Ma ram etait a 70c en inference, jamais vu autant... Avec Radiance.


propre ! :D
 
Tu es passé à combien de degrés maintenant ? En naïf avec un simple ventilateur devant la RAM c'était juste trop moche (ça économisait pas mal de plastique de juste rajouter ce qu'il faut pour installer le ventilo face à la CM au lieu de faire un tunnel) ou c'est carrément moins efficace que ton tunnel ?  
 
pas de découpe à l'arrache ni de scotch de que le topic aime tant ...  [:bibliophage:2]  :whistle:

n°56013
crazytiti
http://crazytiti.free.fr/
Posté le 08-11-2026 à 02:46:29  profilanswer
 

Je viens de tester "speed projection" ça me semble OK, il veux bien faire ce qu'il ne voulait pas faire et que ne voulait pas faire non plus une version "abliterated" :bounce:


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°56015
the_fennec
f3nn3cUs z3rd4
Posté le 08-11-2026 à 09:28:36  profilanswer
 

Pipould's a écrit :

D'ailleurs pour ceux qui sont en DDR5, je peux vous conseiller de mettre du cooling sur la ram.  
 
https://i.ibb.co/ycq27nLD/image.png
 
Ma ram etait a 70c en inference, jamais vu autant... Avec Radiance.


C'est peut être a cause de ton AIO, avec un rad CPU normal ta RAM reçoit de l'air.
 

crazytiti a écrit :

Je viens de tester "speed projection" ça me semble OK, il veux bien faire ce qu'il ne voulait pas faire et que ne voulait pas faire non plus une version "abliterated" :bounce:


Cool, t'as quel modèle? Dans la doc il est dit que ça marche pas avec Swift.


---------------
Faudra que je teste un jour :o
n°56016
Pipould's
Posté le 08-11-2026 à 09:32:01  profilanswer
 

neo world a écrit :


propre ! :D
 
Tu es passé à combien de degrés maintenant ? En naïf avec un simple ventilateur devant la RAM c'était juste trop moche (ça économisait pas mal de plastique de juste rajouter ce qu'il faut pour installer le ventilo face à la CM au lieu de faire un tunnel) ou c'est carrément moins efficace que ton tunnel ?  
 
pas de découpe à l'arrache ni de scotch de que le topic aime tant ...  [:bibliophage:2]  :whistle:


Je suis passe de 72 -> 45c.
 
Je devais ramener de l'air dans le boitier, sinon je n'ai que un ventilo de 120. Donc celui ci pousse de l'air dans le boitier aussi. Niveau plastique c'est ~150gr. T'as des versions direct sur la ram mais je voulais un truc visse au boitier et pas accroche a la ram...
 

 Page :   1  2  3  4  5  ..  95  96  97  98  99  100
Page Suivante

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)