Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5132 connectés 


Au quotidien je suis


21.9 %
 7 votes
1.  Satisfait de mon setup d'inférence
 
 
21.9 %
 7 votes
2.  ça va mais c'est pas assez rapide
 
 
6.2 %
 2 votes
3.  ça va mais mon IA manque de skills
 
 
0.0 %
        0 vote
4.  ça plantouille pas mal quand même
 
 
0.0 %
        0 vote
5.  quelle IA ? j'attend la generation de modèle super intelligence rated :o
 
 
12.5 %
 4 votes
6.  Je souhaite en priorité plus de tok/s
 
 
15.6 %
 5 votes
7.  Je souhaite en priorité plus de skills (cyber, reverse engineering, code ...)
 
 
9.4 %
 3 votes
8.  Je souhaite en priorité moins d'hallucinations
 
 
6.2 %
 2 votes
9.  Je souhaite en priorité plus de sécurité (prompt injection, trojan, vols de credentials ...)
 
 
6.2 %
 2 votes
10.  Je souhaite en priorité moins de code spaghetti :-(
 

Total : 36 votes (4 votes blancs)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  94  95  96  97  98  99
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°55609
neo world
Posté le 04-11-2026 à 16:15:21  profilanswer
 

Reprise du message précédent :
Résultats intéressants de l’inference locale avec GLM chez revolut :
https://www.theregister.com/ai-and- [...] ed/5307345

n°55610
neo world
Posté le 04-11-2026 à 16:17:23  profilanswer
 

b-tzu a écrit :

le 4 nest pas un chiffre qui porte malheure en chine ? ils devraient passer a Qwen 5 direct


De tête c’est pas vu comme un porte malheur partout. Y’a des coins où au contraire c’est un porte bonheur. Mais en effet j’ai vu des immeubles sans 4 eme étage dans certains coins (bon c’est pas si spectaculaire que ça en a l’air le 4 eme etait juste noté 5eme dans le hall ascenseur :D )

n°55613
moyen_moin​s
chat réincarné
Posté le 04-11-2026 à 16:43:29  profilanswer
 

neo world a écrit :

Résultats intéressants de l’inference locale avec GLM chez revolut :
https://www.theregister.com/ai-and- [...] ed/5307345


la chaine YT asianometry a fait une vidé sur z.ai et les modèles GLM :)
j'utilise beaucoup depuis le 4.5, globalement très bon petit modèle :)

n°55622
crazytiti
http://crazytiti.free.fr/
Posté le 04-11-2026 à 19:02:57  profilanswer
 

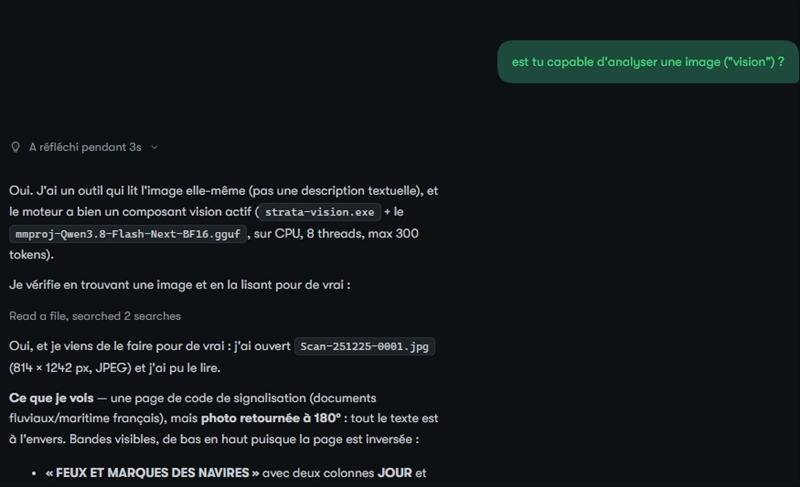
Le dernier strata va effectivement plus vite que celui que j'avais avant, je suis passé de 60-70 t/s à 70-80 :bounce:


Edit : en plus maintenant la vision marche sous windows en CPU :
https://rehost.diberie.com/Picture/Get/r/567557


Message édité par crazytiti le 04-11-2026 à 19:27:57

---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°55631
XaTriX
Posté le 04-11-2026 à 22:18:00  profilanswer
 

neo world a écrit :

Résultats intéressants de l’inference locale avec GLM chez revolut :
https://www.theregister.com/ai-and- [...] ed/5307345


Jamais fan de ces retours qui parlent pas des harness ou des classifiers :( Pour moi c'est le nerf de la guerre parce que payer un token 1X ou 10X, c'est le même ordre de grandeur.


---------------
[:dawa]
n°55632
Astroya
Posté le 04-11-2026 à 22:20:17  profilanswer
 

XaTriX a écrit :


Jamais fan de ces retours qui parlent pas des harness ou des classifiers :( Pour moi c'est le nerf de la guerre parce que payer un token 1X ou 10X, c'est le même ordre de grandeur.


Euh littéralement non :D Il y a un souci de formulation je pense :o

n°55633
XaTriX
Posté le 04-11-2026 à 22:22:22  profilanswer
 

OK 9X :o


---------------
[:dawa]
n°55635
XaTriX
Posté le 04-11-2026 à 22:25:10  profilanswer
 

Un ordre de grandeur de différence ? :o
J4aurai du laisser un LLM parler :o


---------------
[:dawa]
n°55636
XaTriX
Posté le 04-11-2026 à 22:28:17  profilanswer
 

En fait je pense que l'article c'est du bullshit :o


---------------
[:dawa]
n°55637
Astroya
Posté le 04-11-2026 à 22:34:14  profilanswer
 

XaTriX a écrit :

Un ordre de grandeur de différence ? :o
J4aurai du laisser un LLM parler :o


Oui a priori, entre 1 et 10 il y a un ordre de grandeur d’écart :o Sur ce je retourne lurker :o


Message édité par Astroya le 04-11-2026 à 22:34:49
n°55638
XaTriX
Posté le 04-11-2026 à 22:35:20  profilanswer
 

Brulez ce forumeur :o


---------------
[:dawa]
n°55657
neo world
Posté le 05-11-2026 à 09:54:39  profilanswer
 

bon j'ai activé le YARN de mon côté  [:cerveau delight]  
 
    run 1/3 :   69916 tokens  prefill 1690.2 tok/s  (1er token 41 s)  |  prose 33.8 tok/s  acceptation 38.7 %  |  GPU 30→51 °C  |  aiguille trouvée
    run 2/3 :  250834 tokens  prefill 1523.3 tok/s  (1er token 165 s)  |  prose 39.3 tok/s  acceptation 48.4 %  |  GPU 51→57 °C  |  aiguille trouvée
    run 3/3 :  392102 tokens  prefill 1433.9 tok/s  (1er token 273 s)  |  prose 35.5 tok/s  acceptation 45.9 %  |  GPU 57→58 °C  |  aiguille trouvée
(l'aiguille c'est un terme qui est demandé en fin de bench pour vérifier que le modèle est pas dépassé par son contexte)
 
Je passe pas à 1M pour garder la possibilité d'avoir deux sessions en simultané dans 128GB

n°55658
ionik
Posté le 05-11-2026 à 10:16:58  profilanswer
 

C'est quoi ça le yarn ? (je connais le soft pour gérer les dépendances node uniquement :o)


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°55667
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 11:26:10  profilanswer
 

j'ai essayé le yarn sur le iq3_s de strata et 384K ça passe facile.
je devrais recevoir ma RAM, je vais essayer de rester sur 256K mais avec le ud_q4_k_xl et le PLE en RAM.
ça devrait passer d'après l'IA :o

n°55668
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 11:27:10  profilanswer
 

ionik a écrit :

C'est quoi ça le yarn ? (je connais le soft pour gérer les dépendances node uniquement :o)


réponse de noob : c'est pour dépasser le contexte "officiel" ou recommandé du modèle.
genre qwen 3.8 FN tu peux le passer de 256K à 1M.

n°55669
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 11:47:56  profilanswer
 

Mais tout le contexte est en VRAM? Donc en en faut des gigas :(


---------------
Faudra que je teste un jour :o
n°55670
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 11:48:59  profilanswer
 

neo world a écrit :

bon j'ai activé le YARN de mon côté  [:cerveau delight]  
 
    run 1/3 :   69916 tokens  prefill 1690.2 tok/s  (1er token 41 s)  |  prose 33.8 tok/s  acceptation 38.7 %  |  GPU 30→51 °C  |  aiguille trouvée
    run 2/3 :  250834 tokens  prefill 1523.3 tok/s  (1er token 165 s)  |  prose 39.3 tok/s  acceptation 48.4 %  |  GPU 51→57 °C  |  aiguille trouvée
    run 3/3 :  392102 tokens  prefill 1433.9 tok/s  (1er token 273 s)  |  prose 35.5 tok/s  acceptation 45.9 %  |  GPU 57→58 °C  |  aiguille trouvée
(l'aiguille c'est un terme qui est demandé en fin de bench pour vérifier que le modèle est pas dépassé par son contexte)
 
Je passe pas à 1M pour garder la possibilité d'avoir deux sessions en simultané dans 128GB


Combien de VRAM ça te prends? t'es en q8?


---------------
Faudra que je teste un jour :o
n°55678
neo world
Posté le 05-11-2026 à 12:55:56  profilanswer
 

the_fennec a écrit :


Combien de VRAM ça te prends? t'es en q8?


Q4 K XL. 103GO avec le YaRN et une session en cours de 400k tokens  [:911gt3]

Message cité 1 fois
Message édité par neo world le 05-11-2026 à 12:56:52
n°55680
neo world
Posté le 05-11-2026 à 12:57:44  profilanswer
 

ionik a écrit :

C'est quoi ça le yarn ? (je connais le soft pour gérer les dépendances node uniquement :o)


moyen_moins a écrit :


réponse de noob : c'est pour dépasser le contexte "officiel" ou recommandé du modèle.
genre qwen 3.8 FN tu peux le passer de 256K à 1M.


précisément ! à la différence que le contexte de base est de 265k sans. YaRN :D

n°55686
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 13:27:04  profilanswer
 

neo world a écrit :


Q4 K XL. 103GO avec le YaRN et une session en cours de 400k tokens  [:911gt3]


t'as pas essayé deepseek coder rco-gsq ?

n°55689
neo world
Posté le 05-11-2026 à 13:52:44  profilanswer
 

moyen_moins a écrit :


t'as pas essayé deepseek coder rco-gsq ?


pas pour le moment, Gufo supporte enfin plus de quantisations mais je reste sur le modèle non censuré que j'aime bien (hui hui v2). Je me remettrais en chasse d'un autre modèle quand j'aurais des tâches trop complexes pour lui :jap: (et quand il y aura des Qwen v4 uncensored assez matures :D )

n°55693
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 14:25:13  profilanswer
 

Ya les nouveaux quants QFN Unsloth dynamic 3.1 ajoutés dans le dernier Strata.


---------------
Faudra que je teste un jour :o
n°55698
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 15:05:53  profilanswer
 

the_fennec a écrit :

Ya les nouveaux quants QFN Unsloth dynamic 3.1 ajoutés dans le dernier Strata.


ils ont quoi de plus ces nouveaux quant ? :o
edit: que pour deepseek

Message cité 1 fois
Message édité par moyen_moins le 05-11-2026 à 15:09:09
n°55699
ionik
Posté le 05-11-2026 à 15:07:46  profilanswer
 

moyen_moins a écrit :


réponse de noob : c'est pour dépasser le contexte "officiel" ou recommandé du modèle.
genre qwen 3.8 FN tu peux le passer de 256K à 1M.


Ha ok ben je l'avais utilisé avec strata déjà alors xD


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°55705
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 15:34:53  profilanswer
 

moyen_moins a écrit :


ils ont quoi de plus ces nouveaux quant ? :o
edit: que pour deepseek


Non Qwen Flash Next:
https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
 

Citation :

Nov 4 update: Dynamic v3.1 GGUF is here with 15% more accuracy than other frontier quants and scoring the highest on Terminal Bench, DeepSWE and more! Details


https://unsloth.ai/docs/models/qwen [...] r-2nd-2026
 
Avec un petit tacle au passage UD-IQ1_S qui fait presque aussi bien que GSQ-RCO IQ3_S:
https://i.imgur.com/IeuotF9.png


---------------
Faudra que je teste un jour :o
n°55709
neo world
Posté le 05-11-2026 à 15:46:05  profilanswer
 

the_fennec a écrit :


Non Qwen Flash Next:
https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
 

Citation :

Nov 4 update: Dynamic v3.1 GGUF is here with 15% more accuracy than other frontier quants and scoring the highest on Terminal Bench, DeepSWE and more! Details


https://unsloth.ai/docs/models/qwen [...] r-2nd-2026
 
Avec un petit tacle au passage UD-IQ1_S qui fait presque aussi bien que GSQ-RCO IQ3_S:
https://i.imgur.com/IeuotF9.png


le IQ3 va facilement remplacer Q4 pour la prochaine génération  :love:  
 
Faudra voir l'impact en terme de perfs vs nvfp4 / mxfp4 mais miam.  
 
les prix pas possibles du hardware en ce moment ont bien les conséquences que j’espérais : une profonde optimisation des modèles / moteurs pour faire tourner confortablement des modèles performants. J'avais juste pas vu venir la mode du "je mets un bout de minitel, avec mon vieux galaxy S1 + un gpu tombé d'une ferme de minage + un peu de RAM arraché d'un serveur sorti il y a 10 ans et paf je te mets du frontier like model qui tourne confortablement"  :pt1cable:

n°55712
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 16:12:05  profilanswer
 

neo world a écrit :


le IQ3 va facilement remplacer Q4 pour la prochaine génération  :love:  
 
Faudra voir l'impact en terme de perfs vs nvfp4 / mxfp4 mais miam.  
 
les prix pas possibles du hardware en ce moment ont bien les conséquences que j’espérais : une profonde optimisation des modèles / moteurs pour faire tourner confortablement des modèles performants. J'avais juste pas vu venir la mode du "je mets un bout de minitel, avec mon vieux galaxy S1 + un gpu tombé d'une ferme de minage + un peu de RAM arraché d'un serveur sorti il y a 10 ans et paf je te mets du frontier like model qui tourne confortablement"  :pt1cable:


Je viens de faire un tour dans notre baie locale de virtualization qui sert presque plus à rien vu qu'on est passé sur AWS. Il doit bien y avoir 3TB de DDR4 pour moins de 40 VMs dont 10 tournent de temps en temps. J'ai bien envie de me faire une grosse VM avec 500GB de RAM et ma paire de BC250 montées à travers un tunnel HTTPS :o


---------------
Faudra que je teste un jour :o
n°55737
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 17:22:10  profilanswer
 

the_fennec a écrit :


Non Qwen Flash Next:
https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF

 
Citation :

Nov 4 update: Dynamic v3.1 GGUF is here with 15% more accuracy than other frontier quants and scoring the highest on Terminal Bench, DeepSWE and more! Details


https://unsloth.ai/docs/models/qwen [...] r-2nd-2026


Avec un petit tacle au passage UD-IQ1_S qui fait presque aussi bien que GSQ-RCO IQ3_S:
https://i.imgur.com/IeuotF9.png


:jap:
il y a peut être un vrai gap du coup avec l'iq4_xs alors sans "exploser" la taille  [:paysan]
edit: par rapport à avant ou c'était pas vraiment le cas

Message cité 1 fois
Message édité par moyen_moins le 05-11-2026 à 17:24:18
n°55742
neo world
Posté le 05-11-2026 à 17:35:22  profilanswer
 

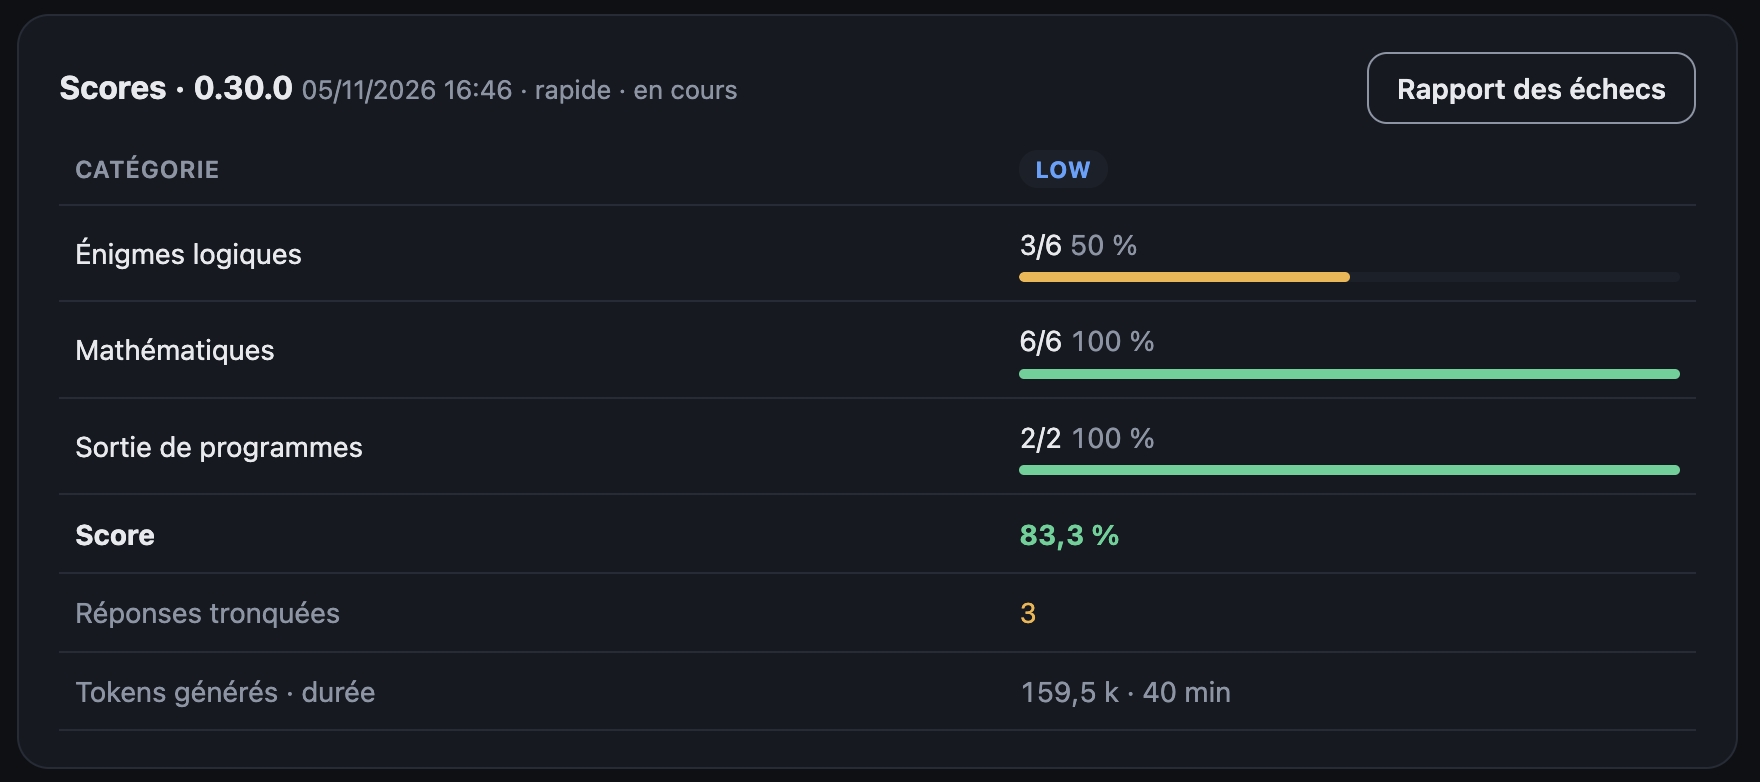
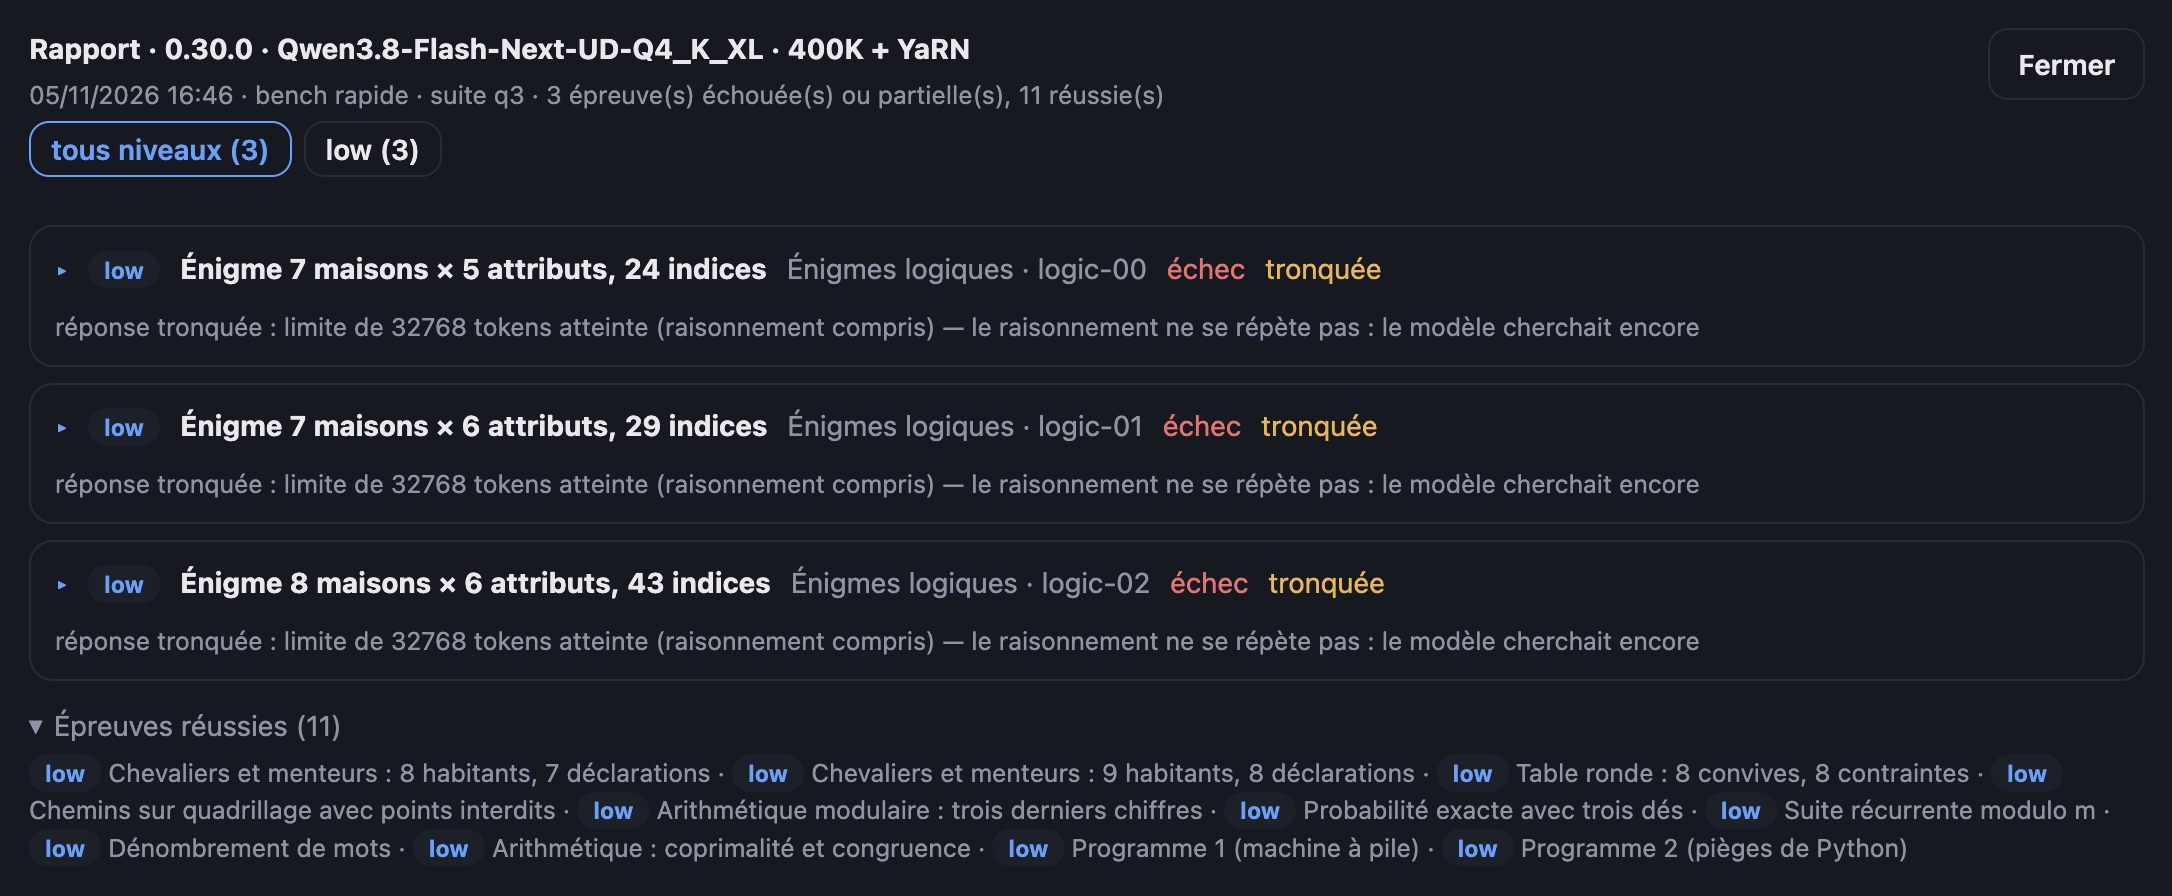
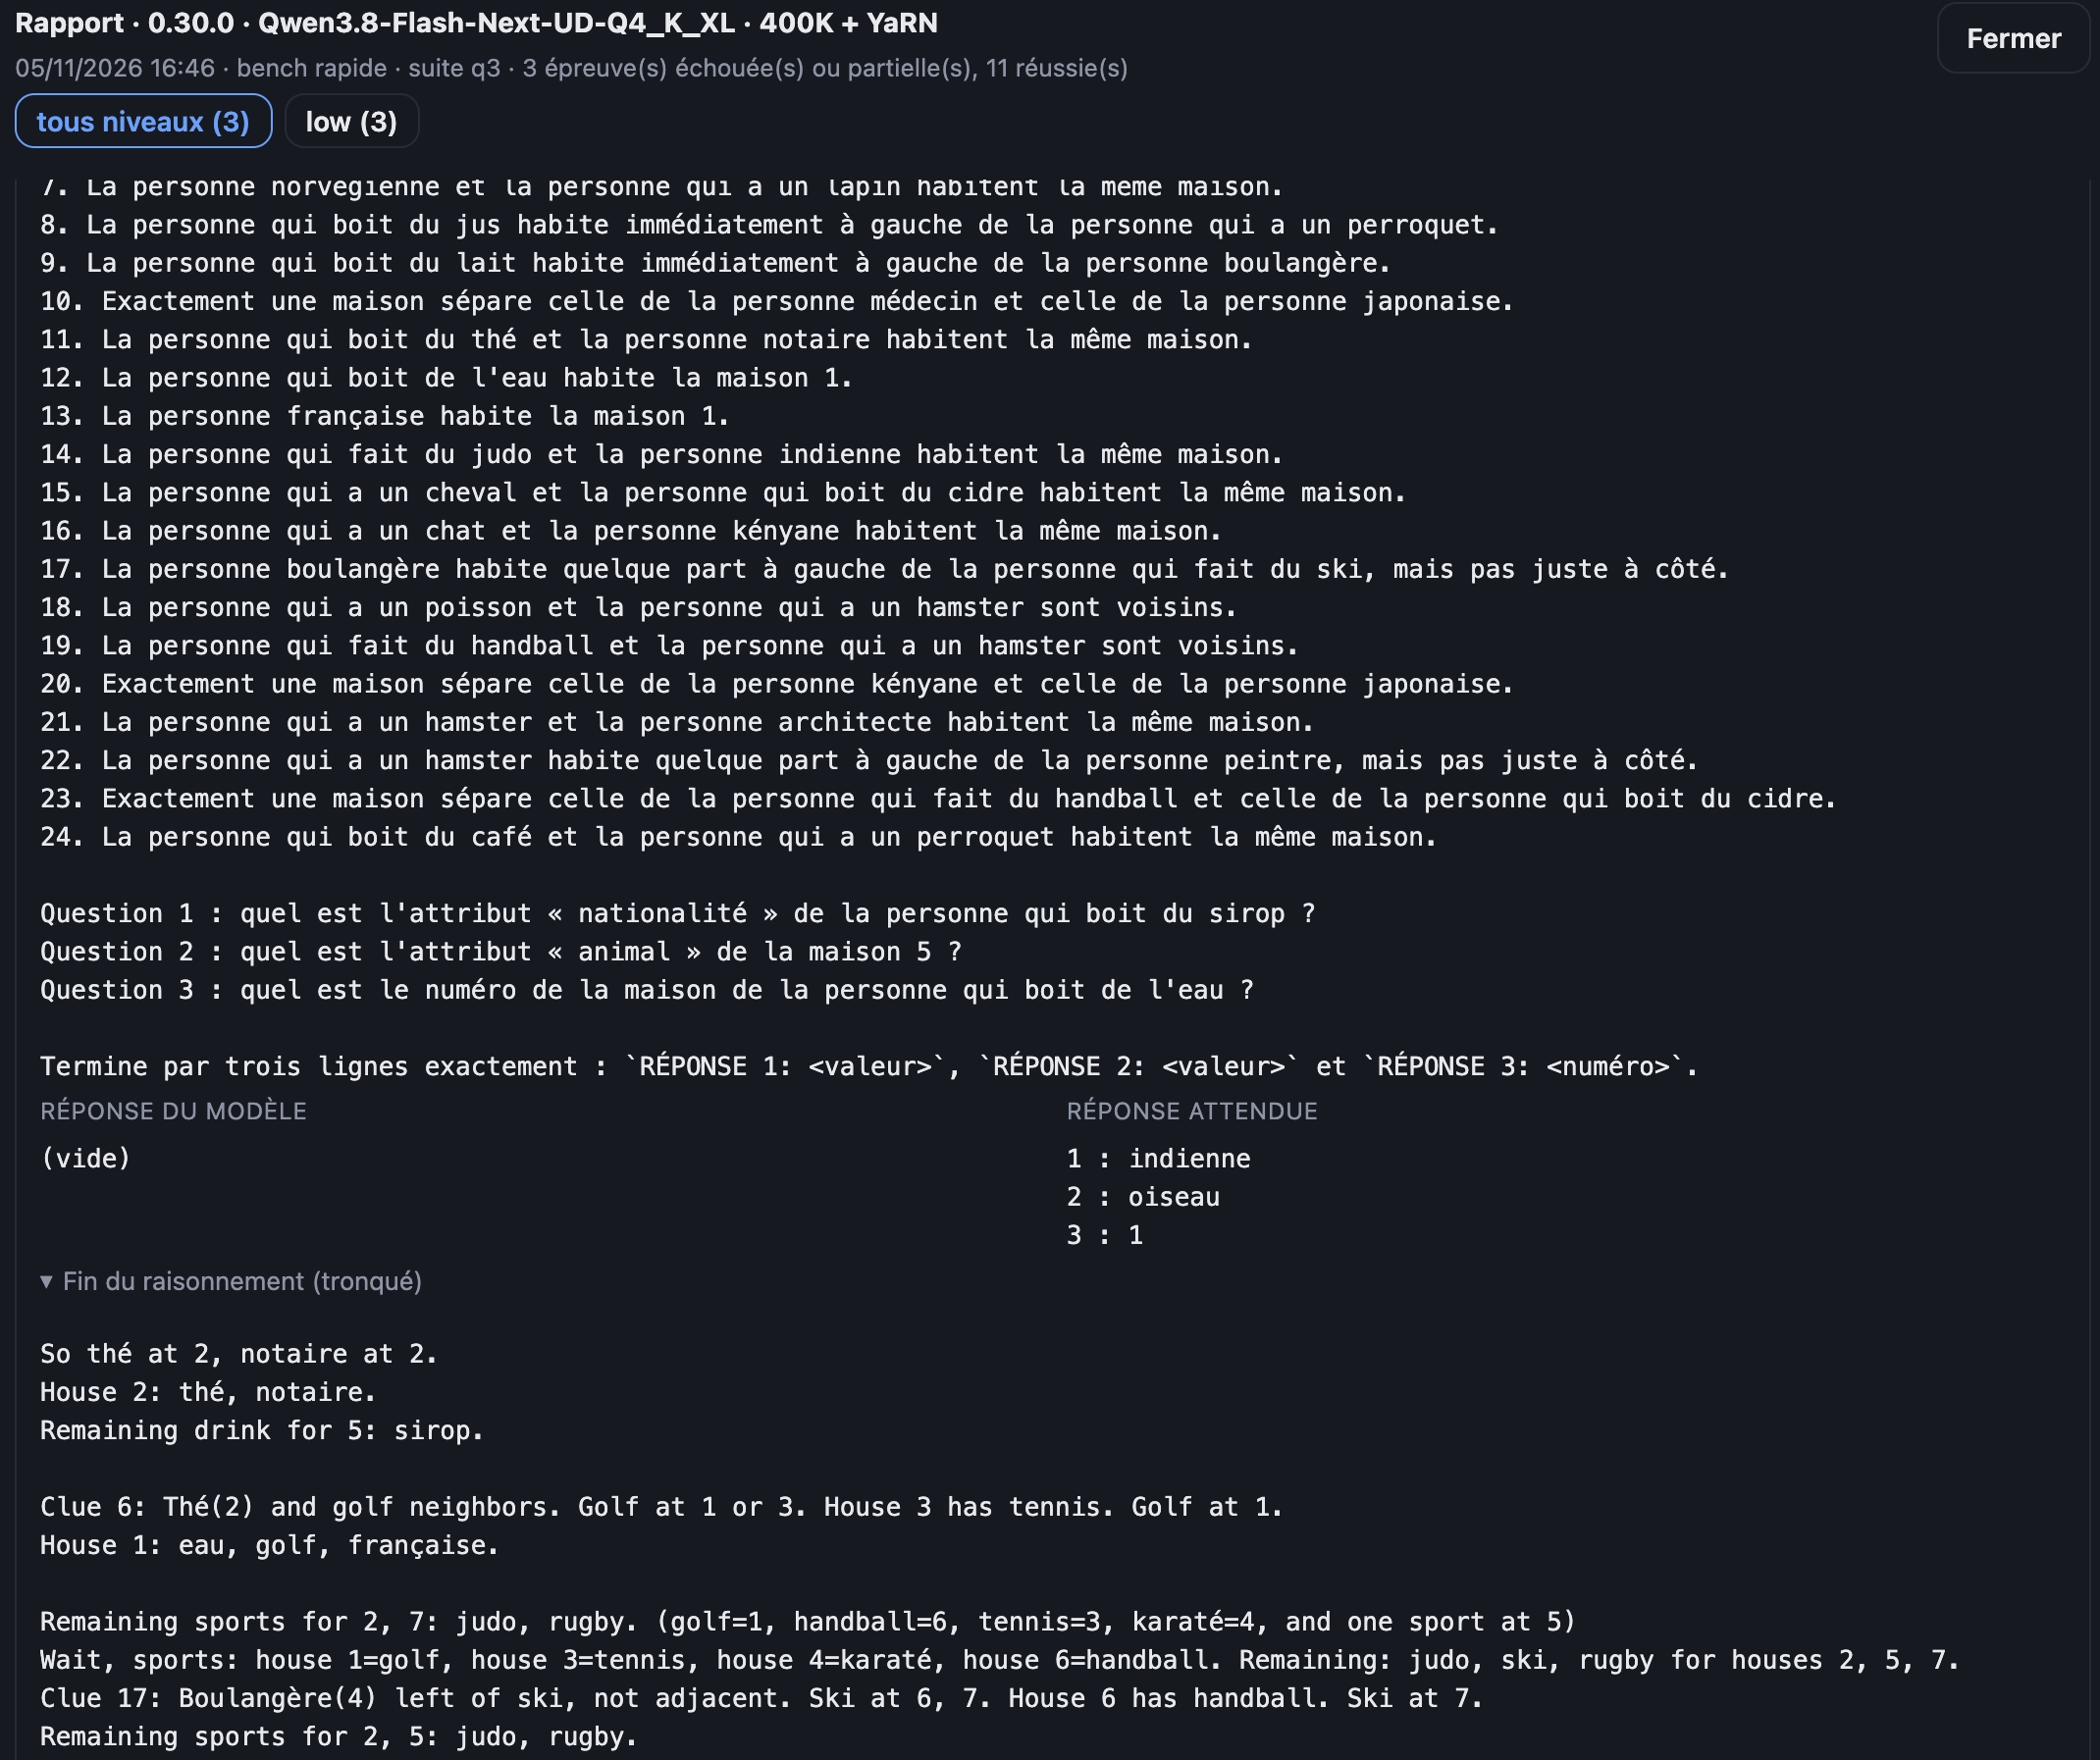
au fait vous faites des benchs pour vos modèles ?
 
je me pose la question pour mieux choisir mes futurs modèles uncensored. Mais avec Claude opus 5.5 qui me sort des tests assez tordus les seuls échecs sont dus au budget max. Je laisse le bench en cours finir mais on est déjà à trois itérations pour trouver le bon milieu :D
 
Je suis fatigué rien qu'en lisant les questions pourtant  :lol:  
 
https://rehost.diberie.com/Picture/Get/f/567840
 
https://rehost.diberie.com/Picture/Get/f/567841
 
https://rehost.diberie.com/Picture/Get/f/567842
 
le test est auto corrigé par un script pour éviter un biais de modèle
 
Je vais laisser finir cette itération et voir si opus arrive à trouver quelque chose d'assez dur :D

n°55748
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 18:12:10  profilanswer
 

moyen_moins a écrit :


:jap:
il y a peut être un vrai gap du coup avec l'iq4_xs alors sans "exploser" la taille  [:paysan]  
edit: par rapport à avant ou c'était pas vraiment le cas


Moi je suis heureux avec Qwen3.8-Flash-Next-GSQ-RCO en Q2 alors si pour la même taille je peux prendre le UD-IQ1 qui lui mets la misère, c'est tout bénèf :D
Bon après un test rapide c'est pas ça, j'ai eu un OOM, mais ya moyen de tuner peut-être.


---------------
Faudra que je teste un jour :o
n°55750
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 18:14:40  profilanswer
 

Nasdaq 100 eyes $1.8 trillion loss as Democratic win sparks AI delay fears
https://www.reuters.com/legal/trans [...] 026-11-05/
 
src: https://www.clubic.com/actualite-63 [...] ement.html :o
 
A moi les A100 à 100 balles et la DDR4 à 4 euro le gigo  :pt1cable:


---------------
Faudra que je teste un jour :o
n°55751
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 18:18:09  profilanswer
 

si je peux arriver au même résultat en cramant moins de jetons... :à
à voir la vitesse de génération mais entre iq4_xs et le gsq-rco ça doit être kif kif
15% de mieux alors qu'avant les benchs les mettaient quasi à égalité pour une taille légèrement plus élevée du unsloth, faut que je teste ce soir.


edit: on dirait que j'ai acheté ma ram trop tôt...
mais présent pour une 2ème R9700 ai pro au mrp initial :o


Message édité par moyen_moins le 05-11-2026 à 18:19:22
n°55766
neo world
Posté le 05-11-2026 à 19:32:38  profilanswer
 

the_fennec a écrit :

Nasdaq 100 eyes $1.8 trillion loss as Democratic win sparks AI delay fears
https://www.reuters.com/legal/trans [...] 026-11-05/
 
src: https://www.clubic.com/actualite-63 [...] ement.html :o
 
A moi les A100 à 100 balles et la DDR4 à 4 euro le gigo  :pt1cable:


oui non les démocrates sont pas exactement pro peuple non plus. Ca va signer des deals en disant que c'est la faute à Trump comme Trump disait que c'était la faute à Biden :D

n°55768
moyen_moin​s
chat réincarné
Posté le 05-11-2026 à 19:55:24  profilanswer
 

Le poc de the_fennec en action : https://youtu.be/reOeczuEzOA  :whistle:

n°55769
XaTriX
Posté le 05-11-2026 à 20:25:26  profilanswer
 

the_fennec a écrit :

Nasdaq 100 eyes $1.8 trillion loss as Democratic win sparks AI delay fears
https://www.reuters.com/legal/trans [...] 026-11-05/
 
src: https://www.clubic.com/actualite-63 [...] ement.html :o
 
A moi les A100 à 100 balles et la DDR4 à 4 euro le gigo  :pt1cable:


J'ai regardé pour rajouter 16Go à un laptop du taf en DDR5-5600, non mais [:rofl]


---------------
[:dawa]
n°55779
neo world
Posté le 05-11-2026 à 22:29:36  profilanswer
 

XaTriX a écrit :


J'ai regardé pour rajouter 16Go à un laptop du taf en DDR5-5600, non mais [:rofl]


c'est devenu n'imp' je confirme. Je pensais m'être fait avoir en commandant en aout 64GO pour 700 balles (  [:astroya:2] ) ... 1200 balles aujourd'hui  [:fraiche gourdin]

n°55780
neo world
Posté le 05-11-2026 à 22:38:11  profilanswer
 

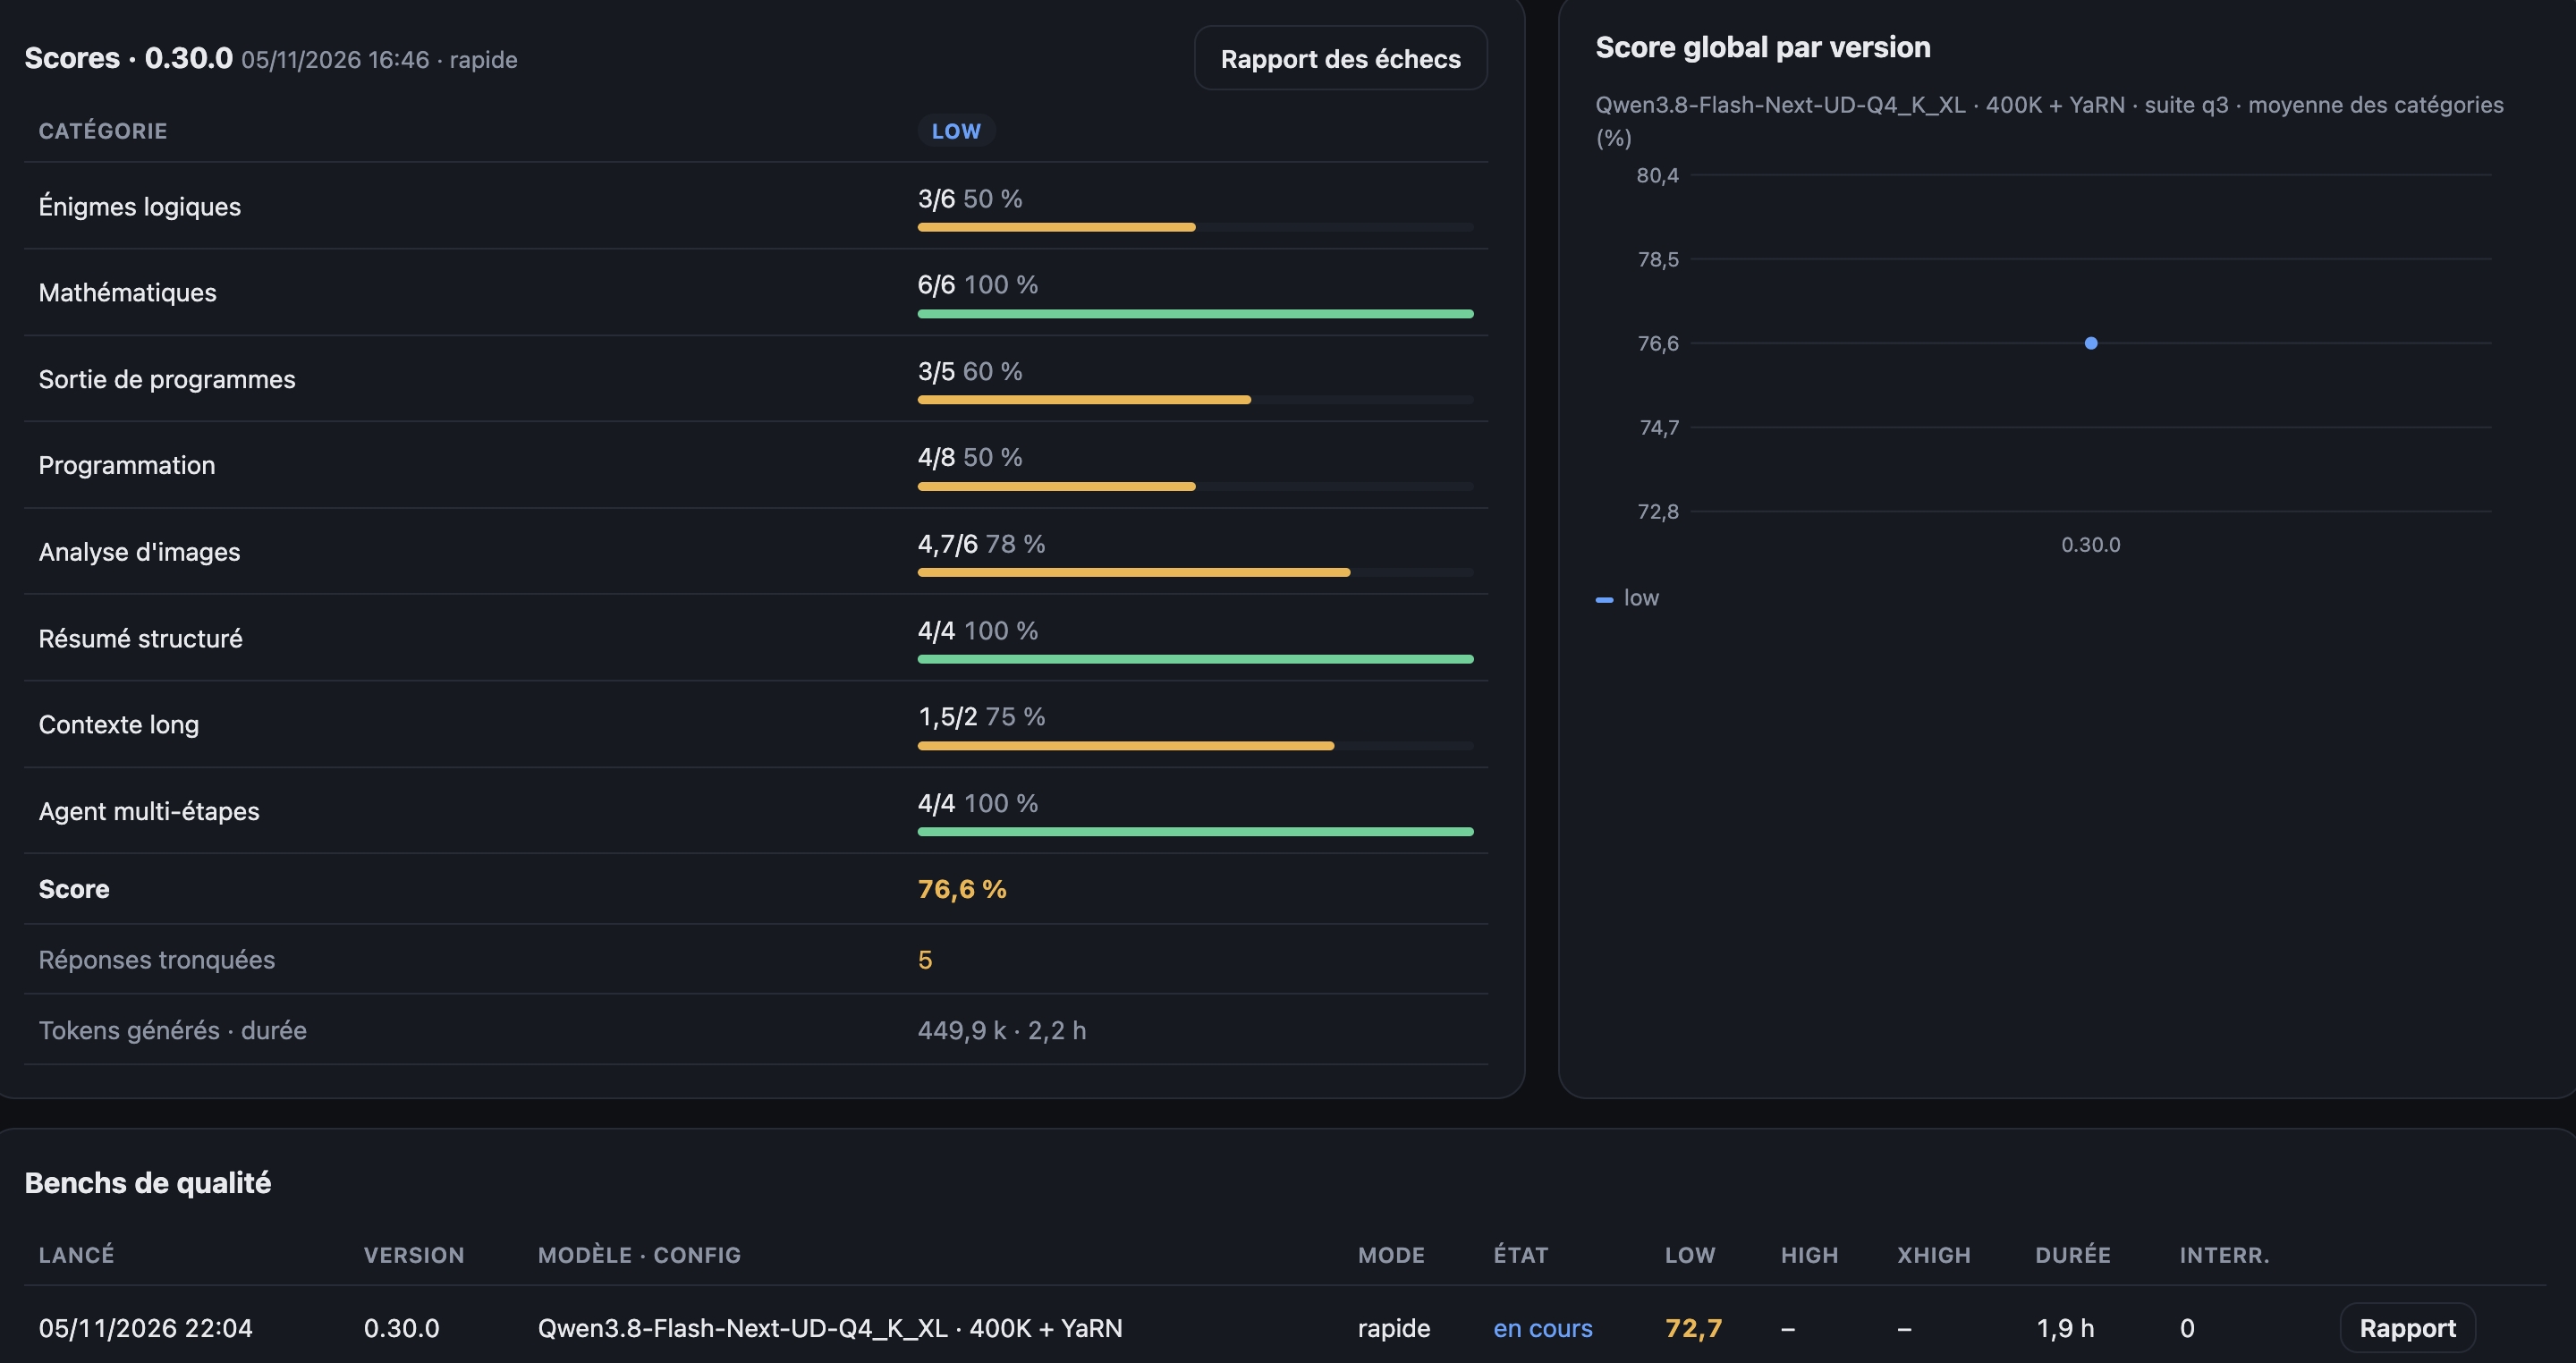
je continue mon histoire de bench automatique :
 

Citation :

Le benchmark compte 68 épreuves en 13 catégories. Toutes sont corrigées par du code, jamais par le modèle, avec crédit partiel. Les questions sont les mêmes à chaque run, pour pouvoir comparer versions et niveaux de réflexion.
 
Raisonnement pur
 
Énigmes logiques (6) : grilles de type zèbre de 6 à 7 maisons, chevaliers et menteurs à 12 personnes, plan de table. Mesure la déduction sous contraintes et la capacité à tenir un long raisonnement sans se perdre.
Mathématiques (8) : dénombrement, arithmétique modulaire, probabilités, récurrences, théorie des jeux. Résultats exacts attendus. Mesure la rigueur du calcul et la capacité à trouver la bonne méthode plutôt qu’une approximation.
Sortie de programmes (5) : prédire ce qu’affiche un programme sans l’exécuter. Mesure l’exécution mentale et l’attention aux détails : ordre d’évaluation, effets de bord.
 
Code
 
Programmation Python (8) : évaluateur d’expressions, mini-interpréteur, regex sans le module re, sudoku, diff, intervalles… Chaque épreuve passe trois groupes de tests : base, cas limites, difficiles ou performance. Mesure la justesse, la robustesse et la complexité algorithmique.
Rust (5) : cache LRU, décodeur RLE, évaluateur… Mesure si le code compile du premier coup (emprunts, types) et s’il gère bien débordements et performance.
Front JavaScript (5) : rendu de tableau HTML (échappement, format des nombres français), réducteur de panier, debounce, validation de formulaire, mise à jour minimale d’une liste dans le DOM. Mesure la précision sur les petits détails qui font les bugs d’interface.
Débogage (6), en Python, Bash et Rust : le modèle reçoit le code et la vraie sortie d’erreur, puis doit rendre le fichier corrigé. Mesure s’il remonte à la cause réelle plutôt qu’au symptôme ; un second bug caché est vérifié par des tests.
 
Agents et outils
 
Agent multi-étapes (4) : corriger un petit dépôt à l’aide des outils lire, écrire et lancer les tests, pour que des tests cachés passent. Mesure l’autonomie : lire la spec, tester, itérer, s’arrêter au bon moment.
Outils MCP (4) : CRM, agenda, documents, boutique simulés, jugés sur l’état final des serveurs. Mesure l’usage fiable des API : pagination, nouvel essai après erreur 503 ou 429, idempotence après une erreur 504, fuseaux horaires, aucune action en trop.
Commandes Linux (5) : scripts shell jugés sur leur sortie et les fichiers produits. Les fichiers contiennent des pièges réels : .gz, espaces dans les noms, fins de ligne Windows, modification d’un INI en place, fuseaux mêlés. Mesure la robustesse face aux données du terrain.
 
Lecture et compréhension
 
Analyse d’images (6) : graphiques, tableaux, horloge, graphe et labyrinthe dessinés avec des valeurs connues. Mesure la précision de lecture visuelle.
Résumé structuré (4) : consolider une suite de comptes rendus de réunion (ajustements de budget, erratum, changements de rôle) en un état final au format JSON. Mesure le suivi des mises à jour successives et le respect du format.
Contexte long (2) : journaux de 250K et 310K tokens où des faits ont été placés, avec 6 questions de recherche et d’agrégation. Mesure ce que le modèle exploite vraiment sur un contexte de 400K tokens étendu par YaRN.
 
Le score par niveau est la moyenne des catégories, chacune pesant autant quel que soit son nombre d’épreuves. Une réponse qui dépasse 65 536 tokens compte comme ratée.


j'ai essayé de le rendre assez complet en prenant en compte le système / debug / codage en Rust / Python / Bash en plus de la partie logique / Maths and co.
 
Le premier run n'est pas encore fini mais y'a trois modes de bench :
- rapide d'environ deux heures en thinking low uniquement
- semi rapide en low, high xhigh. Une epreuve réussie dans un mode thinking inférieure est réputée réussie en thinking sup
- lent où il rejoue tous les tests
 
https://rehost.diberie.com/Picture/Get/f/567995
 
l'idée n'est pas de remplacer un vrai bench (plus complet / éprouvé / fait pas des experts) mais seulement de valider si y'a des pertes catastrophiques suite à un nouveau parametrage / utilisation d'un modèle trop beau pour être vrai / uncensored malheureux avant qu'il ne puisse toucher la codebase  :jap:
 
p'tit subtilité : mécanisme d'arrêt du bench en cours en cas de soumission réelle de tâches et reprise des benchs suivants après 10 minutes d'inactivité


Message édité par neo world le 05-11-2026 à 22:42:00
n°55781
the_fennec
f3nn3cUs z3rd4
Posté le 05-11-2026 à 22:49:04  profilanswer
 

neo world a écrit :

oui non les démocrates sont pas exactement pro peuple non plus. Ca va signer des deals en disant que c'est la faute à Trump comme Trump disait que c'était la faute à Biden :D


Laisse moi rêver :o
 

moyen_moins a écrit :

Le poc de the_fennec en action : https://youtu.be/reOeczuEzOA  :whistle:


https://github.com/orailnoor/cross-platform-llm-client
 

Citation :

The app uses llama_flutter_android, a custom Flutter plugin wrapping llama.cpp for ARM64 devices.


[:caleb2000]
 

XaTriX a écrit :

J'ai regardé pour rajouter 16Go à un laptop du taf en DDR5-5600, non mais [:rofl]


Pour rappel, commande de 2023:
https://i.imgur.com/aIoHM2n.png


---------------
Faudra que je teste un jour :o
n°55782
neo world
Posté le 05-11-2026 à 23:16:21  profilanswer
 

Citation :

The app uses llama_flutter_android, a custom Flutter plugin wrapping llama.cpp for ARM64 devices.


[:caleb2000]
 
[/quotemsg]
je le trouve assez intéressant moi : facile à mettre en place avec l'onboarding par QR code & cross platform. Si je changeais de tel tous les ans (5 ans à la maison  :whistle: ) clairement il y avait moyen de monter un cluster ultra économique :D

n°55784
crazytiti
http://crazytiti.free.fr/
Posté le 05-11-2026 à 23:21:17  profilanswer
 

Un truc me chiffone : un vieux Tel c'est plus puissant qu'un PC core i5 de ya 3 ans avec son igpu moisi ?


Mon collègue du systeme au boulot dispose d'au moins 25 vieux PC qu'on pourrait tous brancher pour rigoler avec un llm local :bounce:

Message cité 1 fois
Message édité par crazytiti le 05-11-2026 à 23:22:26

---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°55788
neo world
Posté le 05-11-2026 à 23:33:34  profilanswer
 

crazytiti a écrit :

Un truc me chiffone : un vieux Tel c'est plus puissant qu'un PC core i5 de ya 3 ans avec son igpu moisi ?
 
Mon collègue du systeme au boulot dispose d'au moins 25 vieux PC qu'on pourrait tous brancher pour rigoler avec un llm local :bounce:


le tel a de la mémoire unifiée (accessible par le GPU) en LPDDR5X pour les modèles moyen/haut de gamme. Et ca llama.cpp aime  :love:  
 
25 vieux PC c'est parfait pour de l'agent swarm avec quelques modèles tout petits / embeddings intégrés dedans (le CPU chauffera mais ça restera utilisables). Dés que tu vas distribuer la charge entre PC tu vas rajouter au problème de départ (mémoire pas très rapide + pas de GPU ou ne supportant pas les tensor nativement) un nouveau : bande passante faible entre PC et latences super élevées (quelques centaines de micro secondes c'est super long à l'échelle d'un modèle).
 
Par contre si les CPU supportaient AVX clairement il y avait un coup à jouer :D

 Page :   1  2  3  4  5  ..  94  95  96  97  98  99

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)