Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4539 connectés 


Gorgon Halo ...
Sondage à 2 choix possibles.


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  98  99  100  101  102  103
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°56359
Pipould's
Posté le 10-11-2026 à 13:58:34  profilanswer
 

Reprise du message précédent :

moyen_moins a écrit :

qwen 3.8FN en iq1m ou gyro m ou s je dirais :)


C'est completement eclate au sol...  
 
Du iq1m tu dois etre bon sur les premiers 30k tokens mais en usage pro c'est tight...

n°56363
moyen_moin​s
chat réincarné
Posté le 10-11-2026 à 14:10:21  profilanswer
 

peut être mais les gyro ont pas l'air si dégueux [:paysan]

n°56380
crazytiti
http://crazytiti.free.fr/
Posté le 10-11-2026 à 15:05:01  profilanswer
 

neo world a écrit :


Ah non ! C’est un produit de ta quantisation * taille de contexte consommé. En 500k M XL t’es probablement aux environs de 8 / 10GB...


Ok merci et exemple concret avec mon qwen 3.8 en iq2_xs ?
Par défaut ya 128k et je suis assez vite arrivé au bout avec mes petits probleme alacon.
Donc je suis passé à 192 et là il compacte plus rarement, mais si je peux mettre 256 ou 512 sans souci alors voila ...
 
Pour info qwen 3.8 iq2xs tout fonctionnel avec strata et opencode lancé bouffe ~56go sur mes 64 (sous windows) donc j'ai encore un peu de rab pour faire des trucs.


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°56381
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 15:12:34  profilanswer
 

neo world a écrit :

Pas mal, attention avec le swap quand même : en lecture tout va bien, en écriture massive ça va user la flash assez rapidement :jap:


Oui c'est pour ça que je surveille le swap, et surtout le tg/prefill se casse la gueule des qu'on touche le swap, c'est qu'un SDD Stata (monté sur un share samba en plus :D).
 

moyen_moins a écrit :


j'arrive pas à dépasser 30Go de pris sur 32Go, c'est même pas une carte qui gère l'affichage.
ou c'est encore la faute à Windows :/
oui, sorcellerie :o


C'est Strata qui réserve des GB pour rien, moi j'ai mis ça et j'arrive a 100% de VRAM, en dessous ça crash:

Code :
  1. "--vram-reserve-mib",
  2.   "300",


Pipould's a écrit :


Quel model ?  


unsloth-ud-iq1_m
 

Pipould's a écrit :


C'est completement eclate au sol...  
 
Du iq1m tu dois etre bon sur les premiers 30k tokens mais en usage pro c'est tight...


Je fais avec ce que j'ai, Unsloth done iq1m pas loin du iq3s GSQ-RCO:
https://unsloth.ai/docs/basics/dyna [...] flash-next
 
Je me tâte même à passer en iq1s pour garder le contexte de 512K sans swap :love:
 
Je l'ai pas encore mis sur un gros truc, mais RCO Q2 et Gyro-S on largement fait le taf sur mon layer Vulkan. Donc l'étape d'après c'est de lui faire ajouter le support de Vulkan sur Strata pour pouvoir ajouter mes BC250 en plus :o


---------------
Faudra que je teste un jour :o
n°56390
crazytiti
http://crazytiti.free.fr/
Posté le 10-11-2026 à 15:34:37  profilanswer
 

crazytiti a écrit :

Bon clairement je n'ai pas du utiliser la bonne méthode :
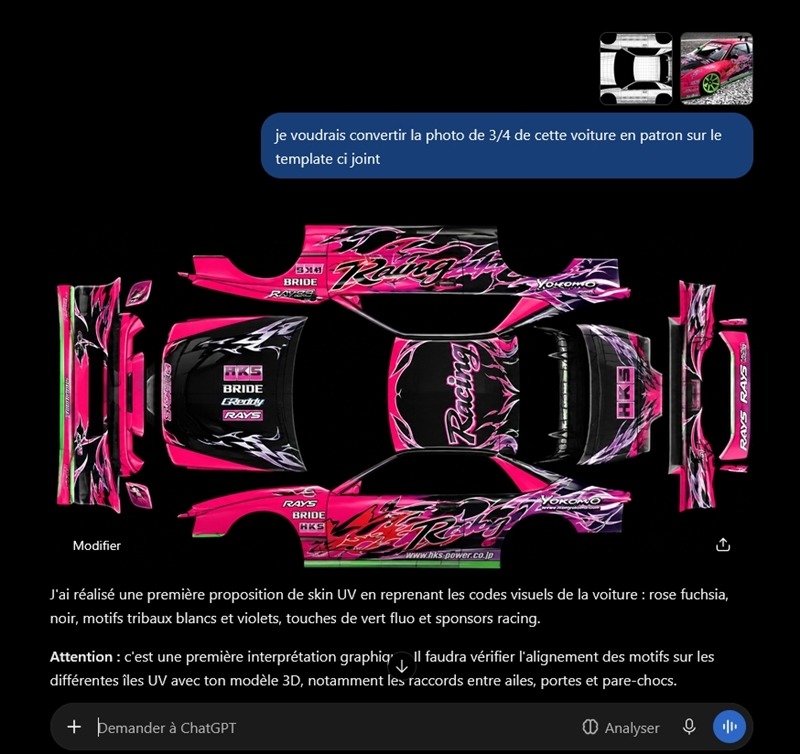
Je veux refaire, sans me fouler, une déco de carro IRL en skin sur beamNG....


Chatgpt 1 prompt d'une ligne, même pas 30sec de reflexion.
Comment je fais pour avoir le même à la maison ?
https://rehost.diberie.com/Picture/Get/r/569270

Message cité 2 fois
Message édité par crazytiti le 10-11-2026 à 15:34:59

---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°56393
xenom
Plaquettes chaussettes
Posté le 10-11-2026 à 15:38:41  profilanswer
 

Pfiou j'ai comparé sur mon Mac splash à strata sur le même Q3.8 FN Q2, ça va nettement plus vite sur splash.

Message cité 1 fois
Message édité par xenom le 10-11-2026 à 17:06:37
n°56404
crazytiti
http://crazytiti.free.fr/
Posté le 10-11-2026 à 16:41:25  profilanswer
 

sur amd aussi ?


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°56406
xenom
Plaquettes chaussettes
Posté le 10-11-2026 à 17:06:19  profilanswer
 

edited :o

n°56412
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 17:18:57  profilanswer
 

crazytiti a écrit :

Chatgpt 1 prompt d'une ligne, même pas 30sec de reflexion.
Comment je fais pour avoir le même à la maison ?
https://rehost.diberie.com/Picture/Get/r/569270


ComfyUI
 
Un LLM c'est fait pour faire du code, pas de l'édition d'image.


---------------
Faudra que je teste un jour :o
n°56414
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 17:19:52  profilanswer
 

xenom a écrit :

Pfiou j'ai comparé sur mon Mac splash à strata sur le même Q3.8 FN Q2, ça va nettement plus vite sur splash.


Strata sur Mac?


---------------
Faudra que je teste un jour :o
n°56423
xenom
Plaquettes chaussettes
Posté le 10-11-2026 à 17:45:09  profilanswer
 

qu'est ce qui est pas clair dans "Mac", ok la premiere fois je l'avais oublié dans mon message :o

Message cité 1 fois
Message édité par xenom le 10-11-2026 à 17:45:35
n°56424
moyen_moin​s
chat réincarné
Posté le 10-11-2026 à 17:46:12  profilanswer
 

the_fennec a écrit :


Je fais avec ce que j'ai, Unsloth done iq1m pas loin du iq3s GSQ-RCO:
https://unsloth.ai/docs/basics/dyna [...] flash-next
 
Je me tâte même à passer en iq1s pour garder le contexte de 512K sans swap :love:
 
Je l'ai pas encore mis sur un gros truc, mais RCO Q2 et Gyro-S on largement fait le taf sur mon layer Vulkan. Donc l'étape d'après c'est de lui faire ajouter le support de Vulkan sur Strata pour pouvoir ajouter mes BC250 en plus :o


ça peut se mélanger du vulkan, du cuda/rocm ? [:paysan]

n°56425
moyen_moin​s
chat réincarné
Posté le 10-11-2026 à 17:47:08  profilanswer
 

crazytiti a écrit :


Chatgpt 1 prompt d'une ligne, même pas 30sec de reflexion.
Comment je fais pour avoir le même à la maison ?
https://rehost.diberie.com/Picture/Get/r/569270


demande à chatgpt de te refaire un prompt détaillé pour arriver à ce même résultat ?

n°56445
crazytiti
http://crazytiti.free.fr/
Posté le 10-11-2026 à 19:18:22  profilanswer
 

:lol:


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°56447
neo world
Posté le 10-11-2026 à 19:24:19  profilanswer
 

we need to go deeper  [:mr mala:1] :D
 
sinon je sais plus qui m'avait demandé mais 500k de contexte en Q8 : environ 6,8 Go
 
voilà désolé j'avais posé la question à claude mais je me suis fait choper par mon travail dans la foulée et celui là paye mes factures :o


Message édité par neo world le 10-11-2026 à 19:24:27
n°56454
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 19:48:25  profilanswer
 

xenom a écrit :

qu'est ce qui est pas clair dans "Mac", ok la premiere fois je l'avais oublié dans mon message :o


Quel intérêt de faire tourner Strata sur un système à mémoire unifiée?


---------------
Faudra que je teste un jour :o
n°56455
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 19:51:16  profilanswer
 

moyen_moins a écrit :


ça peut se mélanger du vulkan, du cuda/rocm ? [:paysan]


Oui, pas de soucis, j'ai posté un screen de llama.cpp avec ma 4060Ti en CUDA et les deux BC250 en Vulkan (via Spock/TCP).
 
Vulkan, CUDA et ROCm sont juste des SDKs pour parler au hardware, on peut très bien les mixer.


---------------
Faudra que je teste un jour :o
n°56458
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 20:07:39  profilanswer
 

Bon ben avec 300k de contexte en Yarn je swap pas, et ça marche nickel!
J'ai fait un test needle sur 285KB de contexte et tout est bon.
 
Je vais quand même tester IQ1_S avec 512k pour le fun!


---------------
Faudra que je teste un jour :o
n°56462
neo world
Posté le 10-11-2026 à 20:39:10  profilanswer
 

Éternel insatisfait :o

n°56468
xenom
Plaquettes chaussettes
Posté le 10-11-2026 à 22:37:33  profilanswer
 

the_fennec a écrit :


Quel intérêt de faire tourner Strata sur un système à mémoire unifiée?


Bonne question :o faudrait demander au développeur qui prévoit un flavor Mac  [:cosmoschtroumpf]

n°56471
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 22:48:02  profilanswer
 

neo world a écrit :

Éternel insatisfait :o


Je me dis peut être le million :o
 

xenom a écrit :


Bonne question :o faudrait demander au développeur qui prévoit un flavor Mac  [:cosmoschtroumpf]


L’intérêt de Strata est de déplacer les experts de RAM en VRAM au besoin et de garder les moins utilisé en RAM pour utiliser le CPU pour ceux-la. Sur un Mac tout ce merdier n'a aucun intérêt vu que c'est de la RAM unifiée.


---------------
Faudra que je teste un jour :o
n°56473
neo world
Posté le 10-11-2026 à 22:53:26  profilanswer
 

the_fennec a écrit :


Je me dis peut être le million :o


c'est ce qu'on se dit tous avant de de remettre une louche de bc250 pour monter d'un bit en quand. Mais promis c'est la dernière :o
 

the_fennec a écrit :


L’intérêt de Strata est de déplacer les experts de RAM en VRAM au besoin et de garder les moins utilisé en RAM pour utiliser le CPU pour ceux-la. Sur un Mac tout ce merdier n'a aucun intérêt vu que c'est de la RAM unifiée.


y'a pet être un sujet avec le nvme (mais j'ai pas du tout regardé le projet et j'ai déjà cramé 40% de mon budget en tokens alors qu'on est que mardi :o

n°56474
the_fennec
f3nn3cUs z3rd4
Posté le 10-11-2026 à 22:59:39  profilanswer
 

neo world a écrit :


c'est ce qu'on se dit tous avant de de remettre une louche de bc250 pour monter d'un bit en quand. Mais promis c'est la dernière :o


Ben oui, c'est le but final, Strata plus rapide c'est juste une étape :D
 

neo world a écrit :

y'a pet être un sujet avec le nvme (mais j'ai pas du tout regardé le projet et j'ai déjà cramé 40% de mon budget en tokens alors qu'on est que mardi :o


Je pense qu'il y a des moteurs mieux adaptés aux archi UMA et au débit de malade des SSDs de Macs.


---------------
Faudra que je teste un jour :o
n°56476
xenom
Plaquettes chaussettes
Posté le 10-11-2026 à 23:35:26  profilanswer
 

the_fennec a écrit :


L’intérêt de Strata est de déplacer les experts de RAM en VRAM au besoin et de garder les moins utilisé en RAM pour utiliser le CPU pour ceux-la. Sur un Mac tout ce merdier n'a aucun intérêt vu que c'est de la RAM unifiée.


Ouai j'avoue qu'en étant sur le bon repo à la mode j'imaginais un peu que ca augmentait les chances de trucs malins de la commu pour cette archi spécifique. Et effectivement ca store sur le ssd mais c'est moins performant.

n°56480
neo world
Posté le 11-11-2026 à 00:40:04  profilanswer
 

Pour info, le budget alloué à la réflexion peut être poussé assez haut pour obtenir des résultats de meilleurs qualité avec Qwen 3.8 flash next Q4 K XL :  
En thinking low le sweetspot est entre 8 et 16k de budget pour une réponse à des problèmes complexes
En thinking medium le sweespot est plutôt entre 16 et 32k (au delà il résous très mal des problèmes plus complexes. Vous cramez des tokens pour rien)
En thinking xhigh sky is the limit, il arrive à me résoudre des problèmes avec des budgets un peu dingues à 262k (pour l'instant la réponse, réussie, la plus longue lui a pris 100099 tokens)
 
à noter que le thinking s’interrompt de lui même en low à 54k tokens (pas de production de réponse) et 66k tokens en medium (même sanction). Pas observé de réponse interrompue en xhigh.
 
Bref sur du conversationnel la limite à 8k qu'on voit généralement fait sens (vas y répond là ! j'ai pas toute la journée ! :o ) mais sur du coding velu 100k en xhigh c'est pas idiot du tout :D

n°56497
speedboyz3​0
Guide Michelin :o
Posté le 11-11-2026 à 09:20:59  profilanswer
 

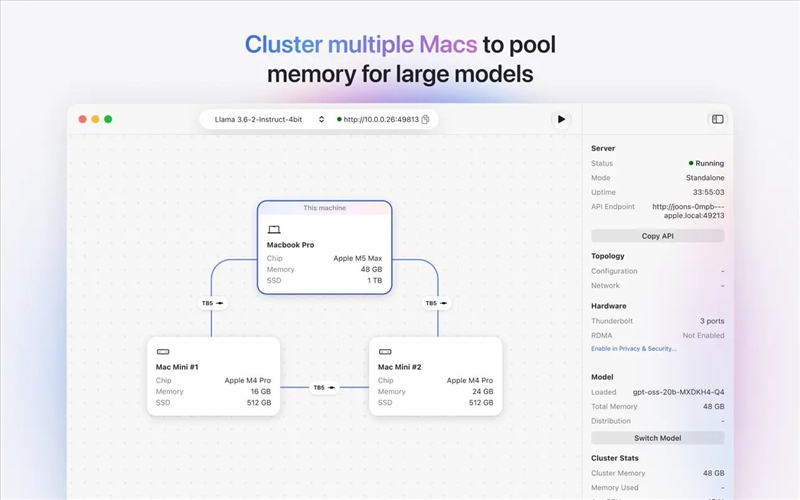
Apple va sortir Harbor, actuellement en bêta privée.


L'idée est plutôt sympa : transformer un Mac (Apple Silicon) en serveur IA locale.
Téléchargement et gestion des modèles directement dans l'application, sans ligne de commande.


Mais surtout, Harbor permet de connecter plusieurs Mac en Thunderbolt 5 pour mutualiser leur mémoire et leur puissance de calcul.


À voir ce que ça donnera face à oMLX/llama.cpp, notamment en termes de performances et de compatibilité des modèles.


Source : https://9to5mac.com/2026/11/10/appl [...] dels-easy/


https://rehost.diberie.com/Picture/Get/r/569444


Message édité par speedboyz30 le 11-11-2026 à 09:22:43
n°56519
neo world
Posté le 11-11-2026 à 11:44:14  profilanswer
 

faudra voir en effet mais ça va rendre la création de clusters hétérogènes plus facile. Par contre faudra que tout soit côte à côte (ou trouver du tb5 en fibre optique ?) :D

n°56531
moyen_moin​s
chat réincarné
Posté le 11-11-2026 à 13:35:04  profilanswer
 

the_fennec a écrit :


Oui, pas de soucis, j'ai posté un screen de llama.cpp avec ma 4060Ti en CUDA et les deux BC250 en Vulkan (via Spock/TCP).
 
Vulkan, CUDA et ROCm sont juste des SDKs pour parler au hardware, on peut très bien les mixer.


intéressant [:paysan]

n°56541
speedboyz3​0
Guide Michelin :o
Posté le 11-11-2026 à 15:08:55  profilanswer
 

Clairement maintenant je veux upgrade mon macbook air par un pro en TB5. Pas besoin, mais justement c'est ce qui est intéressant :o

n°56576
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 17:38:49  profilanswer
 

Unsloth ajoute 27B et DS4 en UD 3.1:
https://unsloth.ai/docs/basics/dyna [...] -3.1-ggufs


---------------
Faudra que je teste un jour :o
n°56604
moyen_moin​s
chat réincarné
Posté le 11-11-2026 à 18:59:53  profilanswer
 

c'est bizarre, le iq4_xs est toujours derrière le q3_k_xl on dirait, il sous performe à chaque fois !

n°56609
neo world
Posté le 11-11-2026 à 19:21:14  profilanswer
 

je pense qu'il doit y avoir des artefacts dans la manière de faire le bench vs la méthode de quantification.
 
Si on lit bien les benchs le IQ2 XXS de Deepseek flash 4.1 est meilleur à 3 des 4 benchmarks que la version Q8 (baseline). J'entends que les arrondis sont pas mortels mais ça montre bien qu'on a un peu de boulot pour bien évaluer ou alors on va tous finir par abandonner BF16 pour IQ2 pour gap gratuit de perfs sans rien réentrainer  :lol:
 
https://unsloth.ai/docs/~gitbook/image?url=https%3A%2F%2F3215535692-files.gitbook.io%2F%7E%2Ffiles%2Fv0%2Fb%2Fgitbook-x-prod.appspot.com%2Fo%2Fspaces%252FxhOjnexMCB3dmuQFQ2Zq%252Fuploads%252Fe3HYFau6qEpkFwkLVwru%252FCoder%2520benchmark.png%3Falt%3Dmedia%26token%3D59e2ab09-3f42-4226-bd03-3b5a8d109e6a&width=768&dpr=3&quality=100&sign=a3dbca3901c80cb23a384165bd6b27f6&sv=3

n°56619
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 20:11:30  profilanswer
 

Un quant dynamique boost certains layers et en nerf d'autres en fonction du "post training", donc c'est pas impossible d'avoir de meilleurs résultats aux benchs, c'est juste une forme de benchmaxing comme le fine-tuning. Faudrait voir ce que ça donne sur des benchs non-publiques; ou juste d'autres qu'Unsoth n'a pas utilisé.


---------------
Faudra que je teste un jour :o
n°56626
neo world
Posté le 11-11-2026 à 20:48:21  profilanswer
 

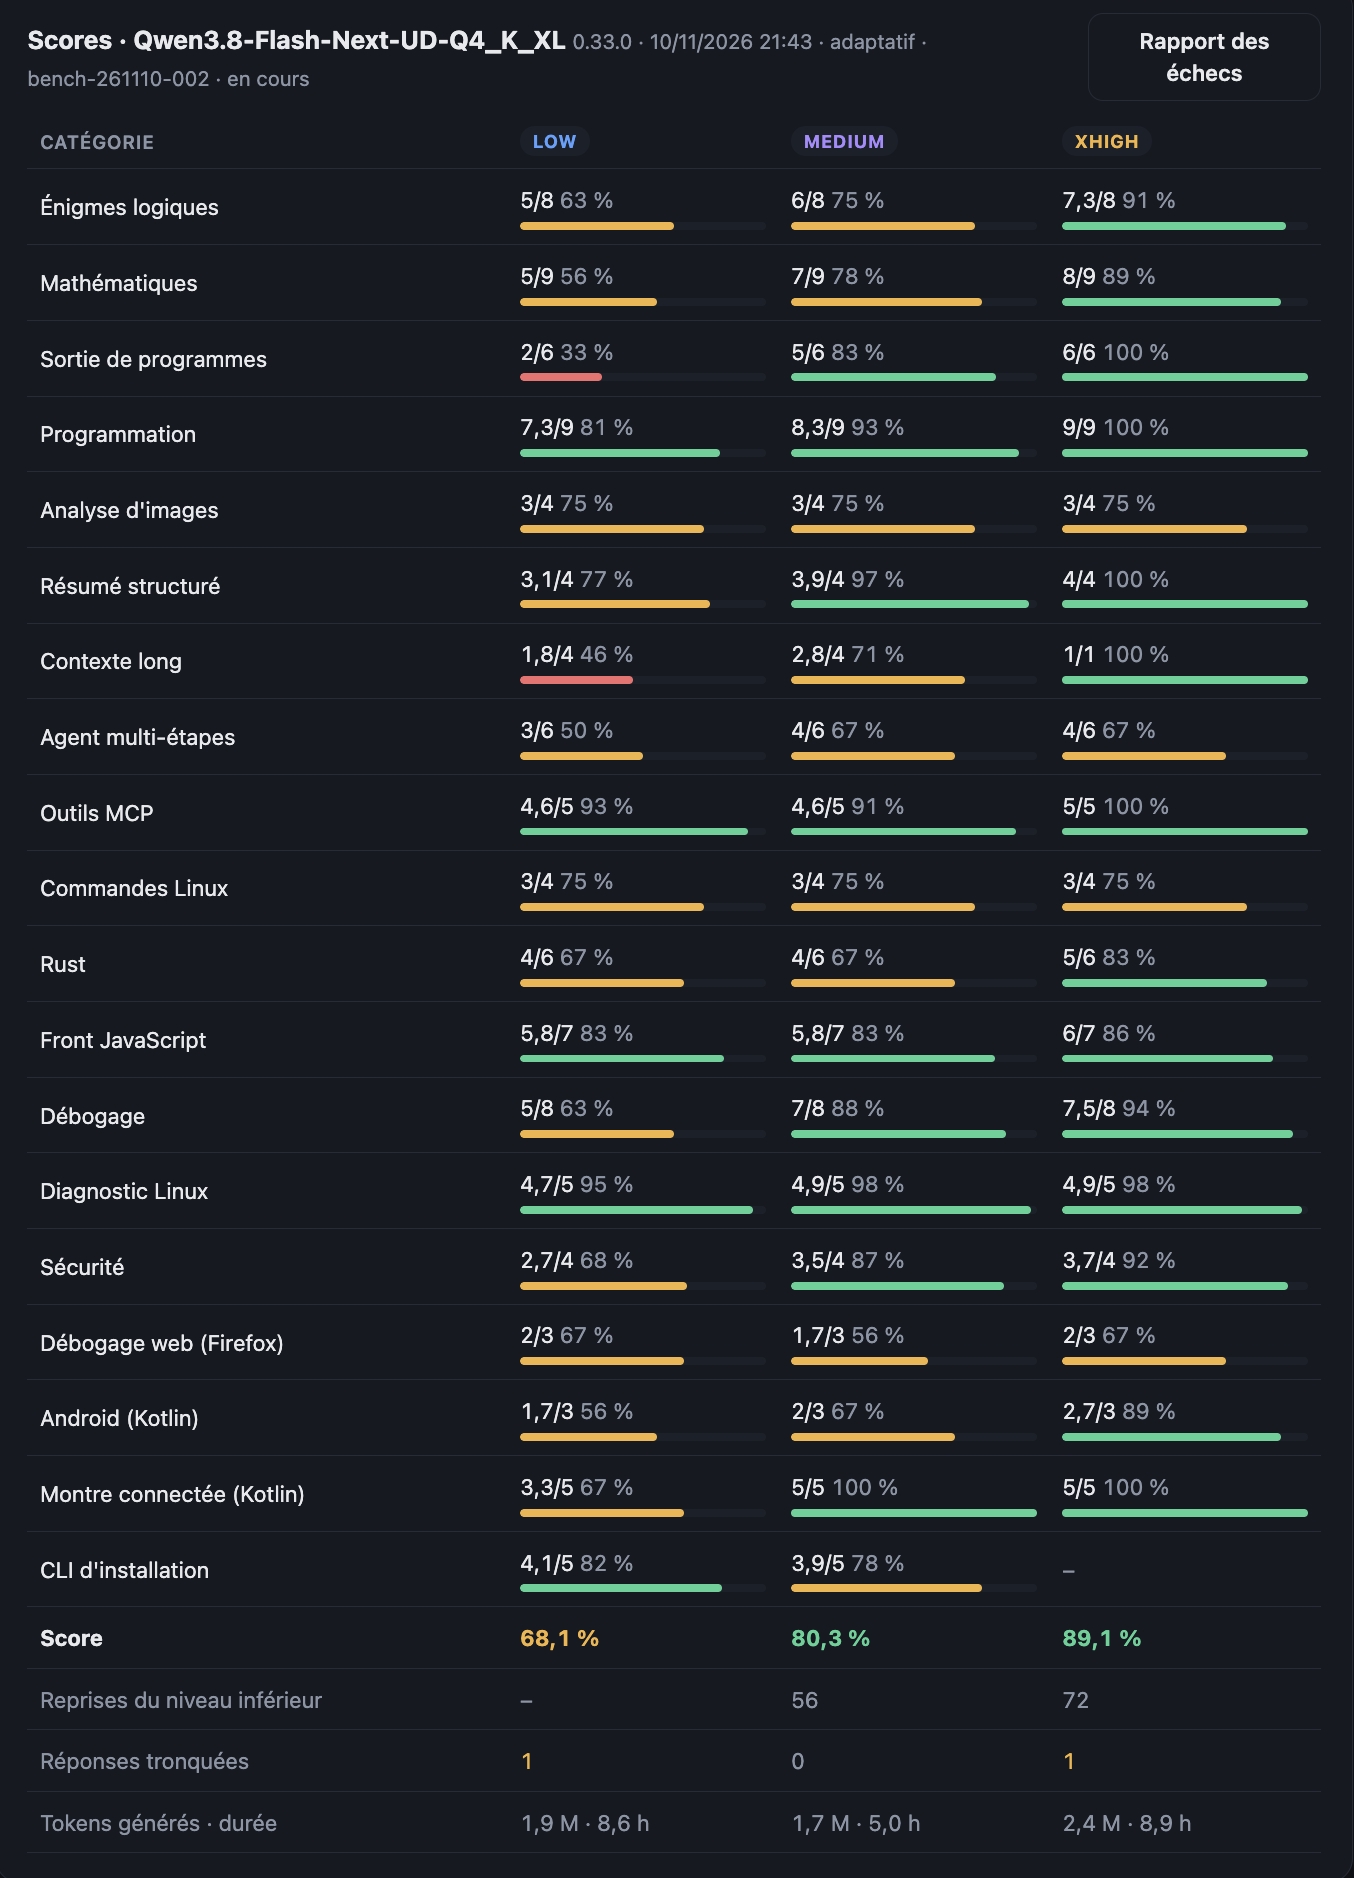
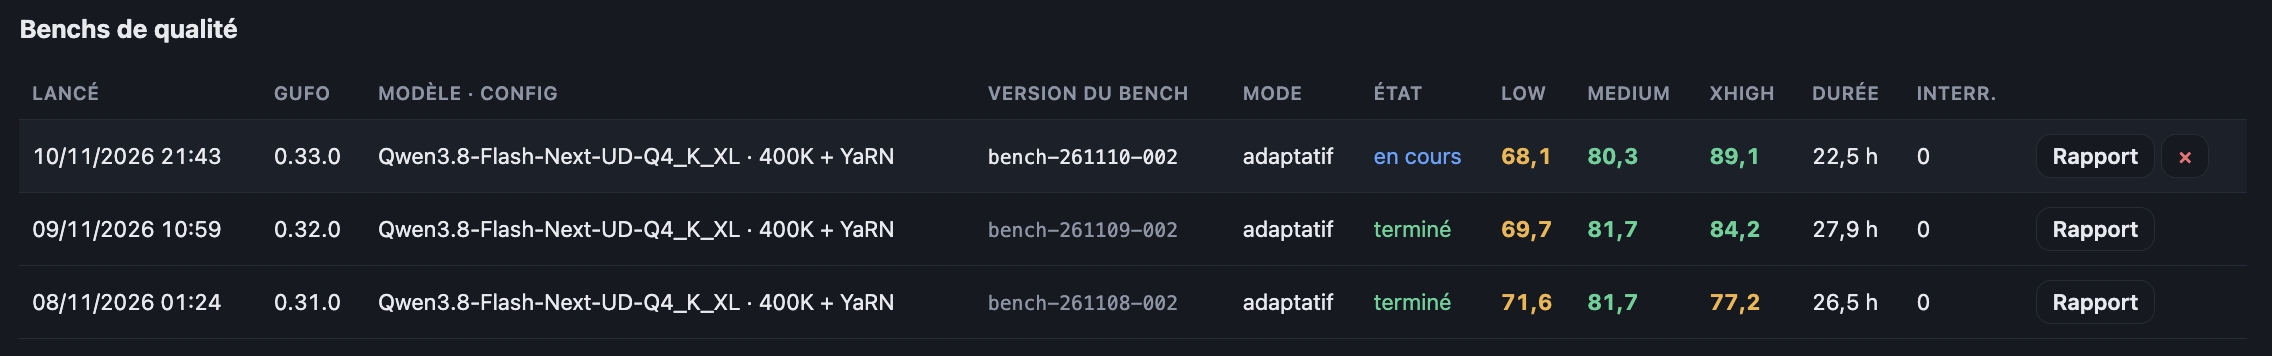
en parlant de benchmaxing :
 
https://rehost.diberie.com/Picture/Get/f/569646
 
(le bench n'est pas fini pour le max. Il va probablement droper vers 83% si ses résultats à la dernière version du bench suivent la tendance de low et med :
 
https://rehost.diberie.com/Picture/Get/f/569647
 
faudra que je fasse un test contre une IA plus puissante mais toujours hebergeable. Peut être le deepseek flash 4.1 mint et uncensored sur le cloud supposément totalement privé https://near.ai/  
 

n°56648
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 22:44:57  profilanswer
 

C'est beau :D
 
Tu vas pouvoir nous faire tous les quants :love:
Il y a beaucoup de trucs a installer pour lancer les benchs?


---------------
Faudra que je teste un jour :o
n°56650
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 22:46:09  profilanswer
 

Gyro S 3.8 Flash Next tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=4Tk4HRYl-os
 
TL;DR: Gyros-S défonce tout :o


---------------
Faudra que je teste un jour :o
n°56651
neo world
Posté le 11-11-2026 à 22:56:50  profilanswer
 

the_fennec a écrit :

C'est beau :D
 
Tu vas pouvoir nous faire tous les quants :love:
Il y a beaucoup de trucs a installer pour lancer les benchs?


c'est des containers (assez balaises quand même vu que les sorties sont testées sur de vrais environnements kotlin / JS / FireFox / Python / Rust ... ). Tu as un environnement docker quelque part dans ton homelab avec un accès réseau vers ton strata ?

n°56654
moyen_moin​s
chat réincarné
Posté le 11-11-2026 à 23:16:51  profilanswer
 

the_fennec a écrit :

Gyro S 3.8 Flash Next tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=4Tk4HRYl-os
 
TL;DR: Gyros-S défonce tout :o


dans le reasonning, s'pas ouf mais globalement, pour du local, ça marche fort [:j0rj:5]

n°56655
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 23:18:55  profilanswer
 

neo world a écrit :


c'est des containers (assez balaises quand même vu que les sorties sont testées sur de vrais environnements kotlin / JS / FireFox / Python / Rust ... ). Tu as un environnement docker quelque part dans ton homelab avec un accès réseau vers ton strata ?


Oui j'ai un Docker sur ma VM agent, mais j'ai poussé les meubles coté RAM pour faire de la place pour Strata, j'ai que 5GB sur la VM agent. J'ai déjà quelques containers, donc 3GB max. Sinon je peux faire un docker sur mon Proxmox qui est tout vide pour le moment... il est tellement frais que j'ai juste posé le ventirad sur le CPU :o.
 
Mais bon, je viens de mettre mon agent ou boulot avec IQ1_M pour ajouter le support de Vulkan sur Strata et tant qu'a faire je lui ait dit d’utiliser Spock et une ou deux BC250 pour tester :lol:.


---------------
Faudra que je teste un jour :o
n°56656
the_fennec
f3nn3cUs z3rd4
Posté le 11-11-2026 à 23:24:41  profilanswer
 

moyen_moins a écrit :


dans le reasonning, s'pas ouf mais globalement, pour du local, ça marche fort [:j0rj:5]


Le code c'est la vie, le reasoning OSEF :o


---------------
Faudra que je teste un jour :o
n°56725
the_fennec
f3nn3cUs z3rd4
Posté le 12-11-2026 à 11:45:56  profilanswer
 

I'm releasing a Local World Model Ive been building that turns images into interactive videos you control in real time. It works on RTX 3060, 4060 and anything above, linking huggingface
https://www.reddit.com/r/LocalLLaMA [...] _ive_been/
 
Ça a l'air cool, faut que je teste un jour :o


---------------
Faudra que je teste un jour :o
 Page :   1  2  3  4  5  ..  98  99  100  101  102  103

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)