Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3839 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  41  42  43  ..  62  63  64  65  66  67
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°45998
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 11:49:05  profilanswer
 

Reprise du message précédent :

Pipould's a écrit :


Clairement... 400 balles pour le risque, ok, 1600 de Chine... Bof


J'avais trouvé un listing a $600 sur globalsources.com, mais sans surprise:
 

Citation :


About the USED CMP 170HX 8GB, let me share you the detail.
 
USED CMP 170HX  8Gb: 1309USD
DHL shipping cost : 65USD
Grand total is 1309+65=1374USD
...
yes, the price on the page was about 660USD, as the demand of this GPU card is soaring and the supply is limited, so the price is higher than the price i show on the page, sorry for not updating the price in time and makes you in trouble.  


---------------
Faudra que je teste un jour :o
n°45999
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 12:03:03  profilanswer
 

the_fennec a écrit :


Avant la doc bc250 disait de régler ça dans le BIOS, mais c'est plus le cas:
https://elektricm.github.io/amd-bc250-docs/bios/vram/
 

Citation :

It is commonly stated that 512MB VRAM split is a "dynamic allocation" mode, where the system will automatically reassign RAM to the VRAM pool as needed, but then will return that VRAM back to RAM when the game is closed.
 
In truth, ALL VRAM split settings are dynamic! There is nothing special about the 512MB mode except that it has a very small MINIMUM VRAM allocation.


Donc ta config est bonne :D


:jap: Yep je pense que la limite est dynamique et donc les modèles n’arrive pas à évalué la quantité de mémoire vraiment dispo.  
 
Par contre j’ai lancé une grosse modif de script, content de voir que ça tournait en local … tout à tourné en fallback sur deepseek :o

Message cité 1 fois
Message édité par Big Blue le 23-08-2026 à 12:03:26
n°46003
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 23-08-2026 à 12:19:57  profilanswer
 

T'as aussi des 2080 Ti 22 Go, en dual avec pont NVLink tu t'en sors à moins de 1000 €.
Je pense que c'est le bon sweet spot : CUDA, vieux mais pas trop, prix au Go de VRAM qui tient la route et surtout NVLink qui permet de l'exploiter sur de vieilles plateformes pas chères.
 
Une CMP sera plus perf, mais si c'est une 10 Go, à la fin tu n'auras que 40 Go de VRAM, et 60 Go c'est pas intéressant je trouve.
Pour moi les paliers c'est plutôt : 32/40 Go puis directement 128 Go et après 256 Go. Les tailles intermédiaires, c'est payer du Go en plus pour rien dans mon usage..
 
Sinon petit pavé dans la mare : https://github.com/FlashML-org/FreeToken
 
Pour les MoE c'est sacrément intéressant : co-exécution CPU/GPU avec répartition dynamique des experts selon les bandes passantes réelles de la machine.  
Les experts restent en RAM et la VRAM sert en gros de gros cache LRU, FreeToken décide en temps réel quels experts charger sur le GPU et lesquels calculer directement sur le CPU.
 
Pour le prefill il fait aussi du double buffering : pendant que le GPU calcule un layer, les experts du suivant sont déjà transférés en VRAM.  
Et il ajoute des checkpoints sur le KV/recurrent state aux endroits logiques du contexte, ce qui permet de ne recalculer que la partie modifiée lors des tool calls ou changements de contexte.
 
En pratique :

Code :
  1. - Qwen3.6-35B on an 8GB GPU at 39.3 tokens/s
  2. - DeepSeek-V4-Flash 284B on a 32GB GPU at 22 tokens/s
  3. - GLM-5.2 753B on a 96GB GPU at 14.9 tokens/s


L'auteur annonçait déjà sur X travailler sur le support des RTX 2XXX et du dual GPU :D


---------------
Victime de girafophobie, mais se soigne.
n°46007
Plam
Bear Metal
Posté le 23-08-2026 à 12:49:33  profilanswer
 

neo world a écrit :

Pour ceux qui hésitent à s'équiper parce que "personne n'est assez fou pour ..." On sera toujours le petit joueur de quelqu'un :o
 
https://rehost.diberie.com/Picture/Get/f/538197


Pas mal, faut que je regarde le meilleur modèle pour ce type de setup :o


---------------
Spécialiste du bear metal
n°46008
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 12:57:04  profilanswer
 

Big Blue a écrit :


:jap: Yep je pense que la limite est dynamique et donc les modèles n’arrive pas à évalué la quantité de mémoire vraiment dispo.  
 
Par contre j’ai lancé une grosse modif de script, content de voir que ça tournait en local … tout à tourné en fallback sur deepseek :o


Tu utilises auto fit?
Sinon ngl et moe-cpu contrôlent le spli, mais sur une carte UMA comme la BC250 ça n'a aucun intérêt. Avec un modèle de 10GB, ça prends 10GB plus les buffers et le KV cache, pas de miracle.


---------------
Faudra que je teste un jour :o
n°46012
Pipould's
Posté le 23-08-2026 à 13:57:46  profilanswer
 

the_fennec a écrit :


Avant la doc bc250 disait de régler ça dans le BIOS, mais c'est plus le cas:
https://elektricm.github.io/amd-bc250-docs/bios/vram/

 
Citation :

It is commonly stated that 512MB VRAM split is a "dynamic allocation" mode, where the system will automatically reassign RAM to the VRAM pool as needed, but then will return that VRAM back to RAM when the game is closed.


In truth, ALL VRAM split settings are dynamic! There is nothing special about the 512MB mode except that it has a very small MINIMUM VRAM allocation.


Donc ta config est bonne :D


C'est la même sur le Strix halo, t'as 512 en  mem video et tout le reste en gtt

n°46013
Pipould's
Posté le 23-08-2026 à 14:00:47  profilanswer
 

Tronklou a écrit :

T'as aussi des 2080 Ti 22 Go, en dual avec pont NVLink tu t'en sors à moins de 1000 €.
Je pense que c'est le bon sweet spot : CUDA, vieux mais pas trop, prix au Go de VRAM qui tient la route et surtout NVLink qui permet de l'exploiter sur de vieilles plateformes pas chères.


Une CMP sera plus perf, mais si c'est une 10 Go, à la fin tu n'auras que 40 Go de VRAM, et 60 Go c'est pas intéressant je trouve.
Pour moi les paliers c'est plutôt : 32/40 Go puis directement 128 Go et après 256 Go. Les tailles intermédiaires, c'est payer du Go en plus pour rien dans mon usage..


Sinon petit pavé dans la mare : https://github.com/FlashML-org/FreeToken


Pour les MoE c'est sacrément intéressant : co-exécution CPU/GPU avec répartition dynamique des experts selon les bandes passantes réelles de la machine.
Les experts restent en RAM et la VRAM sert en gros de gros cache LRU, FreeToken décide en temps réel quels experts charger sur le GPU et lesquels calculer directement sur le CPU.


Pour le prefill il fait aussi du double buffering : pendant que le GPU calcule un layer, les experts du suivant sont déjà transférés en VRAM.
Et il ajoute des checkpoints sur le KV/recurrent state aux endroits logiques du contexte, ce qui permet de ne recalculer que la partie modifiée lors des tool calls ou changements de contexte.


En pratique :

Code :
  1. - Qwen3.6-35B on an 8GB GPU at 39.3 tokens/s
  2. - DeepSeek-V4-Flash 284B on a 32GB GPU at 22 tokens/s
  3. - GLM-5.2 753B on a 96GB GPU at 14.9 tokens/s


L'auteur annonçait déjà sur X travailler sur le support des RTX 2XXX et du dual GPU :D


Raaaahhhh ou j'hésite à prendre un dual de 2080ti a 44GB pour ma plateforme a base de 6700k et 32gb de ddr3

n°46014
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 14:29:11  profilanswer
 

Tronklou a écrit :

T'as aussi des 2080 Ti 22 Go, en dual avec pont NVLink tu t'en sors à moins de 1000 €.
Je pense que c'est le bon sweet spot : CUDA, vieux mais pas trop, prix au Go de VRAM qui tient la route et surtout NVLink qui permet de l'exploiter sur de vieilles plateformes pas chères.
 
Une CMP sera plus perf, mais si c'est une 10 Go, à la fin tu n'auras que 40 Go de VRAM, et 60 Go c'est pas intéressant je trouve.
Pour moi les paliers c'est plutôt : 32/40 Go puis directement 128 Go et après 256 Go. Les tailles intermédiaires, c'est payer du Go en plus pour rien dans mon usage..
 
Sinon petit pavé dans la mare : https://github.com/FlashML-org/FreeToken
 
Pour les MoE c'est sacrément intéressant : co-exécution CPU/GPU avec répartition dynamique des experts selon les bandes passantes réelles de la machine.  
Les experts restent en RAM et la VRAM sert en gros de gros cache LRU, FreeToken décide en temps réel quels experts charger sur le GPU et lesquels calculer directement sur le CPU.
 
Pour le prefill il fait aussi du double buffering : pendant que le GPU calcule un layer, les experts du suivant sont déjà transférés en VRAM.  
Et il ajoute des checkpoints sur le KV/recurrent state aux endroits logiques du contexte, ce qui permet de ne recalculer que la partie modifiée lors des tool calls ou changements de contexte.
 
En pratique :

Code :
  1. - Qwen3.6-35B on an 8GB GPU at 39.3 tokens/s
  2. - DeepSeek-V4-Flash 284B on a 32GB GPU at 22 tokens/s
  3. - GLM-5.2 753B on a 96GB GPU at 14.9 tokens/s


L'auteur annonçait déjà sur X travailler sur le support des RTX 2XXX et du dual GPU :D


c'est très nvidia oriented non ?

n°46016
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 15:17:02  profilanswer
 

bon, la mise à jour unsloth de leur modèle qwen 3.8 27B refuse de fonctionner chez moi en UD_Q6M.
je teste la davidAU en Q6_Low et sans budget thinking, elle a l'air de se tenir dans les clous et pas de raconter sa vie (ou pas) :)
edit: par contre, pas l'impression que le MTP fonctionne


edit: DavidAU 3.8 27B Q6 Low vs Atomicchat Q6 27B => 20min thinking vs 38min et malgré le temps de réflexion plus bas, meilleur résultat.


Message édité par moyen_moins le 23-08-2026 à 16:55:53
n°46017
Pipould's
Posté le 23-08-2026 à 15:23:53  profilanswer
 

Tiens d'ailleurs,  
 
J'ai une config avec un 6700K, une Z170M DDR3 et 32 GB de DDR3.  
 
La carte a 1 PCIE3 16x et 1 PCIE3 4x
 
J'hesite a prendre une double 2080ti 22GB moddees pour avoir 44GB et me faire un second serveur d'inference...  
 
Des gens ont des retours ?  
 
Merci d'avance

n°46018
neo world
Posté le 23-08-2026 à 16:00:50  profilanswer
 

the_fennec a écrit :


Ouais, enfin c'est un "pro"... enfin il semble faire du conseil IA d’après son site.  


On peut quand même apprécier l’approche professionnelle et adaptée du serveur posé à l’arrache au milieu de la pièce (mais sur une moquette quand même. On est pas des animaux :o :o :o )

n°46019
neo world
Posté le 23-08-2026 à 16:02:58  profilanswer
 

Pipould's a écrit :

Tiens d'ailleurs,  
 
J'ai une config avec un 6700K, une Z170M DDR3 et 32 GB de DDR3.  
 
La carte a 1 PCIE3 16x et 1 PCIE3 4x
 
J'hesite a prendre une double 2080ti 22GB moddees pour avoir 44GB et me faire un second serveur d'inference...  
 
Des gens ont des retours ?  
 
Merci d'avance


L’Aventure avec un grand A. Tu as regardé le coût vs deux b60 ou une b70 ?
 
Le support constructeur risque quand même d’être moins aléatoire :D

n°46020
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 16:43:59  profilanswer
 

c'est combien le meilleur prix pour du B70 ? on dirait que c'est aussi cher qu'une R9700 pro (~1600 balles) :??:
de ce que je vois c'est passablement hors de prix pour des perfs inférieures non ?

n°46021
Pipould's
Posté le 23-08-2026 à 17:13:26  profilanswer
 

neo world a écrit :


L’Aventure avec un grand A. Tu as regardé le coût vs deux b60 ou une b70 ?
 
Le support constructeur risque quand même d’être moins aléatoire :D


1600 balles une B70...
 
Clairement le but pour moi est de recycler la vielle mobo et ram...


Message édité par Pipould's le 23-08-2026 à 17:29:53
n°46022
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 18:01:29  profilanswer
 

Bon, je teste ce qwen 3.8 via lmstudio (flemme :o) et en mode extra high sans limite de budget de thinking, ça fait des trucs vraiment chouettes.
Là, j'ai repris le même prompt, limité le budget à 4096 tokens et le résultat est de suite moins flatteur et ne marche pas du 1er coup.
Va falloir que je teste différentes tailles pour savoir c'est quoi le bon compromis.

n°46024
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 18:06:39  profilanswer
 

https://rehost.diberie.com/Picture/Get/f/538333


J'ai pas OC comme sur SteamOS, c'est pas plus mal, j'avais des problèmes d'instabilité, niveau mémoire par contre c'est top, je suis entrain à l'aise avec 262k de contexte :love:


On va tenter IQ2_M +192k, ça devrait être mieux :o

Message cité 2 fois
Message édité par Big Blue le 23-08-2026 à 18:13:29
n°46026
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 18:11:08  profilanswer
 

neo world a écrit :


On peut quand même apprécier l’approche professionnelle et adaptée du serveur posé à l’arrache au milieu de la pièce (mais sur une moquette quand même. On est pas des animaux :o :o :o )


C'est pas parce qu'on est pro qu'on fait toujours les choses proprement :D
 

moyen_moins a écrit :

Bon, je teste ce qwen 3.8 via lmstudio (flemme :o) et en mode extra high sans limite de budget de thinking, ça fait des trucs vraiment chouettes.
Là, j'ai repris le même prompt, limité le budget à 4096 tokens et le résultat est de suite moins flatteur et ne marche pas du 1er coup.
Va falloir que je teste différentes tailles pour savoir c'est quoi le bon compromis.


Je trouve que limiter le thinking avec le budget donne toujours des résultats aléatoires. Je trouve que c'est mieux de le désactiver complètement ou passer en low vu que c'est possible sur Qwen 3.8. Avec 4k tokens il doit tout juste reprendre ton prompt et à peine commencer à l'analyser, surtout si tu as laisser le thinking en xhigh.


---------------
Faudra que je teste un jour :o
n°46029
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 18:15:54  profilanswer
 

Big Blue a écrit :

https://rehost.diberie.com/Picture/Get/f/538333
 
J'ai pas OC comme sur SteamOS, c'est pas plus mal, j'avais des problèmes d'instabilité, niveau mémoire par contre c'est top, je suis entrain à l'aise avec 262k de contexte :love:  
 
On va tenter IQ2_M +192k, ça devrait être mieux :o


Debian FTW :o
T'as unlock le CPU aussi?


---------------
Faudra que je teste un jour :o
n°46030
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 18:16:05  profilanswer
 

J'dois être neuneu mais je vois rien dans Lmstudio pour baisser le niveau de reasoning.
Je vais tenter un autre template jinja. [:paysan]

n°46033
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 18:22:38  profilanswer
 

C'est pas toi, c'est Lmstudio :o


---------------
Faudra que je teste un jour :o
n°46035
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 18:26:01  profilanswer
 

the_fennec a écrit :


Debian FTW :o
T'as unlock le CPU aussi?


Yep :jap:


C’est bien stable sous debian, je suis sur que c’est utilisable au quotidien :jap:


Message édité par Big Blue le 23-08-2026 à 18:26:52
n°46036
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 18:27:26  profilanswer
 

un gemma 4 12b c'est pas "mieux" qu'un gros MoE de 35B trop quantized ?

n°46038
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 18:28:46  profilanswer
 

J’ai déjà essayé Gemma 4, c’est une cata sous Hermes, il gère mal les appels d’outils.

n°46039
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 18:29:05  profilanswer
 

Perso je trouve que même en Q8 Gemma 31B se loupe pas mal sur le tooling.


---------------
Faudra que je teste un jour :o
n°46040
Plam
Bear Metal
Posté le 23-08-2026 à 18:31:27  profilanswer
 

Premiers retours des équipes depuis l'upgrade sur Qwen 3.8 27B : un bond en avant indéniable, la confiance monte pour certains même laisser leur slot Claude.

Message cité 1 fois
Message édité par Plam le 23-08-2026 à 18:31:44

---------------
Spécialiste du bear metal
n°46044
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 18:40:57  profilanswer
 

Big Blue a écrit :

J’ai déjà essayé Gemma 4, c’est une cata sous Hermes, il gère mal les appels d’outils.


ok.
si c'est pas indiscret, tu t'en sers pour quoi de tous ces tooling calls ? :o

n°46045
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 18:43:16  profilanswer
 

Plam a écrit :

Premiers retours des équipes depuis l'upgrade sur Qwen 3.8 27B : un bond en avant indéniable, la confiance monte pour certains même laisser leur slot Claude.


perso, sur un prompt, j'ai préféré la réponse de qwen 3.8 27B à celle d'ox alpha sur opencode go [:mouais]

n°46047
Big Blue
Live/Psn/Nid legeantbleu
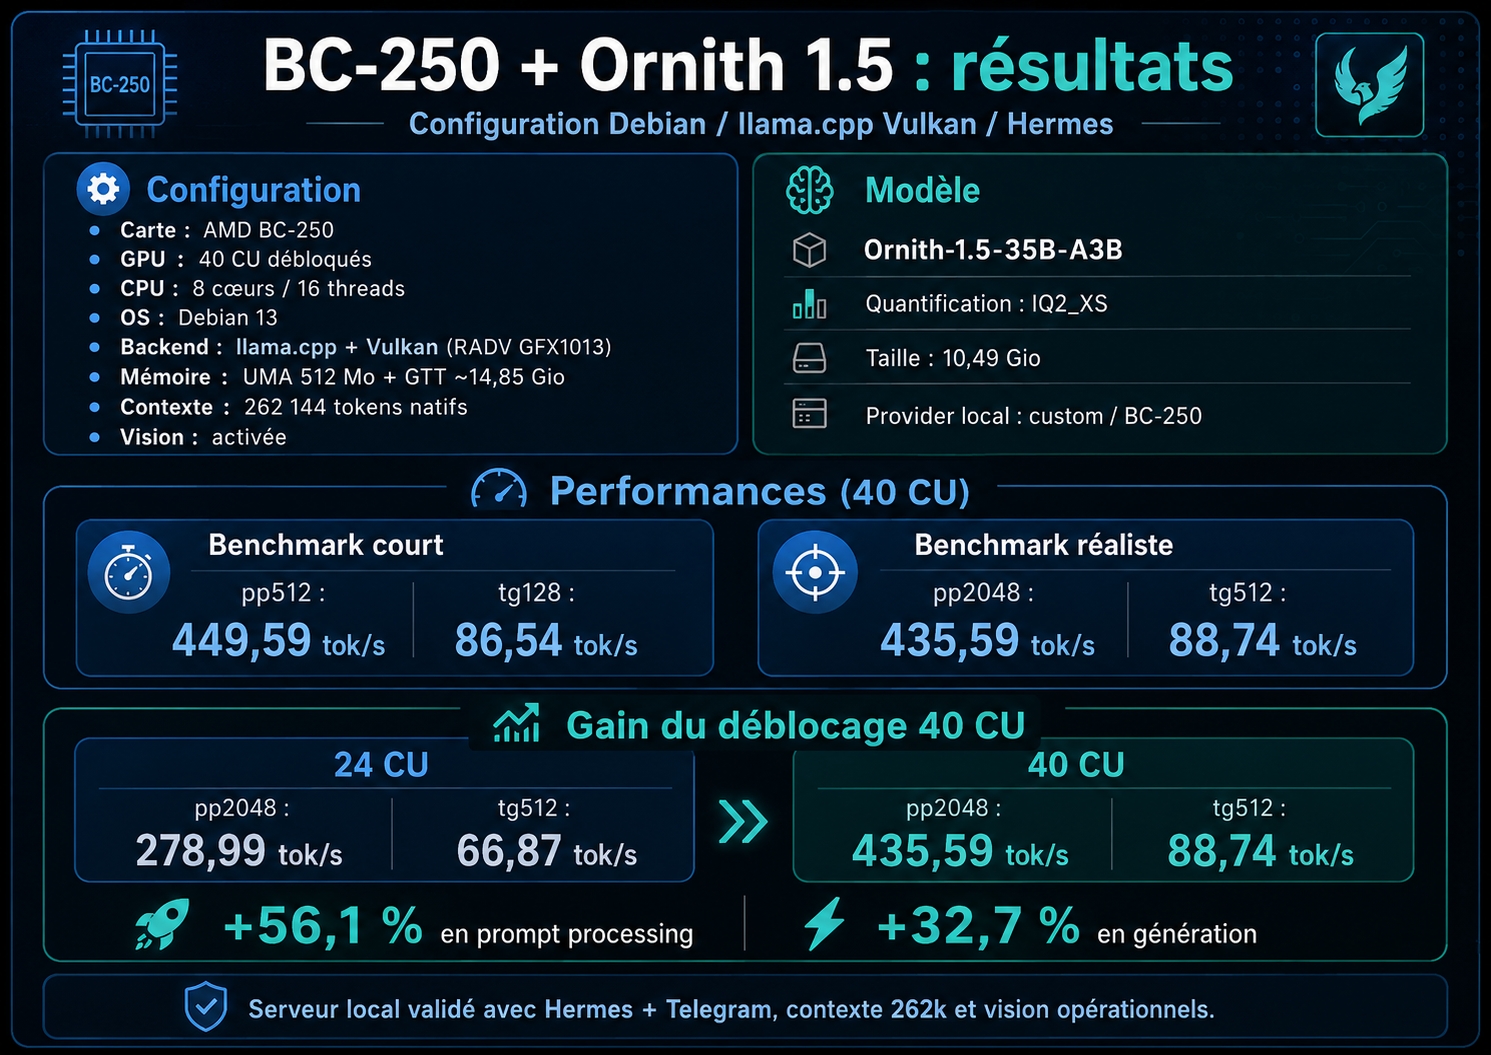
Posté le 23-08-2026 à 18:59:38  profilanswer
 

Config définitive (jusqu'à la semaine prochaine quand un nouveau modèle sortira :o )  
 
Ornith 1.5 35B-A3B IQ2_M + 192k + vision + 40 CU + reasoning illimité
 
meilleur intelligence et plus de ram dispo :jap:
 
Je pense du coup vraiment racheter une b250 juste pour ça, j'ai une alim SFX et un SSD de 256go, 130€ la carte ... a voir les test pratique :jap:


Message édité par Big Blue le 23-08-2026 à 19:06:48
n°46048
Plam
Bear Metal
Posté le 23-08-2026 à 19:07:14  profilanswer
 

moyen_moins a écrit :


perso, sur un prompt, j'ai préféré la réponse de qwen 3.8 27B à celle d'ox alpha sur opencode go [:mouais]


Quel harness pour Qwen dans ta comparaison ? J'suis encore très indécis sur les différentes possibilités. OpenCode à l'air de manger plein de contexte, je sais pas si la compaction marche vraiment bien.


---------------
Spécialiste du bear metal
n°46049
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 19:08:55  profilanswer
 

moyen_moins a écrit :


ok.
si c'est pas indiscret, tu t'en sers pour quoi de tous ces tooling calls ? :o


Gestion domotique, serveur, gestion des scripts sur le serveur.  
 
De mon téléphone via télégram je gère toutes la domotique/informatique du domicile quoi, plus besoin de sortir le MacBook et un terminal :o

n°46050
moyen_moin​s
chat réincarné
Posté le 23-08-2026 à 19:31:53  profilanswer
 

Plam a écrit :


Quel harness pour Qwen dans ta comparaison ? J'suis encore très indécis sur les différentes possibilités. OpenCode à l'air de manger plein de contexte, je sais pas si la compaction marche vraiment bien.


aucun pour qwen, prompt à la con dans lmstudio et le résultat en xtra high vs ox alpha max dans opencode en 1er jet, rien à voir.
le prompt en gros c'est générer une page html avec une roue façon la roue de la fortune et de personnaliser les résultats obtenus avec humour (running gag du boulot).
bon évidemment, les temps pour obtenir les résultats par contre :o
 
je viens de tester un nouveau template jinja qui change le niveau de thinking et le passe en medium de base et c'est moins impressionnant mais quasi fonctionnel au 1er jet.
bien plus utilisable au quotidien (contexte, temps de réponse en mode thinking).

n°46051
Plam
Bear Metal
Posté le 23-08-2026 à 19:39:20  profilanswer
 

J'ai remarqué que ça gênait pas trop les équipes d'attendre plus longtemps pour plus de qualité ici :jap:
 
Je vois quand même un gap entre médium et xhigh, même pour des tâches moins pointues.
 
Maintenant j'aimerai un 35B MoE pour les non-devs :love:


---------------
Spécialiste du bear metal
n°46054
neo world
Posté le 23-08-2026 à 20:16:20  profilanswer
 

moyen_moins a écrit :

J'dois être neuneu mais je vois rien dans Lmstudio pour baisser le niveau de reasoning.
Je vais tenter un autre template jinja. [:paysan]


Tu as les flags sous la conversation, tu clic sur extra high et tu sélectionnes le niveau que tu veux avant d’envoyer ton message. Ils ont mis à jour LM studio genre 5h après la sortie du modèle pour ça :love:

n°46055
Big Blue
Live/Psn/Nid legeantbleu
Posté le 23-08-2026 à 20:28:58  profilanswer
 

Ornith qui me fait du débogage de Deepseek v4 flash exp je m’y attendais vraiment pas :o

n°46057
neo world
Posté le 23-08-2026 à 20:35:28  profilanswer
 

moyen_moins a écrit :

c'est combien le meilleur prix pour du B70 ? on dirait que c'est aussi cher qu'une R9700 pro (~1600 balles) :??:
de ce que je vois c'est passablement hors de prix pour des perfs inférieures non ?


p'têtre en B50 dans ce cas pour moins de 450 balles ?  
 
https://www.idealo.fr/prix/20771609 [...] 5015064237
 
Faut regarder les perfs par contre. C'est peut être pas très malin si nvidia supporte encore bien les 20xx au niveau de cuda :jap:

n°46063
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 21:27:08  profilanswer
 

Plam a écrit :

J'ai remarqué que ça gênait pas trop les équipes d'attendre plus longtemps pour plus de qualité ici :jap:
 
Je vois quand même un gap entre médium et xhigh, même pour des tâches moins pointues.
 
Maintenant j'aimerai un 35B MoE pour les non-devs :love:


Vu que j'ai viré little-coder je vais peut être repasser en xhigh.  
 
Une vidéo de Luke's Dev Lab qui compare les thinking levels:
https://www.youtube.com/watch?v=z64J6bC16iQ
 
medium c'est quand même pas mal.


---------------
Faudra que je teste un jour :o
n°46064
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 21:27:50  profilanswer
 

neo world a écrit :


p'têtre en B50 dans ce cas pour moins de 450 balles ?  
 
https://www.idealo.fr/prix/20771609 [...] 5015064237
 
Faut regarder les perfs par contre. C'est peut être pas très malin si nvidia supporte encore bien les 20xx au niveau de cuda :jap:


Est-ce que c'est pas mieux de partir sur une Radeon pour 50 euros de plus?


---------------
Faudra que je teste un jour :o
n°46066
the_fennec
f3nn3cUs z3rd4
Posté le 23-08-2026 à 21:28:47  profilanswer
 

moyen_moins a écrit :


ok.
si c'est pas indiscret, tu t'en sers pour quoi de tous ces tooling calls ? :o


De mon coté c'est du dev, Gemma tiens pas longtemps sans foirer un tool call.
 
Qwen 3.8 s'en sort mieux:
https://i.imgur.com/fDWY3en.png

Message cité 1 fois
Message édité par the_fennec le 23-08-2026 à 21:30:14

---------------
Faudra que je teste un jour :o
n°46068
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 23-08-2026 à 21:51:28  profilanswer
 

Pipould's a écrit :


Raaaahhhh ou j'hésite à prendre un dual de 2080ti a 44GB pour ma plateforme a base de 6700k et 32gb de ddr3


Franchement dans TON cas de figure, vaut mieux soit viser du mono gpu avec du model dense, ou du dual avec nvlink pour sauter le pcie au fraise en cas de tensors //  
Ou alors t'es aps exigeant sur la vitesse et tu prend du hard pas cher au gb : 3060/mi50
 

moyen_moins a écrit :


c'est très nvidia oriented non ?


Totalement, comme 90% des nouveautés. Pour le moment l'IA c'est principalement tournée vers nvidia, après vulkan/rocm et en bon dernier intel quand ils se réveillent tous les 4 matins...  
 

Pipould's a écrit :

Tiens d'ailleurs,  
 
J'ai une config avec un 6700K, une Z170M DDR3 et 32 GB de DDR3.  
 
La carte a 1 PCIE3 16x et 1 PCIE3 4x
 
J'hesite a prendre une double 2080ti 22GB moddees pour avoir 44GB et me faire un second serveur d'inference...  
 
Des gens ont des retours ?  
 
Merci d'avance


Y a des retours en dual 2080ti 22gb ici :  
https://github.com/weicj/2080Ti-LLM-Toolbox
https://www.kernelcrash.com/blog/ol [...] 025/03/10/


the_fennec a écrit :


Est-ce que c'est pas mieux de partir sur une Radeon pour 50 euros de plus?


Si, largement.
La B70 a 1200e ca s'entendais, mais entre le support pourris, la petite communautée... ca vaut pas les 50 balles d'économisés.  


---------------
Victime de girafophobie, mais se soigne.
n°46071
Pipould's
Posté le 23-08-2026 à 22:43:50  profilanswer
 

Tronklou a écrit :


Franchement dans TON cas de figure, vaut mieux soit viser du mono gpu avec du model dense, ou du dual avec nvlink pour sauter le pcie au fraise en cas de tensors //  
Ou alors t'es aps exigeant sur la vitesse et tu prend du hard pas cher au gb : 3060/mi50


Tronklou a écrit :


Totalement, comme 90% des nouveautés. Pour le moment l'IA c'est principalement tournée vers nvidia, après vulkan/rocm et en bon dernier intel quand ils se réveillent tous les 4 matins...  


Tronklou a écrit :


Si, largement.
La B70 a 1200e ca s'entendais, mais entre le support pourris, la petite communautée... ca vaut pas les 50 balles d'économisés.  


C'est tentant effectivement...  
 
Je prends ca et j'ai un deuxieme 3.8 a full context..

n°46085
the_fennec
f3nn3cUs z3rd4
Posté le 24-08-2026 à 10:08:53  profilanswer
 

How Fast Can One RTX 3060 Actually Run 35B (llama.cpp enhancement)?
https://www.youtube.com/watch?v=k_LostFpatg
 
Vidéo intéressante de Codacus sur les experts MoE, il parle d'un patch qu'il fait pour llama.cpp mais explique aussi comment les experts fonctionnent aussi.


---------------
Faudra que je teste un jour :o
 Page :   1  2  3  4  5  ..  41  42  43  ..  62  63  64  65  66  67

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)