Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3831 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  38  39  40  ..  65  66  67  68  69  70
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°45474
moyen_moin​s
chat réincarné
Posté le 17-08-2026 à 13:03:46  profilanswer
 

Reprise du message précédent :

Pipould's a écrit :


J'en ai pris une, aucune idee de ce que je vais en faire... J'essaierai de lui faire un boitier en 3D Print...  
 
Je me demande ce que ca donnerait un cluster...
 
Y'a un discord ou un repo de docu pour l'unlock des CU etc ?  
 
merci :-)


Pareil :)

n°45476
Pipould's
Posté le 17-08-2026 à 13:57:06  profilanswer
 

Faudrait que je trouve une vielle alim de recup en fait...

n°45477
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 14:00:12  profilanswer
 

Ajout du support de Ling dans llama.cpp:
https://www.reddit.com/r/LocalLLaMA [...] _llamacpp/
 
Ling tiny 8B A1B
Ling flash 124B A5B
 
Je trouve les deux modèles intéressant, a voir si ça vaut le coup!


---------------
Faudra que je teste un jour :o
n°45478
bifidusse
(actif)
Posté le 17-08-2026 à 14:02:34  profilanswer
 

Fichtre, je découvre ce topic.
 
Je suis grand débutant en IA locale, j'ai très récemment craqué pour une 5060 ti en 16GB. Vu la montée des prix, j'avais l'impression que c'était maintenant ou jamais.  
 
La config : AMD 5950X, 48 Go ram (2x16 et 2x8) et la 5060 ti donc.
Avec Ollama, Anything LLM et Linux.
 
Mon but : jouer avec, découvrir, comprendre comment ça marche et à terme, en faire un truc utile de tri / recherche / fusion de documents, taggage de photos... j'aurais bien attendu encore un peu mais donc, vu les prix...
 
Donc je teste les capacités à reconnaître des sujets photographiés, à résumer/traduire et à répondre à des questions stupides comme :
- how many walkers did you kill
- qui a chanté Morgane de toi (très intéressant, se plantent tous)
- quelle est la taille des oeufs de vache
 
Je suis vraiment en phase découverte.
 
Si j'ai bien vu qqn ici a pu ajouter une 1650 Super à son setup ? De ce que j'ai vu je pourrais physiquement ajouter la 1650 à ma CM mais elles vont être bien collées et le PCIe en plus est en x2 de mémoire.  
 
Bref, je joue  :D

n°45486
moyen_moin​s
chat réincarné
Posté le 17-08-2026 à 15:28:19  profilanswer
 

the_fennec a écrit :

Ajout du support de Ling dans llama.cpp:
https://www.reddit.com/r/LocalLLaMA [...] _llamacpp/
 
Ling tiny 8B A1B
Ling flash 124B A5B
 
Je trouve les deux modèles intéressant, a voir si ça vaut le coup!


il y a aussi quelques versions REAP.
de ce que j'avais pu essayer sur les qwen coder next, les résultats en REAP sont bof mais on part dans ce cas avec plus de paramètres.
il y a une version 97B 53.3Go en MXFP4 ou 58.3 en K4_M [:transparency]

n°45487
moyen_moin​s
chat réincarné
Posté le 17-08-2026 à 15:53:14  profilanswer
 

Pipould's a écrit :

Faudrait que je trouve une vielle alim de recup en fait...


une alim 12V 30A pour juste du 12V suffirait pas ?
c'est ce que je comptais faire avec un rallonge PCIE pluguée sur les 3 borniers +12V/GND [:transparency]  
par contre, c'est le stockage que j'ai plus.
ça devrait pas trop mal tourner avec du gemma 4 12B QAT non ?

n°45489
Pipould's
Posté le 17-08-2026 à 16:22:15  profilanswer
 

moyen_moins a écrit :


une alim 12V 30A pour juste du 12V suffirait pas ?
c'est ce que je comptais faire avec un rallonge PCIE pluguée sur les 3 borniers +12V/GND [:transparency]  
par contre, c'est le stockage que j'ai plus.
ça devrait pas trop mal tourner avec du gemma 4 12B QAT non ?


C'est ce que je me dis...

n°45511
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 20:28:19  profilanswer
 

bifidusse a écrit :

Fichtre, je découvre ce topic.
 
Je suis grand débutant en IA locale, j'ai très récemment craqué pour une 5060 ti en 16GB. Vu la montée des prix, j'avais l'impression que c'était maintenant ou jamais.  
 
La config : AMD 5950X, 48 Go ram (2x16 et 2x8) et la 5060 ti donc.
Avec Ollama, Anything LLM et Linux.
 
Mon but : jouer avec, découvrir, comprendre comment ça marche et à terme, en faire un truc utile de tri / recherche / fusion de documents, taggage de photos... j'aurais bien attendu encore un peu mais donc, vu les prix...
 
Donc je teste les capacités à reconnaître des sujets photographiés, à résumer/traduire et à répondre à des questions stupides comme :
- how many walkers did you kill
- qui a chanté Morgane de toi (très intéressant, se plantent tous)
- quelle est la taille des oeufs de vache
 
Je suis vraiment en phase découverte.
 
Si j'ai bien vu qqn ici a pu ajouter une 1650 Super à son setup ? De ce que j'ai vu je pourrais physiquement ajouter la 1650 à ma CM mais elles vont être bien collées et le PCIe en plus est en x2 de mémoire.  
 
Bref, je joue  :D


Ajouter une 1650 Super c'est faisable, faut voir si tes pilotes la supporte encore. Après tu vas tuer tes perf vu la diff entre la 1650 et 5060, mais si ça te permet de mettre un modèle dense qui passait pas ça peut être un bon plan. Pour un modèle MoE il vaut mieux faire un offload CPU surtout avec autant de RAM dispo et un bon CPU!


moyen_moins a écrit :


il y a aussi quelques versions REAP.
de ce que j'avais pu essayer sur les qwen coder next, les résultats en REAP sont bof mais on part dans ce cas avec plus de paramètres.
il y a une version 97B 53.3Go en MXFP4 ou 58.3 en K4_M [:transparency]


Mouais bof bof les REAP, pas convaincu non plus. Après j'ai un DS4 REAP sous le coude, j'attends juste un fix RPC.
 

moyen_moins a écrit :


une alim 12V 30A pour juste du 12V suffirait pas ?
c'est ce que je comptais faire avec un rallonge PCIE pluguée sur les 3 borniers +12V/GND [:transparency]  
par contre, c'est le stockage que j'ai plus.
ça devrait pas trop mal tourner avec du gemma 4 12B QAT non ?


C'est ce que j'ai une alim pour LED 12V 30A avec une rallonge pcie.
 
Si t'es pas pressé ça doit se tenter un Linux live en USB et tu charges le modèle par le réseau?


---------------
Faudra que je teste un jour :o
n°45512
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 20:35:05  profilanswer
 

Qwen 3.8 qui se pose la, a la cool :o
https://i.imgur.com/0i5JgIZ.png
 
https://artificialanalysis.ai/#intelligence
 
edit: post reddit effacé


Message édité par the_fennec le 17-08-2026 à 21:08:03

---------------
Faudra que je teste un jour :o
n°45513
Kyjja
Y'a pot !
Posté le 17-08-2026 à 20:42:26  profilanswer
 

Ça mesure quoi ?
 
(Les graph sans unité c'est poubelle)


---------------
HWBot | Conso GPU | Who's who PSU | Mes BD \o/ | GReads | MSpaint
n°45514
Nr13
Posté le 17-08-2026 à 20:45:23  profilanswer
 

Je crois que c'est le score de chaque modèle à l'Artificial Analysis Intelligence Index, mais je suis pas sûr.

n°45516
moyen_moin​s
chat réincarné
Posté le 17-08-2026 à 20:50:48  profilanswer
 

the_fennec a écrit :


Mouais bof bof les REAP, pas convaincu non plus. Après j'ai un DS4 REAP sous le coude, j'attends juste un fix RPC.


J'essaierai peut être. Pour la science :o

the_fennec a écrit :


C'est ce que j'ai une alim pour LED 12V 30A avec une rallonge pcie.


Si t'es pas pressé ça doit se tenter un Linux live en USB et tu charges le modèle par le réseau?


Je crois avoir un 250Go qui traine (ancien disque de portable). Faut juste le retrouver dans mon bordel :/


edit: Retrouvé :D
et mes 2x8Go de DDR5 sodimm :o

Message cité 1 fois
Message édité par moyen_moins le 17-08-2026 à 20:59:47
n°45519
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 21:09:06  profilanswer
 

Kyjja a écrit :

Ça mesure quoi ?
 
(Les graph sans unité c'est poubelle)


J'ai mis les bon liens :o
c'est une compilation de benchs, ya pas d'unité.


---------------
Faudra que je teste un jour :o
n°45520
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 21:10:41  profilanswer
 

moyen_moins a écrit :


Je crois avoir un 250Go qui traine (ancien disque de portable). Faut juste le retrouver dans mon bordel :/
 
edit: Retrouvé :D
et mes 2x8Go de DDR5 sodimm :o


Je me tâtais a faire un boot PXE, mais la flemme :o


---------------
Faudra que je teste un jour :o
n°45522
Kyjja
Y'a pot !
Posté le 17-08-2026 à 21:19:41  profilanswer
 

the_fennec a écrit :

J'ai mis les bon liens :o
c'est une compilation de benchs, ya pas d'unité.


Quelqu'un peut faire tourner son setup pour m'expliquer avec une belle infographie ? :o


On évalue quoi ? Comment ? On pondère de quelle manière ? Quelle est la base 1 (ou 100, ou...) ?


Parce que je doute franchement de la pertinence de ce ce graphique s'il consiste à mélanger des pommes et des patates pour arriver à un chiffre totalement arbitraire via la méthode wet finger index™.


En l'état je vois juste un graphique de mauvais marketteux "regardez comme notre produit est meilleur que celui de la concurrence, la barre est plus haute"


Edit : c'est pas après toi que j'en ai le fennec, c'est juste que ça me semble bien fumeux.


Si je me fade la méthodologie :

 
Citation :

Our methodology emphasizes fairness and real-world applicability.


Ok c'est bien, mais qu'est-ce que ça signifie exactement ?

 
Citation :

We estimate a 95% confidence interval for Artificial Analysis Intelligence Index of less than ±1% - based on experiments with >10 repeats on certain models for all evaluation datasets included in Artificial Analysis Intelligence Index v4.1.1. Individual evaluation results may have wider than ±1% confidence intervals.


Oh cool, de jolis mot de stats. Bon, un échantillon de 10 est trop faible pour faire des stats, on nous donne en filigrane des pseudos p-values dont on ne reparlera jamais (et que siginifie "intervalle de confiance à 95% pour l'Index machin +- 1%" ? Le reste de la phrase est à l'avenant, vous avez compris le truc :o)


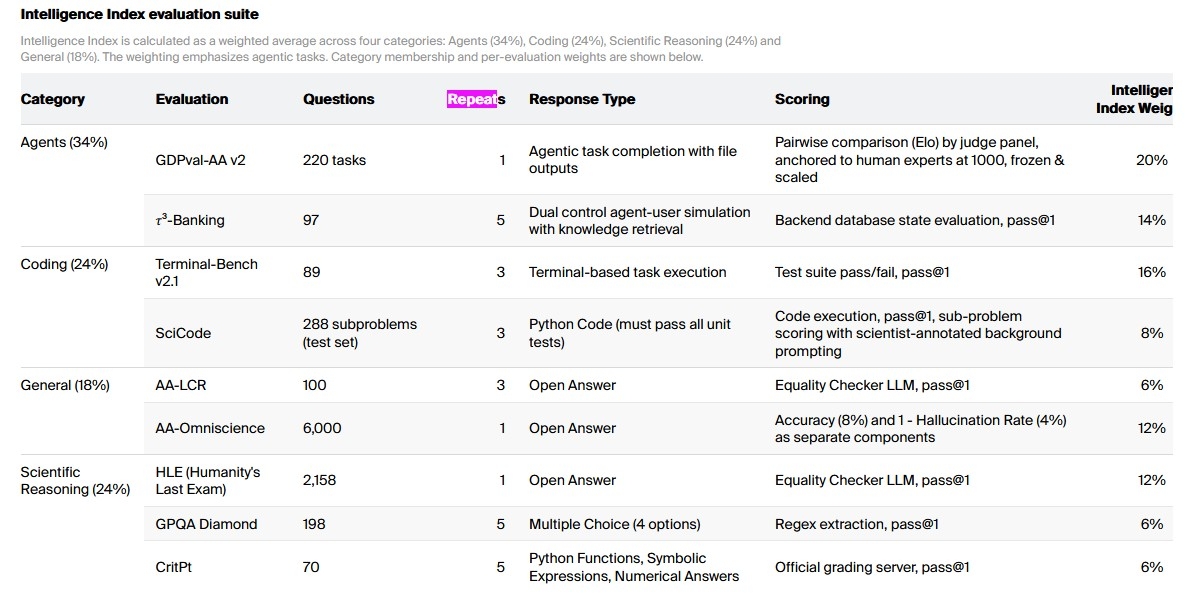
Idem pour le tableau :


https://rehost.diberie.com/Picture/Get/f/536809


Comment a été choisie la répartition des différentes catégories ? Même question pour l'Index.
Comment ont été sélectionnés ces test ? Pourquoi certains ont le droit à plusieurs tirs et d'autres un seul ? Et en cas de tirs multiple, on prend quoi ? Moyenne, médiane, on exclue certaines valeurs et si oui sous quels critères ?


#statisticien #aigri :o


Message édité par Kyjja le 17-08-2026 à 21:47:32

---------------
HWBot | Conso GPU | Who's who PSU | Mes BD \o/ | GReads | MSpaint
n°45524
the_fennec
f3nn3cUs z3rd4
Posté le 17-08-2026 à 22:13:34  profilanswer
 

Non mais je suis d'accord, c'est un peu bidon comme site :jap: c'est juste marrant de voir un modèle aussi petit aussi haut.
Même les benchs sur lesquels il est basé sont pas top pour la plupart.
 
C'est le Metacritic de l'AI :D


Message édité par the_fennec le 17-08-2026 à 22:14:03

---------------
Faudra que je teste un jour :o
n°45547
croustx
Modoadorateur
Posté le 18-08-2026 à 10:44:20  profilanswer
 

Vous savez s'il y a une version abliterated de Qwen 3.8:27 de dispo ?

Message cité 1 fois
Message édité par croustx le 18-08-2026 à 10:45:09
n°45549
bifidusse
(actif)
Posté le 18-08-2026 à 10:51:45  profilanswer
 

Ce que je peux dire en tout cas c'est que Qwen3.8-27b (la version qui pèse 18Go) ne sait pas qui a chanté "Morgane de toi"  :D  
 
Par contre, contrairement à tous les autres (Gemma4, llama, Mistral...) il ne répond pas n'importe quoi (ou alors je confonds avec llama3.3, mais je pense bien que c'était qwen3.8 qui s'arrêtait à "je ne sais pas, je ne vais pas raconter de bêtises" ).
 
[quotemsg=45511,1527,87715]
 
Ajouter une 1650 Super c'est faisable, faut voir si tes pilotes la supporte encore. Après tu vas tuer tes perf vu la diff entre la 1650 et 5060, mais si ça te permet de mettre un modèle dense qui passait pas ça peut être un bon plan. Pour un modèle MoE il vaut mieux faire un offload CPU surtout avec autant de RAM dispo et un bon CPU!
 
[/quote]
 
Actuellement un "gros" modèle qui dépasse mes 16GB comme Gemma4-26b reste assez réactif. Un llama3.3-70b est beaucoup plus lent (genre 1/3 GPU, 2/3 CPU).
 
Mais donc, si je comprends bien, si ça dépasse un peu il vaut mieux un offload en ram, mais si je voulais utiliser souvent un llama3.3-70b, je devrais aller avec un 2e GPU pour me rapprocher d'un taux 25% CPU 75% GPU (ce qui est très utilisable, en tout cas à mon sens)

Message cité 2 fois
Message édité par bifidusse le 18-08-2026 à 10:52:26
n°45554
Pipould's
Posté le 18-08-2026 à 11:16:37  profilanswer
 

bifidusse a écrit :

Ce que je peux dire en tout cas c'est que Qwen3.8-27b (la version qui pèse 18Go) ne sait pas qui a chanté "Morgane de toi"  :D


Demandes a Mistral Ai, peut etre qu'il sera gagnant :o  

n°45557
bifidusse
(actif)
Posté le 18-08-2026 à 11:41:24  profilanswer
 

Pipould's a écrit :


Demandes a Mistral Ai, peut etre qu'il sera gagnant :o  


 :lol:

n°45558
neo world
Posté le 18-08-2026 à 11:47:38  profilanswer
 

Faut donner accès à internet à vos modèles :D
 
Si ils ne piratent pas hugging face pour tricher aux benchmarks c’est tout bon pour faire la recherche Google qu’il vous manquait :o

n°45560
Nr13
Posté le 18-08-2026 à 11:58:20  profilanswer
 

Blague à part c'est un peu le nerf de la guerre pour les "petits" modèles non (et le principe derrière les MoE)?  
Si on veut juste que l'outil sache répondre à une question de "connaissance" directe, on s'en fout qu'il ait besoin de faire une recherche, et on peut gagner du coût d'inférence.
 Par contre si on veut qu'il compose et chante comme Renaud, vaut mieux qu'il soit entrainé dessus...

n°45562
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 18-08-2026 à 12:10:23  profilanswer
 

Pipould's a écrit :


Demandes a Mistral Ai, peut etre qu'il sera gagnant :o  


[:john_tgv:8]


---------------
Victime de girafophobie, mais se soigne.
n°45563
bifidusse
(actif)
Posté le 18-08-2026 à 12:38:03  profilanswer
 

neo world a écrit :

Faut donner accès à internet à vos modèles :D
 
Si ils ne piratent pas hugging face pour tricher aux benchmarks c’est tout bon pour faire la recherche Google qu’il vous manquait :o


À vrai dire je teste tous azimuts, donc aussi avec des questions qui au final apparaissent comme non pertinentes. ça me permet aussi de voir comment certains gèrent les difficultés, pourquoi certains acceptent texte et images, d'autres que le texte...
 
J'en suis à chercher des modèles très spécialisés comme la reconnaissance de lieux sur base de photos, voire entraînés sur certains pays uniquement.
 
C'est assez passionnant à défaut d'être, pour le moment, utile  :D  

n°45565
croustx
Modoadorateur
Posté le 18-08-2026 à 12:58:58  profilanswer
 

neo world a écrit :

Faut donner accès à internet à vos modèles :D
 
Si ils ne piratent pas hugging face pour tricher aux benchmarks c’est tout bon pour faire la recherche Google qu’il vous manquait :o


D'ailleurs, vous faites comment ?

n°45566
moyen_moin​s
chat réincarné
Posté le 18-08-2026 à 13:12:00  profilanswer
 

Faut que je mette le truc recherche internet dans lmstudio, c'est plus simple pour tester que lancer le serveur + modèle et configurer opencode.

n°45568
bifidusse
(actif)
Posté le 18-08-2026 à 13:38:19  profilanswer
 

croustx a écrit :


D'ailleurs, vous faites comment ?


Dans Anything LLM (en version desktop en tout cas), si j'active le mode agent, il veut bien aller sur une page web et, par exemple, la résumer (sinon il se bornait systématiquement à broder autour des infos contenues dans l'url).
 
Sur mon portable je n'y arrive pas, mais ALLM tourne dans un conteneur docker, je suppose que ceci explique cela.

n°45569
neo world
Posté le 18-08-2026 à 13:53:09  profilanswer
 

Faut chercher dans les MCP de recherche pour votre plateforme :
LMStudio : https://lmstudio.ai/brius
LLama.cpp : je vois searxng revenir : https://medium.com/@anish.rai3737/a [...] ce33378219
 
etc. :D

n°45583
yohaskan
Posté le 18-08-2026 à 17:22:32  profilanswer
 

Unsloth Studio aussi a l'option websearch + Agent (Openclaude, Openclaw, ou autres ) dans son chat et/ou server web API

n°45585
the_fennec
f3nn3cUs z3rd4
Posté le 18-08-2026 à 17:39:07  profilanswer
 

croustx a écrit :

Vous savez s'il y a une version abliterated de Qwen 3.8:27 de dispo ?


Il doit déjà en avoir plusieurs milliers sur HF non? :o
 

bifidusse a écrit :

Ce que je peux dire en tout cas c'est que Qwen3.8-27b (la version qui pèse 18Go) ne sait pas qui a chanté "Morgane de toi"  :D  
 
Par contre, contrairement à tous les autres (Gemma4, llama, Mistral...) il ne répond pas n'importe quoi (ou alors je confonds avec llama3.3, mais je pense bien que c'était qwen3.8 qui s'arrêtait à "je ne sais pas, je ne vais pas raconter de bêtises" ).


J'ai lu sur Reddit :o que les connaissances générale ont été purgées. C'est pas plus mal, OSEF d'avoir ce genre d'infos dans un modèle si il est capable de chercher sur internet tout seul.


bifidusse a écrit :

Actuellement un "gros" modèle qui dépasse mes 16GB comme Gemma4-26b reste assez réactif. Un llama3.3-70b est beaucoup plus lent (genre 1/3 GPU, 2/3 CPU).
 
Mais donc, si je comprends bien, si ça dépasse un peu il vaut mieux un offload en ram, mais si je voulais utiliser souvent un llama3.3-70b, je devrais aller avec un 2e GPU pour me rapprocher d'un taux 25% CPU 75% GPU (ce qui est très utilisable, en tout cas à mon sens)


Dépasser un peu avec un MoE comme Gemma4-26b ne pose pas de problème, tu mets des experts en RAM avec " --n-cpu-moe" et ça roule. Tu ne perds en perf que quand les experts sont accédés et llama.cpp se débrouille pas mal avec ça.
Avec un modèle dense comme llama3.3-70b ou Qwen 27B, tous les layers sont utilisés tout le temps, donc dès que ça déborde en RAM c'est mort. Avec deux GPUs plus de soucis, même si les bouts qui sont sur le GPU le plus lents vont te limiter en perf, c'est bien mieux qu'en RAM/CPU.
 

neo world a écrit :

Faut chercher dans les MCP de recherche pour votre plateforme :
LMStudio : https://lmstudio.ai/brius
LLama.cpp : je vois searxng revenir : https://medium.com/@anish.rai3737/a [...] ce33378219
 
etc. :D


Oui j'ai un searxng, mais ça fait un moment que je l'ai pas reconfigurer. J'avais la config OC il me semble, j'ai prévu de retester OC v2... un jour.
 
En tout cas Qwen 3.8 mouline bien, même si il est un peu lent ... a 160k de contexte je suis a 35/s de PP et 5/tgs  [:kurt haribo]


---------------
Faudra que je teste un jour :o
n°45595
bifidusse
(actif)
Posté le 18-08-2026 à 19:38:32  profilanswer
 

Ok, Gemma4 26b est MoE, ça explique pourquoi je le trouve plutôt rapide alors qu'il déborde de mon GPU (si j'ai bien tout compris).
 
En parlant de MoE, de fil en aiguille je suis tombé sur https://insiderllm.com/guides/runni [...] am-guide/.
 
On y parle de gpt-oss 120b et plus précisément : "gpt-oss 120B loads in about 14GB with its native MXFP4 weights (ollama pull gpt-oss:120b) and runs faster than a dense 70B ever could."
 
Du coup moi je me suis dit "champagne !" sauf que ollama pull gpt-oss:120b me télécharge 65Go.
 
Donc je suppose que le rêve s'arrête ici ? Ou j'ai raté quelque chose ?

n°45596
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 18-08-2026 à 19:49:48  profilanswer
 

C'est surtout que c'est a la rue maintenant gpt oss :D
 
Concentre toi sur les qwen 3.6/3.8 vus ta config


---------------
Victime de girafophobie, mais se soigne.
n°45599
the_fennec
f3nn3cUs z3rd4
Posté le 18-08-2026 à 20:40:06  profilanswer
 

bifidusse a écrit :

Ok, Gemma4 26b est MoE, ça explique pourquoi je le trouve plutôt rapide alors qu'il déborde de mon GPU (si j'ai bien tout compris).
 
En parlant de MoE, de fil en aiguille je suis tombé sur https://insiderllm.com/guides/runni [...] am-guide/.
 
On y parle de gpt-oss 120b et plus précisément : "gpt-oss 120B loads in about 14GB with its native MXFP4 weights (ollama pull gpt-oss:120b) and runs faster than a dense 70B ever could."
 
Du coup moi je me suis dit "champagne !" sauf que ollama pull gpt-oss:120b me télécharge 65Go.
 
Donc je suppose que le rêve s'arrête ici ? Ou j'ai raté quelque chose ?


Je connais pas Ollama, j'ai testé ya longtemps et je l'ai viré car il essaye de cacher trop de chose, c'est just un UI pourrave qui essaye de se faire des sous sur le dos de llama.cpp.
 
Je prends mon modèle sur Huggingface, par exemple chez Unsloth:
https://huggingface.co/unsloth/Qwen3.6-35B-A3B-GGUF
 
J'ai renseigné ma config, enfin juste ma VRAM, et je vois directement sur la fiche les modèles qui vont bien:
https://i.imgur.com/HzqKp37.png
 
J'utilise donc llama.cpp, j'ai mes .bat avec la config qui va bien, généralement j'applique bêtement la config recommandée.
https://unsloth.ai/docs/models/qwen3.6
 
J'ai un dossier ou j'ai DL mes modèle et j'ai pas a espérer que Ollama ou LMStudio ait pris les bon :o
 
Comme le dis Tronklou, GPT oss c'est un vieux truc, Qwen 9B doit faire bien mieux, je te parles pas de 35B.


---------------
Faudra que je teste un jour :o
n°45601
the_fennec
f3nn3cUs z3rd4
Posté le 18-08-2026 à 20:42:42  profilanswer
 

Bon on dirait qu'Opencode c'est pas encore ça :o
 
https://www.reddit.com/r/LocalLLaMA [...] en_models/
 

Citation :


OpenCode will always send top-p=1.0 (which means there is no filtering of low-probability tokens except with top-k) instead of the correct 0.95...


Citation :


 Was fun figuring out that reasoning effort needs to be written as
 
  "options": {
    "reasoningEffort": "low"
  }
 
Because it's translated back and forth in the ai-sdk that opencode uses and then ninfers' server does understand it has to translate back.  


---------------
Faudra que je teste un jour :o
n°45603
neo world
Posté le 18-08-2026 à 20:55:49  profilanswer
 

Pour ça j'aime bien LM studio : un update et paf j'ai un beau bouton pour gérer le reasoning effort.  
 
Évidemment c'est moins bien à distance sans UI parce que soit c'est full ligne de commande soit faut passer par leur service de connexion à distance (merci mais je voulais un truc local. Pas un truc qui passe chez vous d'abord :o )

n°45604
the_fennec
f3nn3cUs z3rd4
Posté le 18-08-2026 à 21:07:55  profilanswer
 

Comment tu fais pour le RPC?
Perso j'ai un .bat qui update llama.cpp sur Windows et les deux Linux, relance les systemd et j'ai juste a lancer mon .bat avec llama.cpp qui va bien.


---------------
Faudra que je teste un jour :o
n°45605
neo world
Posté le 18-08-2026 à 21:14:50  profilanswer
 

J'ai mis plus de pognon dans mes machines de travail pour pas avoir du RPC à gérer :o
 
evidemment retour à llama.cpp sans lemonade le jour où les Strix Halo / Mac studio ne vaudront plus rien. Normalement j'ai le temps de voir venir :o


Message édité par neo world le 18-08-2026 à 21:15:17
n°45611
the_fennec
f3nn3cUs z3rd4
Posté le 18-08-2026 à 21:38:36  profilanswer
 

J'ai rien a gérer, mais c'est leeent :D


---------------
Faudra que je teste un jour :o
n°45613
totosssfr
Pousse-testa
Posté le 18-08-2026 à 22:46:39  profilanswer
 

croustx a écrit :


D'ailleurs, vous faites comment ?


Comme beaucoup ici, un conteneur searxng attaqué par openwebui ou continue.dev.


Un autre mcp que j'utilise : le mcp Microsoft learn (pratique pour consulter les docs MS sans réinventer la roue).


D'ailleurs,j'aimerai bien tester la mise en place de mcp un peu partout pour le suivi des logs de tout le homelab ou piloter tel ou tel outil. J'ai vu que docker proposait quelque chose également.


---------------
Pousse tarasse forever.
n°45629
bifidusse
(actif)
Posté le 19-08-2026 à 10:40:04  profilanswer
 

the_fennec a écrit :


Je connais pas Ollama, j'ai testé ya longtemps et je l'ai viré car il essaye de cacher trop de chose, c'est just un UI pourrave qui essaye de se faire des sous sur le dos de llama.cpp.
 
Je prends mon modèle sur Huggingface, par exemple chez Unsloth:
https://huggingface.co/unsloth/Qwen3.6-35B-A3B-GGUF
 
J'ai renseigné ma config, enfin juste ma VRAM, et je vois directement sur la fiche les modèles qui vont bien:
(...)
J'utilise donc llama.cpp, j'ai mes .bat avec la config qui va bien, généralement j'applique bêtement la config recommandée.
https://unsloth.ai/docs/models/qwen3.6
 
J'ai un dossier ou j'ai DL mes modèle et j'ai pas a espérer que Ollama ou LMStudio ait pris les bon :o
 
Comme le dis Tronklou, GPT oss c'est un vieux truc, Qwen 9B doit faire bien mieux, je te parles pas de 35B.


Tellement de choses à apprendre encore, que j'ai.
 
Je pensais qu'Ollama était la solution open-source favorite pour faire de l'IA locale.
 
J'ai installé Unsloth Desktop (même si visiblement à la base c'était un conteneur Docker, c'est comme Anything LLM, ils ont aussi leur version desktop (?) ) pour tester. Il semblait plus directement utilisable qu'Open web UI ou Anything.  
 
Quoi qu'il en soit, je ne suis pas parvenu à le connecter à Ollama. Et en creusant j'apprends qu'Ollama stocke les modèles de manière chiffrée (? - c'est ce qu'une... IA m'a répondu) et qu'il vaut mieux le GGUF. edit : ah ben non, finalement Unsloth Desktop liste bien les modèles Ollama dans ModelHub/On device mais pas dans la liste déroulante (même si je choisis On device). Il mentionne que les modèles sont des GGUF. Par contre il ne veut pas me les charger. Bon, je chercherai plus tard.
 
Donc, le GGUF est le fichier de base, Ollama en fait une version perso qu'il est le seul à pouvoir gérer. Ce GGUF on peut aussi le télécharger soi-même mais il doit être modifié / compilé / autre participe passé d'un verbe en er pour être utilisable via un modelfile.
 
Je raconte probablement n'importe quoi, c'est juste mon état de compréhension actuel  :lol:  
 
Quoi qu'il en soit, j'ai installé un gemma-4-E2B-it-GGUF en Q4 (je teste sur mon portable sans carte dédiée  :D ) qui était dans les modèles conseillés pour mon matériel (pratique).
 
Il y a un bouton "search" (comme dans Lumo au début). Si je l'active et que je demande simplement "cherche sur Internet", il trouve.
 
Plus précisément :
- il ne sait pas qui a chanté Morgane de toi (mais ne répond pas Mylène Farmer, Pierre Perret, Garou, Céline Dion, sisi, j'ai déjà tout eu)
- il trouve avec une recherche (vous me direz, c'est bien le moins, j'aurais été plus vite en allant directement sur un moteur / bon, je connaissais déjà la réponse, c'est pas la question, si je puis dire)
 
Résultat des courses :
- je progresse : j'ai une IA locale qui peut réfléchir ET aller sur Internet pour trouver la réponse au besoin ;
- Unsloth semble prometteur (recherche facile, je pourrais améliorer mon modèle (?)

Message cité 1 fois
Message édité par bifidusse le 19-08-2026 à 10:52:00
n°45634
yohaskan
Posté le 19-08-2026 à 11:37:01  profilanswer
 

Tu as combien de VRam déja ? 16GB   ?
Les gemma4 12B devrait passer en Q4,
gemma-4-12B-it-Q4_K_M.gguf
 
et si tu veux un bon MoE (Mixture of Expert ; 3 milliards de paramètre actif (les experts) sur les 35 milliards de paramètres du model "sa connaissance globale" )  
Qwen3.6-35B-A3B-MTP-GGUF mais la c'est du 20Go donc ca va deborder de tes 16 Go de Vram... Faut voir si le débit te va
en attendant un futur Qwen3.8-35B-A3B-MTP-GGUF

Message cité 1 fois
Message édité par yohaskan le 19-08-2026 à 11:44:01
 Page :   1  2  3  4  5  ..  38  39  40  ..  65  66  67  68  69  70

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)