Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
2256 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  64  65  66  67  68  69
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°48839
yohaskan
Posté le 12-09-2026 à 17:55:18  profilanswer
 

Reprise du message précédent :
J'ai reçu ma facture conso électrique, et je m’attendais a une surconso en aout, vu l'overthink depuis l'arrivé de Qwen 3.8 27B  
(je bouffe façile 8-9 million de token par jours en local, la CG doit bouffer 500W d’inférence 8h par jour...)
ben non. rien.  
En baisse de 3 kWa  
ou alors c'est pour le moins prochain :heink:

n°48862
neo world
Posté le 12-09-2026 à 22:31:19  profilanswer
 

Pipould's a écrit :


T'as essayé crewai ? C'est quasi ce que tu veux faire on dirait.


Je me le note dans un coin. Ca ressemble aussi au projet de joce  :jap:
 
En fait je fais une sorte d'ersatz d'agent swarm dans mon environnement en espérant mieux comprendre quelles interactions marchent vs qu'est ce qui est contre productif. C'est autant l'envie d'avoir mes apps que l'envie d'apprendre l'agentique qui motive ces choix assez "roots". Si c'était pour un besoin purement métier clairement je bazardais tout ça pour partir sur une solution clé en main comme celle que tu montres et j'escaladais aussi la puissance installée pour gagner en productivité :jap:
 

Pipould's a écrit :

Après pourquoi pas utiliser un harness de type Claude code en cli ? Ou est-ce que ton use case n'est pas forcément orienté dev ?


Y'aura forcément un peu de claude code dans mon setup (communication avec l'utilisateur, création du plan et tests fonctionnels) :jap:  
Mon use case est complètement dev mais dans une enveloppe de token contraint par ce que peut sortir mon macbook pro et mon strix halo. Claude code étant ultra verbeux des harness moins verbeux comme pi aident à en avoir plus pour le même temps avec le risque de passer trop de temps en setup vs le gain d'un produit plus complet mais moins frugal :jap:

n°48863
neo world
Posté le 12-09-2026 à 22:35:28  profilanswer
 

yohaskan a écrit :

J'ai reçu ma facture conso électrique, et je m’attendais a une surconso en aout, vu l'overthink depuis l'arrivé de Qwen 3.8 27B  
(je bouffe façile 8-9 million de token par jours en local, la CG doit bouffer 500W d’inférence 8h par jour...)
ben non. rien.  
En baisse de 3 kWa  
ou alors c'est pour le moins prochain :heink:


tu as le compteur linky ? Tu pourrais récupérer la consommation instantanée et mesurer l'impact sur ta facture en temps réel avant de la recevoir :D

n°48868
xenom
Plaquettes chaussettes
Posté le 13-09-2026 à 00:38:01  profilanswer
 

[:cerveau drapal]

n°48869
neo world
Posté le 13-09-2026 à 01:05:02  profilanswer
 

welcome :D
 
Tu as déjà du materiel / tu fais tourner des modèles en local ? C'est quoi ton usage principal ?  
 
Et surtout : tu es team scotch papier ou boucherie sur boitier pour optimiser le refroidissement de ton GPU / accelerateur ? :o :o

n°48872
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 13-09-2026 à 06:59:17  profilanswer
 

Le combo marteau scotch a fait ses preuves  :O


---------------
Victime de girafophobie, mais se soigne.
n°48875
xenom
Plaquettes chaussettes
Posté le 13-09-2026 à 08:35:51  profilanswer
 

J'ai des RTX 6000 au boulot :o


Mais surtout j'ai un mb m5 pro avec 64 GB de mémoire donc je commençais à faire joujou avec omlx


Pour le reste, mon vaillant microserver Gen8 ne m'aidera pas dans cette quête  :D

Message cité 1 fois
Message édité par xenom le 13-09-2026 à 08:36:49
n°48890
neo world
Posté le 13-09-2026 à 10:00:46  profilanswer
 

xenom a écrit :

J'ai des RTX 6000 au boulot :o
 
Mais surtout j'ai un mb m5 pro avec 64 GB de mémoire donc je commençais à faire joujou avec omlx
 
Pour le reste, mon vaillant microserver Gen8 ne m'aidera pas dans cette quête  :D


Je te conseille aussi de jouer avec Qwen 3.8 sur ton mac. Tu as ce qu'il faut pour que ça tourne confortablement (j'ai une pref pour LMStudio question interface / integration) :D
 
Tu sais quel(s) modèle(s) sont utilisés au boulot ? c'est surtout pour des tâches de dev ou vous automatisez d'autres trucs (résumé de documents, réunion, aide à la décision ...)? :D

Message cité 1 fois
Message édité par neo world le 13-09-2026 à 10:43:25
n°48893
neo world
Posté le 13-09-2026 à 10:06:02  profilanswer
 

Tronklou a écrit :

Le combo marteau scotch a fait ses preuves  :O


oui et ça reboucle bien avec le côté boucher charcutier sur mains humaines cette fois :o
 
Sinon y'a LTT qui en veut aux cartes pas moins chers: après le BC 250 c'est au tour des CMP 170 HX d'être recommandées "au prix actuel". Pas merci Linus :o

n°48903
xenom
Plaquettes chaussettes
Posté le 13-09-2026 à 11:41:39  profilanswer
 

neo world a écrit :


Je te conseille aussi de jouer avec Qwen 3.8 sur ton mac. Tu as ce qu'il faut pour que ça tourne confortablement (j'ai une pref pour LMStudio question interface / integration) :D


Tu sais quel(s) modèle(s) sont utilisés au boulot ? c'est surtout pour des tâches de dev ou vous automatisez d'autres trucs (résumé de documents, réunion, aide à la décision ...)? :D


Ha c'est bien qwen 3.8 que j'utilise sur omlx. Perso LMStudio je trouve ça usine à gaz et historiquement ça prenait pas en charge le cache mlx donc j'avais de moins bonnes perfs. Je ne sais pas ce qu'il en est aujourd'hui.


Oui mon usage pour le self hosting c'est surtout d'avoir un coding agent alternatif.


Nos RTX servent à générer des protéines sur des diffusion models donc pas le même biz  :D

n°48908
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 13-09-2026 à 11:57:01  profilanswer
 

neo world a écrit :


oui et ça reboucle bien avec le côté boucher charcutier sur mains humaines cette fois :o
 
Sinon y'a LTT qui en veut aux cartes pas moins chers: après le BC 250 c'est au tour des CMP 170 HX d'être recommandées "au prix actuel". Pas merci Linus :o


Là on rentre dans le gros du FOMO quand les chaines "généraliste" en viennent a orienter sur ce genre de solution  :sweat:  
Je me suis un peu calmé aussi : j'investie plus rien avant quelques années je pense, les prix son trop déconnectés de l'usage et ni les models ni les technos ne sont assez mature pour le justifier avec mon usage.


---------------
Victime de girafophobie, mais se soigne.
n°48909
neo world
Posté le 13-09-2026 à 11:59:28  profilanswer
 

xenom a écrit :


Ha c'est bien qwen 3.8 que j'utilise sur omlx. Perso LMStudio je trouve ça usine à gaz et historiquement ça prenait pas en charge le cache mlx donc j'avais de moins bonnes perfs. Je ne sais pas ce qu'il en est aujourd'hui.
 
Oui mon usage pour le self hosting c'est surtout d'avoir un coding agent alternatif.
 
Nos RTX servent à générer des protéines sur des diffusion models donc pas le même biz  :D


Un peu de  alphafold dans le pipe ? :D

n°48910
neo world
Posté le 13-09-2026 à 12:00:21  profilanswer
 

Tronklou a écrit :


Là on rentre dans le gros du FOMO quand les chaines "généraliste" en viennent a orienter sur ce genre de solution  :sweat:  
Je me suis un peu calmé aussi : j'investie plus rien avant quelques années je pense, les prix son trop déconnectés de l'usage et ni les models ni les technos ne sont assez mature pour le justifier avec mon usage.


clairement j'achète plus rien avant la DDR6 ou un effondrement des prix. whichever happens first :o

n°48912
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 13-09-2026 à 12:07:08  profilanswer
 

Je mise tout sur les génération d'apu/igpu dans 4/5ans avec mémoire partagée. En gros des architecture a la halo mais sous stéroïdes :D


---------------
Victime de girafophobie, mais se soigne.
n°48917
neo world
Posté le 13-09-2026 à 12:29:17  profilanswer
 

Je mise aussi sur une optimisation des architectures de LLM. Le MoE est quand même super pratique mais c’est anormal de bouffer autant de RAM et de BP de base quand une toute petite partie du modèle est en fait vraiment utile. Sans ça faudra passer à la caisse +++ par ce que personne n’est rentable ni en entraînement ni en inférence

n°48948
epsiloncen​taury
Posté le 13-09-2026 à 17:43:26  profilanswer
 

L'IA dans un ou deux ans ne ressemblera probablement en rien à celle d'aujourd'hui.
 
Les Chinois sont peut-être en train de niquer les Ricains dans les grandes largeurs. Et Nvidia, à mon avis, est en train de faire un pari particulièrement risqué en misant quasiment tout sur les modèles fermés, les datacenters et les marges énormes de l'IA, tout en délaissant progressivement le marché des joueurs. Certes, Nvidia est assis sur des centaines de milliards et peut se permettre énormément de choses, mais avoir énormément de pognon ne veut pas forcément dire qu'on a misé sur le bon cheval.
 
Pour la première fois depuis des décennies, Nvidia n'a d'ailleurs quasiment rien proposé de nouveau pour les joueurs en 2026. Tout est parti vers les serveurs et l'IA. Mais comme on dit, la nature a horreur du vide. Le marché grand public ne va pas disparaître parce que Nvidia décide de le mettre de côté. Quelqu'un finira forcément par prendre la place laissée libre.
 
Les USA, avec Nvidia, OpenAI, Anthropic et les autres, semblent également penser qu'ils peuvent refaire avec l'IA le même coup que les GAFAM. Une technologie propriétaire, fermée, contrôlée par quelques entreprises, avec des marges gigantesques. Sauf qu'il y a maintenant un problème qu'ils n'avaient pas forcément à l'époque des débuts d'Internet, la Chine et l'open source. Les modèles open source et l'IA locale progressent à une vitesse complètement folle, et surtout dans une direction qui pourrait être exactement l'inverse du modèle économique actuel. Faire mieux avec moins.
 
Des modèles plus petits, mieux entraînés, quantifiés, optimisés, capables de tourner localement sur des machines de plus en plus accessibles. Si dans quelques années, on n'a plus besoin d'un monstre à plusieurs dizaines de milliers d'euros pour faire tourner une IA performante, le modèle économique actuel des GPU hors de prix risque forcément de prendre une claque. Et c'est là que le pari chinois devient intéressant, parce qu'ils ne cherchent pas forcément à reproduire exactement le modèle américain. Ils peuvent très bien chercher à rendre l'IA suffisamment bon marché et abordable pour qu'elle se retrouve partout.  
Un exemple qui devrait commencer à inquiéter sérieusement les acteurs historiques, c'est CXMT. Il y a encore quelques années, quasiment personne ne connaissait cette entreprise en dehors du monde des semi-conducteurs. Aujourd'hui, elle est devenue un acteur majeur de la DRAM et elle construit de nouvelles capacités à une vitesse assez dingue. De nouvelles usines et lignes de production sont en préparation à Hefei, Pékin, Shanghai, avec des capacités qui doivent continuer à augmenter fortement à partir de 2027.  
Et surtout, CXMT ne se contente plus de produire de la DDR4. Ils ont développé de la DDR5, de la LPDDR5X et viennent maintenant d'annoncer la production de masse de LPDDR6. Autrement dit, on n'est plus simplement dans l'histoire d'un Chinois qui essaie de rattraper Samsung, SK Hynix ou Micron. Ils sont en train de remonter toute la chaîne technologique et commencent à arriver sur les générations les plus récentes.
 
Et là, on commence à retrouver exactement le même mécanisme qu'avec les panneaux solaires ou la voiture électrique. Les autres fabriquent avec de grosses marges, la Chine investit massivement, construit des usines, augmente les volumes, apprend, améliore les produits et fait baisser les coûts. Puis quelques années plus tard, tout le monde se réveille en se demandant comment les Chinois ont réussi à prendre une telle place sur le marché. L'entrée de CXMT en Bourse est d'ailleurs assez révélatrice de la confiance qu'il y a derrière cette stratégie. L'action a fait une hausse complètement délirante dès son premier jour de cotation, avec une valorisation qui a brièvement atteint plusieurs centaines de milliards de dollars. Et même Apple serait en train de tester les mémoires de CXMT. Ça ne veut évidemment pas dire qu'Apple va demain remplacer Samsung, SK Hynix ou Micron par CXMT, mais le simple fait qu'ils soient déjà en train de tester sérieusement leurs mémoires montre bien que la situation est en train de changer.
 
Et c'est justement là que je pense que les Américains ont peut-être fait une énorme connerie avec la RAM. Pour maximiser les profits liés à l'explosion de l'IA, une partie de l'industrie a progressivement privilégié la HBM, beaucoup plus rentable, au détriment d'une partie de la production de DDR4 et DDR5. Je comprends parfaitement le calcul financier, pourquoi vendre de la RAM classique avec de faibles marges quand on peut vendre de la HBM à prix d'or aux datacenters Nvidia ? Sauf qu'à force de faire ça, on laisse le reste du monde avec une capacité de production de RAM qui devient insuffisante. Et ça, je pense que c'est peut-être l'une des plus grosses erreurs stratégiques qu'ils aient faites. Parce que le monde ne fonctionne pas uniquement avec des GPU Nvidia et des datacenters. Il y a des millions de PC, de serveurs, de smartphones, de consoles et de machines industrielles qui ont besoin de DDR4 et DDR5. Sacrifier cette production essentiellement pour faire davantage de bénéfices sur la HBM, alors que l'IA n'en est encore qu'à ses débuts, c'est prendre un risque énorme.
 
Pendant que certains se concentrent sur les marges de la HBM, la Chine construit justement les usines qui vont lui permettre d'augmenter sa production de mémoire. Et si elle arrive à produire suffisamment de DDR4, DDR5 et progressivement les nouvelles générations à des prix compétitifs, on risque de revoir exactement le même scénario que dans le solaire et la voiture électrique. Ceux qui pensaient contrôler le marché grâce à leurs marges découvrent soudain qu'un concurrent est capable de produire beaucoup, beaucoup moins cher.
 
Il y a aussi un autre problème que je trouve complètement sous-estimé : l'IA est encore au tout début de son développement. Plus elle progresse, plus on cherche à faire la même chose avec moins de calcul et moins de mémoire. Quantification, distillation, nouveaux modèles, nouvelles architectures, optimisation du contexte, sparsité, etc. Aujourd'hui, on balance des tonnes de GPU, de VRAM et de RAM sur les problèmes parce que c'est la solution la plus simple. Mais demain, l'objectif sera justement de faire tourner des modèles beaucoup plus performants avec beaucoup moins de ressources. Et si cette tendance continue, une partie des investissements gigantesques réalisés aujourd'hui dans les datacenters pourrait se retrouver surdimensionnée beaucoup plus vite que prévu. C'est là que la situation devient vraiment dangereuse, parce que la bulle spéculative autour de l'IA est gigantesque. On parle de sommes absolument délirantes investies dans les GPU, les datacenters, la HBM, les réseaux, l'électricité et toute l'infrastructure nécessaire pour faire fonctionner cette nouvelle économie.
 
Si l'open source continue de progresser et que l'IA locale explose, le retour de bâton peut être extrêmement violent. Des infrastructures prévues pour une croissance permanente pourraient devenir beaucoup moins rentables, les commandes de GPU pourraient ralentir et toute une partie des valorisations actuelles pourrait se retrouver remise en question. Et c'est pour ça que je pense que le choix de délaisser la RAM classique pour se gaver de marges sur la HBM pourrait être une erreur stratégique majeure. Ils sont peut-être en train de gagner énormément d'argent aujourd'hui en concentrant toute leur industrie sur l'IA, tout en laissant la Chine construire tranquillement les capacités industrielles dont le monde aura besoin demain.
 
Ils sont peut-être en train de gagner la bataille des profits à court terme pour préparer une défaite industrielle à long terme.


n°48949
amaurysme
Posté le 13-09-2026 à 17:55:36  profilanswer
 

[:drapal]  
 
Je viens de m’équiper en hardware.  
Faut que je rattrape la lecture du topic :o

n°48950
moyen_moin​s
chat réincarné
Posté le 13-09-2026 à 17:58:37  profilanswer
 

au rythme où ça va, c'est surtout le manque d'énergie qui va faire chier ce petit monde de l'ia :o
c'est bien beau d'annoncer moults datacenters mais si on peut pas les alimenter...

n°48953
the_fennec
f3nn3cUs z3rd4
Posté le 13-09-2026 à 18:13:09  profilanswer
 

neo world a écrit :


oui et ça reboucle bien avec le côté boucher charcutier sur mains humaines cette fois :o
 
Sinon y'a LTT qui en veut aux cartes pas moins chers: après le BC 250 c'est au tour des CMP 170 HX d'être recommandées "au prix actuel". Pas merci Linus :o


C'est vrai qu'a $1500 une 170hx c'est un bon plan ... tant qu'elle marche. Il a quand même bien insisté avec son pote géant sur le risque d'avoir une carte qui déconne. Il parle même de gros acteurs qui en achètent des palettes, gardent celles qui marchent et mettent le reste sur ebay pour les pigeons :o Je pense que le risque d'avoir une carte défectueuse quand on la prends a l'unité est bien trop élevé maintenant.


---------------
Faudra que je teste un jour :o
n°48955
anyb0dy
Posté le 13-09-2026 à 18:22:23  profilanswer
 

epsiloncentaury a écrit :

L'IA dans un ou deux ans ne ressemblera probablement en rien à celle d'aujourd'hui.
 
Les Chinois sont peut-être en train de niquer les Ricains dans les grandes largeurs. […]
 
Ils sont peut-être en train de gagner la bataille des profits à court terme pour préparer une défaite industrielle à long terme.


J’ai un pote qui passe son temps en Chine en ce moment pour mettre au point des machines qui leur permettent de faire les PCB, ça me rend malade d’entendre que les mecs n’ont pas les briques industrielles et qu’on les leur fournit sur un plateau d’argent.
Pourquoi ses compétences (de mon pote) sont pas utilisées dans une usine européenne ? On va encore se réveiller dans 3 ans en se plaignant qu’on désindustrialise et que les chinois nous piquent le savoir faire et les parts de marché.
Mais en même temps c’est nous qui n’investissons pas. Et en l’occurrence ils ne piquent rien, en tous cas sur cette partie du process, ils achètent le matos et le consulting pour l’utiliser est offert.  [:atom1ck]

n°48956
lapin
Posté le 13-09-2026 à 18:22:31  profilanswer
 

moyen_moins a écrit :

au rythme où ça va, c'est surtout le manque d'énergie qui va faire chier ce petit monde de l'ia :o
c'est bien beau d'annoncer moults datacenters mais si on peut pas les alimenter...


Pas en France, c'est surtout aux USA et en Allemagne, et en plus les Allemands ce sont nos voisins nous pourront leurs vendre de l'électricité.
Faudra aussi augmenter la capacité de transport d'électricité entre la France et l'angleterre.

n°48959
epsiloncen​taury
Posté le 13-09-2026 à 18:40:39  profilanswer
 

moyen_moins a écrit :

au rythme où ça va, c'est surtout le manque d'énergie qui va faire chier ce petit monde de l'ia :o
c'est bien beau d'annoncer moults datacenters mais si on peut pas les alimenter...


Oui, le manque d'énergie est un problème très sérieux, mais pour moi c'est presque un problème annexe. Le problème fondamental est beaucoup plus idéologique , celui d'un Occident qui perd progressivement de sa puissance industrielle et où l'appât du gain à court terme a fini par prendre le pas sur pratiquement tout le reste, y compris la vision à long terme. L'Europe meurt a cause de cette perte vision..


C logique a déjà progressivement mis la main sur une grande partie de ce qui était autrefois beaucoup plus libre. Les jeux vidéo, les films, la musique, les livres, etc. Internet devait permettre une diffusion beaucoup plus libre et beaucoup moins chère de la culture. Au lieu de ça, on a vu émerger le streaming, Netflix et compagnie, qui ont repris le contrôle de cette distribution et nous vendent sous abonnement ce qui, technologiquement, pourrait être accessible beaucoup plus librement. Et maintenant, cette même logique arrive dans l'IA, transformer une technologie potentiellement extrêmement accessible en une nouvelle rente, contrôlée par quelques entreprises, avec des modèles fermés et des abonnements. Sauf que cette fois, un acteur majeur est entré dans le jeu, la Chine. Elle mise sur l'open source, le volume, les coûts faibles et une stratégie industrielle qui peut être pensée sur le long terme.


Et cette guerre entre le libre et le fermé, on la voit déjà très concrètement avec Hugging Face. Nvidia vient de mettre 12,9 milliards de dollars sur la table pour racheter la plateforme qui est devenue l'un des principaux centres mondiaux des modèles open source. C'est flagrant...


C'est ça qui me paraît beaucoup plus dangereux pour le modèle américain que le simple problème de l'énergie. Parce que si l'IA devient une commodité, performante, open source et capable de tourner localement, tout le modèle construit autour des GPU hors de prix, des datacenters gigantesques et des modèles propriétaires peut prendre une sacrée claque.


Message édité par epsiloncentaury le 13-09-2026 à 18:44:51
n°48962
M300A
Posté le 13-09-2026 à 19:26:49  profilanswer
 

C'est pas des suppositions c'est ce qui est entrain de se passer.


---------------
:wq
n°48963
M300A
Posté le 13-09-2026 à 19:29:02  profilanswer
 

Je commence à lire des gars qui tente de faire tourner DS4.1 Flash sur 2 RTX 6000. Même si le tarif est délirant actuellement, ça reste peanuts pour une entreprise. Imaginons maintenant que quelqu'un se sorte les doigts et sorte un GPU concurrentiel qui renverrait les RTX 6000 à leur prix normal (6k).. Game over.


---------------
:wq
n°48966
neo world
Posté le 13-09-2026 à 19:40:06  profilanswer
 

M300A a écrit :

Je commence à lire des gars qui tente de faire tourner DS4.1 Flash sur 2 RTX 6000. Même si le tarif est délirant actuellement, ça reste peanuts pour une entreprise. Imaginons maintenant que quelqu'un se sorte les doigts et sorte un GPU concurrentiel qui renverrait les RTX 6000 à leur prix normal (6k).. Game over.


à 6k la carte le business de Nvidia n'a aucun mal à tourner :o

n°48967
M300A
Posté le 13-09-2026 à 19:41:18  profilanswer
 

Par contre celui de Dario... :o


---------------
:wq
n°48968
the_fennec
f3nn3cUs z3rd4
Posté le 13-09-2026 à 19:59:04  profilanswer
 

Bon un peu de "mouvement", la RTX 4060Ti 16GB est passée sur une VM Debian 14 avec 32GB de RAM. C'est un peu crado, mais les modèles sont chargés via un montage SMB, pas de différence de vitesse notable. Tout fonctionne bien, j'ai tenté les driver nouveau, mais ça marchait pas top, je suis passé sur les drivers NVidia sans CUDA, just Vulkan pour le moment. Le TG/s est bon, mais le PP/s est pas top, je monte pas a plus de 100/s.
 
J'ai mis Qwen 27B sur le coup, tune toit tout seul :o Il a trouvé que mon -b/-ub était trop bas, un reste de Qwen Next je pense. La je le laisse bosser seul en mode YOLO avec l'agent de llama.cpp on verra bien :o.


---------------
Faudra que je teste un jour :o
n°48969
neo world
Posté le 13-09-2026 à 20:01:34  profilanswer
 

il s'autotune ? genre en mode je scie la branche sur laquelle je suis assis ? :o

n°48971
neo world
Posté le 13-09-2026 à 20:02:10  profilanswer
 

amaurysme a écrit :

[:drapal]  
 
Je viens de m’équiper en hardware.  
Faut que je rattrape la lecture du topic :o


bienvenue, hésite pas si tu as des questions ou des précisions sur ton besoin :D

n°48972
neo world
Posté le 13-09-2026 à 20:03:36  profilanswer
 

M300A a écrit :

Par contre celui de Dario... :o


enfin si celui de Dario se pète la gueule l'indisponibilité du endpoint Anthropic sera notre dernier problème  [:jacques friggit]  :o

n°48980
M300A
Posté le 13-09-2026 à 21:05:57  profilanswer
 

neo world a écrit :


enfin si celui de Dario se pète la gueule l'indisponibilité du endpoint Anthropic sera notre dernier problème  [:jacques friggit]  :o


C'est inévitable, on va voir ce qui va se passer :o
En vrai j'ai l'impression que c'est le cadet de nos soucis, les finances de la France sont dans le rouge, la guerre est à la porte de l'UE et il a pas plus quasiment depuis 4 mois dans le nord-est.


Tout va bien  [:apaucalyptik]


---------------
:wq
n°48981
the_fennec
f3nn3cUs z3rd4
Posté le 13-09-2026 à 21:15:24  profilanswer
 

neo world a écrit :

il s'autotune ? genre en mode je scie la branche sur laquelle je suis assis ? :o


Ça l'occupe, la il a cloné le git de llama.cpp, c'est probablement la meilleure solution pour trouver la doc :o


---------------
Faudra que je teste un jour :o
n°48983
neo world
Posté le 13-09-2026 à 21:24:24  profilanswer
 

the_fennec a écrit :


Ça l'occupe, la il a cloné le git de llama.cpp, c'est probablement la meilleure solution pour trouver la doc :o


Déjà il tabasse pas uniquement en HTTP. Y’a les mainteneurs des repos du kernel Linux qui se plaignent qu’en gros 80% des ressources sont mobilisées pour répondre à des accès en HTTP de bots IA alors que ce serait beaucoup plus efficace via git clone

n°48985
neo world
Posté le 13-09-2026 à 21:38:46  profilanswer
 

M300A a écrit :


C'est inévitable, on va voir ce qui va se passer :o
En vrai j'ai l'impression que c'est le cadet de nos soucis, les finances de la France sont dans le rouge, la guerre est à la porte de l'UE et il a pas plus quasiment depuis 4 mois dans le nord-est.
 
Tout va bien  [:apaucalyptik]


Pour moi openAI et Anthropic sont too big to fail. Gemini aura aucun soucis à passer la tempête, meta pareil. La plupart des labs IA chinoise ont le même modele avec des activités super rentables en parallèle. J’imagine sans problème un hiver nucléaire quand quelqu’un avec un peu trop de sous dans le game mais pas assez de sang froid retirera un peu vite son pécule mais j’imagine que c’est les petits porteurs / investisseurs tarés qui y passeront plus que les grosses boites. Mais on verra bien ^^

n°48986
the_fennec
f3nn3cUs z3rd4
Posté le 13-09-2026 à 21:39:29  profilanswer
 

neo world a écrit :


Déjà il tabasse pas uniquement en HTTP. Y’a les mainteneurs des repos du kernel Linux qui se plaignent qu’en gros 80% des ressources sont mobilisées pour répondre à des accès en HTTP de bots IA alors que ce serait beaucoup plus efficace via git clone


Premier round:

Citation :

Proposed optimizations (priority order)
 
    Measure first (5 min, and it decides everything else): uncomment GGML_RPC_DEBUG=1 in llama-server.sh and add export GGML_SCHED_DEBUG=1 (the sched honors it — I saw it in ggml-backend.cpp). You'll get per-split timing and per-handoff sizes: it will show whether the killer is stage compute, transfer time, or the CPU split.
    Kill the CPU split. From the sched debug, identify which ops land on CPU. If it's a handful of unsupported ops, either update llama.cpp (build 10909) or pin them to Vulkan with a --tensor-buft-override. Removing 1 of the 4 stages removes 2 of the 3 handoffs plus all CPU compute.
    Balance the split: -ts 1,1,1 → 21/21/22 layers (only if the remote GPUs are as fast as the 4060 Ti; otherwise skew toward the faster device). The current 17/18/29 is almost certainly not optimal.
    Double the ubatch: -ub 2048 (matching -b). Halves the number of ubatches → halves handoffs, syncs and scheduler overhead. Memory headroom is fine (free: lain 10.0 GiB, arisu 9.4 GiB, Vulkan 4.4 GiB; compute buffers grow ~1.4 → ~2.8 GiB).
    Check the link: iperf3 magi↔lain / magi↔arisu. If it's 1 GbE (or worse), upgrading to 10 GbE is worth ~10% pp by itself; if it's 10 GbE already, the transfer cost is gone and #1–#4 are where the time is.
    Decide if 256k is actually needed — you're not getting it (fit cut it to 128k). If you are: move 1–2 attention layers off Vulkan (KV is 4/5/7 per device; e.g. rebalance to 5/6/5) or drop -ctk q4_0 -ctv q4_0 (≈45% less KV memory). If not: set --ctx-size 131072 explicitly so the fit step stops silently rewriting your config.
    Structural ceiling: even after all of the above, pp is capped at the sum of the stage times across 3 machines. If a single 24 GB GPU is ever in the picture, the whole model + 128k KV fits on it and you skip the pipeline entirely (expect ~2–3× the current pp). Short of that, consider whether both remotes are needed — 2 machines = 3 stages = 2 handoffs instead of 3.


---------------
Faudra que je teste un jour :o
n°48988
neo world
Posté le 13-09-2026 à 21:48:39  profilanswer
 

the_fennec a écrit :


Premier round:

Citation :

Proposed optimizations (priority order)
 
    Measure first (5 min, and it decides everything else): uncomment GGML_RPC_DEBUG=1 in llama-server.sh and add export GGML_SCHED_DEBUG=1 (the sched honors it — I saw it in ggml-backend.cpp). You'll get per-split timing and per-handoff sizes: it will show whether the killer is stage compute, transfer time, or the CPU split.
    Kill the CPU split. From the sched debug, identify which ops land on CPU. If it's a handful of unsupported ops, either update llama.cpp (build 10909) or pin them to Vulkan with a --tensor-buft-override. Removing 1 of the 4 stages removes 2 of the 3 handoffs plus all CPU compute.
    Balance the split: -ts 1,1,1 → 21/21/22 layers (only if the remote GPUs are as fast as the 4060 Ti; otherwise skew toward the faster device). The current 17/18/29 is almost certainly not optimal.
    Double the ubatch: -ub 2048 (matching -b). Halves the number of ubatches → halves handoffs, syncs and scheduler overhead. Memory headroom is fine (free: lain 10.0 GiB, arisu 9.4 GiB, Vulkan 4.4 GiB; compute buffers grow ~1.4 → ~2.8 GiB).
    Check the link: iperf3 magi↔lain / magi↔arisu. If it's 1 GbE (or worse), upgrading to 10 GbE is worth ~10% pp by itself; if it's 10 GbE already, the transfer cost is gone and #1–#4 are where the time is.
    Decide if 256k is actually needed — you're not getting it (fit cut it to 128k). If you are: move 1–2 attention layers off Vulkan (KV is 4/5/7 per device; e.g. rebalance to 5/6/5) or drop -ctk q4_0 -ctv q4_0 (≈45% less KV memory). If not: set --ctx-size 131072 explicitly so the fit step stops silently rewriting your config.
    Structural ceiling: even after all of the above, pp is capped at the sum of the stage times across 3 machines. If a single 24 GB GPU is ever in the picture, the whole model + 128k KV fits on it and you skip the pipeline entirely (expect ~2–3× the current pp). Short of that, consider whether both remotes are needed — 2 machines = 3 stages = 2 handoffs instead of 3.


let me know si un prêt moyen sur quelques mois de deux cartes 5gb/s usb 3.2 t'aiderait dans tes tests de perf :D
 
C'était quoi les perfs de ton modèle avant qu'il commence à tout casser pour voir ? :o

n°49000
the_fennec
f3nn3cUs z3rd4
Posté le 13-09-2026 à 22:43:06  profilanswer
 

neo world a écrit :


let me know si un prêt moyen sur quelques mois de deux cartes 5gb/s usb 3.2 t'aiderait dans tes tests de perf :D
 
C'était quoi les perfs de ton modèle avant qu'il commence à tout casser pour voir ? :o


Je suis repassé en 1GB, je pense que j'ai cramé ma carte 10GB :cry:
J'ai deux cartes 2.5GB en USB, mais ça n'avait pas changé grand-chose quand j'ai testé.
 
Je suis sur 27B, la je plafonne a 100 en PP, il me semblait être beaucoup plus haut sous Windows avec le modèle a 100% en VRAM juste sur la 4060Ti (Q3_XS).
 
La j'ai chargé le Q6 en RPC pour le laisser cogiter.
 
Maintenant que je suis 100% sous Linux je voudrais tester de modifier le server RPC pour passer en P2P. Le problème du RPC est que le llama-server dirige tout, donc les requêtes font des aller-retours. L'idée serait que chaque nœud RPC passe le calcul a son voisin au lieu de repasser par le server.


---------------
Faudra que je teste un jour :o
n°49011
neo world
Posté le 14-09-2026 à 01:06:45  profilanswer
 

Nouvelle version d'Halogen avec enfin la possibilité d'utiliser des gguf classique (bon il précise que ça cible plutôt les versions 4 bits mais c'est pas dit que ça fonctionne avec autre chose si on a de la chance) :
https://github.com/peonist-ai/halog [...] r-own-gguf
 
version open source toujours en cours de préparation. Pas d'ETA (le message a 3 heures) :
 

Citation :

soon™
 
I hate to say "when its done". What I can tell you is I'm validating the tuning loop. Its working, it just takes time. I only have a single Strix Halo and its just me working on this right now.


n°49027
extenue1
Posté le 14-09-2026 à 08:39:56  profilanswer
 

epsiloncentaury a écrit :

L'IA dans un ou deux ans ne ressemblera probablement en rien à celle d'aujourd'hui.


Les Chinois sont peut-être en train de niquer les Ricains dans les grandes largeurs. Et Nvidia, à mon avis, est en train de faire un pari particulièrement risqué en misant quasiment tout sur les modèles fermés, les datacenters et les marges énormes de l'IA, tout en délaissant progressivement le marché des joueurs. Certes, Nvidia est assis sur des centaines de milliards et peut se permettre énormément de choses, mais avoir énormément de pognon ne veut pas forcément dire qu'on a misé sur le bon cheval.


Pour la première fois depuis des décennies, Nvidia n'a d'ailleurs quasiment rien proposé de nouveau pour les joueurs en 2026. Tout est parti vers les serveurs et l'IA. Mais comme on dit, la nature a horreur du vide. Le marché grand public ne va pas disparaître parce que Nvidia décide de le mettre de côté. Quelqu'un finira forcément par prendre la place laissée libre.


Les USA, avec Nvidia, OpenAI, Anthropic et les autres, semblent également penser qu'ils peuvent refaire avec l'IA le même coup que les GAFAM. Une technologie propriétaire, fermée, contrôlée par quelques entreprises, avec des marges gigantesques. Sauf qu'il y a maintenant un problème qu'ils n'avaient pas forcément à l'époque des débuts d'Internet, la Chine et l'open source. Les modèles open source et l'IA locale progressent à une vitesse complètement folle, et surtout dans une direction qui pourrait être exactement l'inverse du modèle économique actuel. Faire mieux avec moins.


Des modèles plus petits, mieux entraînés, quantifiés, optimisés, capables de tourner localement sur des machines de plus en plus accessibles. Si dans quelques années, on n'a plus besoin d'un monstre à plusieurs dizaines de milliers d'euros pour faire tourner une IA performante, le modèle économique actuel des GPU hors de prix risque forcément de prendre une claque. Et c'est là que le pari chinois devient intéressant, parce qu'ils ne cherchent pas forcément à reproduire exactement le modèle américain. Ils peuvent très bien chercher à rendre l'IA suffisamment bon marché et abordable pour qu'elle se retrouve partout.
Un exemple qui devrait commencer à inquiéter sérieusement les acteurs historiques, c'est CXMT. Il y a encore quelques années, quasiment personne ne connaissait cette entreprise en dehors du monde des semi-conducteurs. Aujourd'hui, elle est devenue un acteur majeur de la DRAM et elle construit de nouvelles capacités à une vitesse assez dingue. De nouvelles usines et lignes de production sont en préparation à Hefei, Pékin, Shanghai, avec des capacités qui doivent continuer à augmenter fortement à partir de 2027.
Et surtout, CXMT ne se contente plus de produire de la DDR4. Ils ont développé de la DDR5, de la LPDDR5X et viennent maintenant d'annoncer la production de masse de LPDDR6. Autrement dit, on n'est plus simplement dans l'histoire d'un Chinois qui essaie de rattraper Samsung, SK Hynix ou Micron. Ils sont en train de remonter toute la chaîne technologique et commencent à arriver sur les générations les plus récentes.


Et là, on commence à retrouver exactement le même mécanisme qu'avec les panneaux solaires ou la voiture électrique. Les autres fabriquent avec de grosses marges, la Chine investit massivement, construit des usines, augmente les volumes, apprend, améliore les produits et fait baisser les coûts. Puis quelques années plus tard, tout le monde se réveille en se demandant comment les Chinois ont réussi à prendre une telle place sur le marché. L'entrée de CXMT en Bourse est d'ailleurs assez révélatrice de la confiance qu'il y a derrière cette stratégie. L'action a fait une hausse complètement délirante dès son premier jour de cotation, avec une valorisation qui a brièvement atteint plusieurs centaines de milliards de dollars. Et même Apple serait en train de tester les mémoires de CXMT. Ça ne veut évidemment pas dire qu'Apple va demain remplacer Samsung, SK Hynix ou Micron par CXMT, mais le simple fait qu'ils soient déjà en train de tester sérieusement leurs mémoires montre bien que la situation est en train de changer.


Et c'est justement là que je pense que les Américains ont peut-être fait une énorme connerie avec la RAM. Pour maximiser les profits liés à l'explosion de l'IA, une partie de l'industrie a progressivement privilégié la HBM, beaucoup plus rentable, au détriment d'une partie de la production de DDR4 et DDR5. Je comprends parfaitement le calcul financier, pourquoi vendre de la RAM classique avec de faibles marges quand on peut vendre de la HBM à prix d'or aux datacenters Nvidia ? Sauf qu'à force de faire ça, on laisse le reste du monde avec une capacité de production de RAM qui devient insuffisante. Et ça, je pense que c'est peut-être l'une des plus grosses erreurs stratégiques qu'ils aient faites. Parce que le monde ne fonctionne pas uniquement avec des GPU Nvidia et des datacenters. Il y a des millions de PC, de serveurs, de smartphones, de consoles et de machines industrielles qui ont besoin de DDR4 et DDR5. Sacrifier cette production essentiellement pour faire davantage de bénéfices sur la HBM, alors que l'IA n'en est encore qu'à ses débuts, c'est prendre un risque énorme.


Pendant que certains se concentrent sur les marges de la HBM, la Chine construit justement les usines qui vont lui permettre d'augmenter sa production de mémoire. Et si elle arrive à produire suffisamment de DDR4, DDR5 et progressivement les nouvelles générations à des prix compétitifs, on risque de revoir exactement le même scénario que dans le solaire et la voiture électrique. Ceux qui pensaient contrôler le marché grâce à leurs marges découvrent soudain qu'un concurrent est capable de produire beaucoup, beaucoup moins cher.


Il y a aussi un autre problème que je trouve complètement sous-estimé : l'IA est encore au tout début de son développement. Plus elle progresse, plus on cherche à faire la même chose avec moins de calcul et moins de mémoire. Quantification, distillation, nouveaux modèles, nouvelles architectures, optimisation du contexte, sparsité, etc. Aujourd'hui, on balance des tonnes de GPU, de VRAM et de RAM sur les problèmes parce que c'est la solution la plus simple. Mais demain, l'objectif sera justement de faire tourner des modèles beaucoup plus performants avec beaucoup moins de ressources. Et si cette tendance continue, une partie des investissements gigantesques réalisés aujourd'hui dans les datacenters pourrait se retrouver surdimensionnée beaucoup plus vite que prévu. C'est là que la situation devient vraiment dangereuse, parce que la bulle spéculative autour de l'IA est gigantesque. On parle de sommes absolument délirantes investies dans les GPU, les datacenters, la HBM, les réseaux, l'électricité et toute l'infrastructure nécessaire pour faire fonctionner cette nouvelle économie.


Si l'open source continue de progresser et que l'IA locale explose, le retour de bâton peut être extrêmement violent. Des infrastructures prévues pour une croissance permanente pourraient devenir beaucoup moins rentables, les commandes de GPU pourraient ralentir et toute une partie des valorisations actuelles pourrait se retrouver remise en question. Et c'est pour ça que je pense que le choix de délaisser la RAM classique pour se gaver de marges sur la HBM pourrait être une erreur stratégique majeure. Ils sont peut-être en train de gagner énormément d'argent aujourd'hui en concentrant toute leur industrie sur l'IA, tout en laissant la Chine construire tranquillement les capacités industrielles dont le monde aura besoin demain.


Ils sont peut-être en train de gagner la bataille des profits à court terme pour préparer une défaite industrielle à long terme.


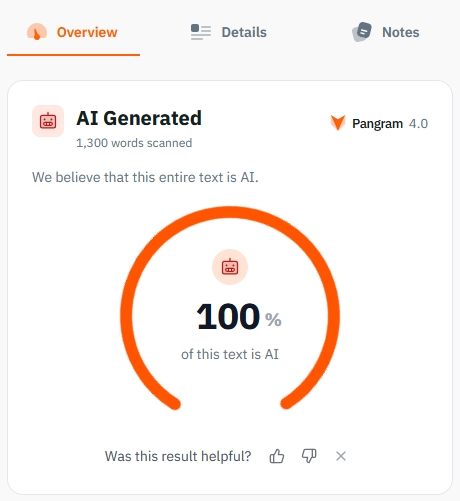
T'as utilisé de l'IA locale ou cloud pour generer ce post ?

n°49043
speedboyz3​0
Guide Michelin :o
Posté le 14-09-2026 à 09:26:54  profilanswer
 

extenue1 a écrit :


T'as utilisé de l'IA locale ou cloud pour generer ce post ?


En tout cas c'est bien trop long pour être lisible.
TL:DR  [:so-saugrenu2:2]

n°49044
speedboyz3​0
Guide Michelin :o
Posté le 14-09-2026 à 09:31:56  profilanswer
 

extenue1 a écrit :


T'as utilisé de l'IA locale ou cloud pour generer ce post ?


https://rehost.diberie.com/Picture/Get/f/543896
 
Ça mérite un down-vote  [:corten:1]

 Page :   1  2  3  4  5  ..  64  65  66  67  68  69

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)