Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4218 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  13  14  15  ..  66  67  68  69  70  71
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°38462
the_fennec
f3nn3cUs z3rd4
Posté le 09-06-2026 à 20:23:41  profilanswer
 

Reprise du message précédent :

totosssfr a écrit :

Salut,  
L'OS est une ubuntu server 24.04 lts avec un kernel 6.17.
Le kernel 6.8 livré avec ubuntu 24.04 ne supporte pas la B60.
La machine est entièrement dédiée au llm.
Mon objectif :  
- développement assisté par IA C# et ASP.Net sous vs code /visual studio pro.
- développer des applis utilisant les capacités IA pour aider les commerciaux à créer des devis de manière semi automatique à partir de photos.
 
Si c'est efficace, j'investirai dans une seconde arc B60 afin d'atteindre 48 Go en local et je commencerai à négocier pour obtenir une machine de ce genre (plus musclée et sous nvidia) dans ma cogip.
 
J'étais initialement parti sur une arc B70 pro ou une R9700 pour les 32 Go de VRAM mais le Z4 G4 est limité par son alim 750w: j'aurai été limité à une seule carte. J'ai préféré partir sur une seule B60 (conso raisonnable) en espérant en prendre une seconde plus tard. Le budget d'une seule R9700 paie les deux B60.


CPU?RAM?
quel models?
25 tg/s c'est pas beaucoup


---------------
Faudra que je teste un jour :o
n°38463
the_fennec
f3nn3cUs z3rd4
Posté le 09-06-2026 à 20:30:33  profilanswer
 

Pipould's a écrit :


Tu split la charge comment entre la 4060Ti et la BC250 ? llama rpc ? pool d'agents independants ?  


J'ai un llama RPC sur la BC250 (Debian 14 kernel 7.0) et un llama-server sous Windows 2019 avec la 4060Ti 16GB. Avant j'avais un split plus ou moins 45/55 selon les modèles, (-ts) mais je trouve la perf plus stable en 50/50.  
Tu veux dire quoi par pool d'agents?


---------------
Faudra que je teste un jour :o
n°38474
Jules Winn​field
порой не та...
Posté le 09-06-2026 à 20:43:35  profilanswer
 

the_fennec a écrit :


J'ai un llama RPC sur la BC250 (Debian 14 kernel 7.0) et un llama-server sous Windows 2019 avec la 4060Ti 16GB. Avant j'avais un split plus ou moins 45/55 selon les modèles, (-ts) mais je trouve la perf plus stable en 50/50.  
Tu veux dire quoi par pool d'agents?


 [:hide]  

n°38496
Pipould's
Posté le 09-06-2026 à 21:15:40  profilanswer
 

the_fennec a écrit :


J'ai un llama RPC sur la BC250 (Debian 14 kernel 7.0) et un llama-server sous Windows 2019 avec la 4060Ti 16GB. Avant j'avais un split plus ou moins 45/55 selon les modèles, (-ts) mais je trouve la perf plus stable en 50/50.  
Tu veux dire quoi par pool d'agents?


Pool d'agents, genre tu fais tourner des models differents sur different hardwares.
 
Et ca tourne bien avec le model split comme ca? J'avais lu que les perfs en RPC etaient pourries...

n°38541
the_fennec
f3nn3cUs z3rd4
Posté le 09-06-2026 à 22:35:08  profilanswer


J'étais le premier surpris, j'ai installé une 13, mais je suis en sid, donc j'ai du uprade sans faire attention:

Code :
  1. Linux lain 7.0.4+deb14-amd64 #1 SMP PREEMPT_DYNAMIC Debian 7.0.4-1 (2026-05-07) x86_64 GNU/Linux


Pipould's a écrit :


Pool d'agents, genre tu fais tourner des models differents sur different hardwares.
 
Et ca tourne bien avec le model split comme ca? J'avais lu que les perfs en RPC etaient pourries...


Non je préfère un gros modèle, que plusieurs petits. Surtout il faut bien 5 minutes pour charger le modèle en RPC, mais je le fais pas souvent donc ça me dérange pas.
 
Je trouve que ça tourne pas mal du tout. Avec 35B en "non MTP" je fais dans les 250 t/s en pp et 40/50 tg/s. 27B est beaucoup plus lent 80/9.
Le MTP boost bien le tg/s mais c'est surtout le pp qui m'intéresse et en plus les modèles MTP prennent beaucoup plus de VRAM. Tu peux filter mon pseudo sur les pages précédentes pour voir mes retours.
 
Par contre je trouve qu'après plusieurs jours de processing les perfs tombent, la claude tourne tout seul depuis 2 jours et 11h et je suis a 60 en pp et 9 en tg/s.
 
La je suis en split par défaut "layers" et le processing est séquentiel, j'ai pas réussi a faire marcher le mode "tensor", je sais pas si c'est a cause de RPC ou Vulkan+CUDA.


---------------
Faudra que je teste un jour :o
n°38543
totosssfr
Pousse-testa
Posté le 09-06-2026 à 22:44:45  profilanswer
 

the_fennec a écrit :


CPU?RAM?
quel models?
25 tg/s c'est pas beaucoup


Xeon w-2145 (8c/16t 3.7/4,5 ghz) accompagné de 96 go  ddr4 ecc 2400.


Je n'ai joué que quelques heures avec (je n'ai rien peaufiné, tous mes test ont été réalisés avec les paramètres par défaut ).
Il me semble que j'ai obtenu 26 tg/s sur gpt oss 20b. C'est pas beaucoup en effet.


Essayer d'améliorer les perfs fait partie du challenge.


@+


---------------
Pousse tarasse forever.
n°38546
Pipould's
Posté le 09-06-2026 à 22:49:55  profilanswer
 

the_fennec a écrit :


J'étais le premier surpris, j'ai installé une 13, mais je suis en sid, donc j'ai du uprade sans faire attention:

Code :
  1. Linux lain 7.0.4+deb14-amd64 #1 SMP PREEMPT_DYNAMIC Debian 7.0.4-1 (2026-05-07) x86_64 GNU/Linux


the_fennec a écrit :


Non je préfère un gros modèle, que plusieurs petits. Surtout il faut bien 5 minutes pour charger le modèle en RPC, mais je le fais pas souvent donc ça me dérange pas.
 
Je trouve que ça tourne pas mal du tout. Avec 35B en "non MTP" je fais dans les 250 t/s en pp et 40/50 tg/s. 27B est beaucoup plus lent 80/9.
Le MTP boost bien le tg/s mais c'est surtout le pp qui m'intéresse et en plus les modèles MTP prennent beaucoup plus de VRAM. Tu peux filter mon pseudo sur les pages précédentes pour voir mes retours.
 
Par contre je trouve qu'après plusieurs jours de processing les perfs tombent, la claude tourne tout seul depuis 2 jours et 11h et je suis a 60 en pp et 9 en tg/s.
 
La je suis en split par défaut "layers" et le processing est séquentiel, j'ai pas réussi a faire marcher le mode "tensor", je sais pas si c'est a cause de RPC ou Vulkan+CUDA.


Erf... Je suis a viser les 500 pp sur le strix et les 1500 pp sur le dual 3090...  
 
Les TPS ca me derange pas trop que ca soit lent, mais remonter un contexte... jesus.

n°38559
the_fennec
f3nn3cUs z3rd4
Posté le 09-06-2026 à 23:21:32  profilanswer
 

totosssfr a écrit :


Xeon w-2145 (8c/16t 3.7/4,5 ghz) accompagné de 96 go  ddr4 ecc 2400.
 
Je n'ai joué que quelques heures avec (je n'ai rien peaufiné, tous mes test ont été réalisés avec les paramètres par défaut ).
Il me semble que j'ai obtenu 26 tg/s sur gpt oss 20b. C'est pas beaucoup en effet.
 
Essayer d'améliorer les perfs fait partie du challenge.
 
@+


Laisse tomber gpt oss 20b, c'est un vieux truc. Utilises Qwen3.6 35B  [:perco_35:2]


---------------
Faudra que je teste un jour :o
n°38560
the_fennec
f3nn3cUs z3rd4
Posté le 09-06-2026 à 23:23:41  profilanswer
 

Pipould's a écrit :


Erf... Je suis a viser les 500 pp sur le strix et les 1500 pp sur le dual 3090...  
 
Les TPS ca me derange pas trop que ca soit lent, mais remonter un contexte... jesus.


Clair que 10 minutes pour compacter 65K c'est un peu long :o mais OSEF quand ça tourne h24 ...


---------------
Faudra que je teste un jour :o
n°38564
Jules Winn​field
порой не та...
Posté le 10-06-2026 à 00:01:07  profilanswer
 

the_fennec a écrit :


J'étais le premier surpris, j'ai installé une 13, mais je suis en sid, donc j'ai du uprade sans faire attention:

Code :
  1. Linux lain 7.0.4+deb14-amd64 #1 SMP PREEMPT_DYNAMIC Debian 7.0.4-1 (2026-05-07) x86_64 GNU/Linux


Je viens de voir oui, Debian 14 Forky dispo depuis quelques temps en testing.
J'apprends quelque chose :jap:

n°38612
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 10:24:08  profilanswer
 

Introducing North Mini Code: Cohere’s First Model For Developers
https://huggingface.co/blog/CohereL [...] -mini-code
 

Citation :

Today, we are releasing North Mini Code, a 30B-parameter Mixture-of-Experts model with 3B active parameters with powerful agentic coding capabilities, available on Hugging Face under the Apache 2.0 license.
 
North Mini Code is the first model in Cohere’s new family of models, and is specifically designed and trained for agentic software engineering tasks.


https://cdn-uploads.huggingface.co/production/uploads/6361a793c12a09b8a3184bff/f8NXK5yKtc6xE-hJ4XWbd.png
 
https://huggingface.co/unsloth/North-Mini-Code-1.0-GGUF
https://i.imgur.com/sOaiISz.png
 

Citation :


These are GGUF quants of North-Mini-Code-1.0. The model uses the cohere2moe architecture, which is not in a stock llama.cpp release yet. Until llama.cpp PR https://github.com/ggml-org/llama.cpp/pull/24260 is merged, build llama.cpp from that PR branch to load these files. Once the PR lands in a release, these same GGUFs will run on stock llama.cpp with no re-download, because they already declare general.architecture = cohere2moe.


Mieux que Gemma en dessous de Qwen, mais c'est bien d'avoir un nouveau joueur pour titiller Alibaba, ça les motivera peut être a sortir la 3.7 :love:


---------------
Faudra que je teste un jour :o
n°38634
Jules Winn​field
порой не та...
Posté le 10-06-2026 à 12:43:36  profilanswer
 

NVIDIA® DGX™ Spark officiel dispo sur Ali
N'oubliez pas d'ajouter le coupon -65€ avant de cliquer sur payer.
De rien :jap:

n°38636
Pipould's
Posté le 10-06-2026 à 12:53:55  profilanswer
 

Jules Winnfield a écrit :

NVIDIA® DGX™ Spark officiel dispo sur Ali
N'oubliez pas d'ajouter le coupon -65€ avant de cliquer sur payer.
De rien :jap:


Le prix...lol

n°38638
totosssfr
Pousse-testa
Posté le 10-06-2026 à 13:58:43  profilanswer
 

the_fennec a écrit :


Laisse tomber gpt oss 20b, c'est un vieux truc. Utilises Qwen3.6 35B  [:perco_35:2]


gpt oss a juste été utilisé pour comparaison avec certains benchs online. :)  
Depuis aujourd'hui, je teste le chat avec gemma4-26B qui est aussi un MoE comme Qwen3.6-35B.  
Prompt processing : 400+t/s
Pour le reste, on est toujours sur 20tg/s
 
C'est exploitable.   [:barthaliastoxik]  
Je vais me pencher sur la possibilité de faire tourner perplexica/vane pour améliorer les discussions avec mes chatbot et voir s'ils arrêtent de me conseiller des solutions pré 2025.

n°38641
croustx
Modoadorateur
Posté le 10-06-2026 à 14:31:31  profilanswer
 
n°38643
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 14:33:43  profilanswer
 

totosssfr a écrit :


gpt oss a juste été utilisé pour comparaison avec certains benchs online. :)  
Depuis aujourd'hui, je teste le chat avec gemma4-26B qui est aussi un MoE comme Qwen3.6-35B.  
Prompt processing : 400+t/s
Pour le reste, on est toujours sur 20tg/s
 
C'est exploitable.   [:barthaliastoxik]  
Je vais me pencher sur la possibilité de faire tourner perplexica/vane pour améliorer les discussions avec mes chatbot et voir s'ils arrêtent de me conseiller des solutions pré 2025.


C'est pas trop mal, faut voir avec un contexte plein par contre...


---------------
Faudra que je teste un jour :o
n°38644
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 14:35:13  profilanswer


Il n'y de 3090 que le titre, en dessous ce sont des 3060/3070/3080.


---------------
Faudra que je teste un jour :o
n°38645
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 10-06-2026 à 14:39:21  profilanswer
 

Autant prendre deux 3060 12gb, c'est le meilleur ratio prix/vram à mon sens, ca reste rationnel en consommation , pas trop dur de caser ça dans une vraie tour classique et pas besoin d'avoir des quantitée de ram folle.


---------------
Victime de girafophobie, mais se soigne.
n°38646
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 14:41:33  profilanswer
 

Dans les trucs bizarroïdes :
People are making single-slot, half height pcie v100 with nvlink in China
https://old.reddit.com/r/LocalLLaMA [...] ight_pcie/
 

Citation :

The video was released on Bilibili two days ago, and the actual product is not out (for purchase) yet. But it seems real. Not an adapter, but actually soldered core on a custom PCB. Designed for passive cooling, so the default version comes with just PCIe power and capped at 75W, do have alternative version with the powerport enabled and support up to 300W though.
 
16cm length, 7.5cm height.
 
Fully functional, and retains the full performance of the core. Benchmarks are included in the video.
 
According to the video, a 32GB version is also coming.
 
They expect to sell it (16GB version) around/below ¥1500, which is around $220 US dollars. One of my friends has already pre-ordered two...
 
The creator of this called is called “显卡仙人”, which translates to "GPU god" or "The cultivator of GPU". If this is real, I guess you can really call them that.


https://www.bilibili.com/video/BV13JEa6sEtb/
 
https://i.imgur.com/6QTG9gZ.png
 
Une v100 16GB montée directement sur un PCB pcie avec un nvlink en plus :pt1cable:  
[:lol wut]


---------------
Faudra que je teste un jour :o
n°38649
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 10-06-2026 à 14:48:44  profilanswer
 

Tu trouve aussi les versions "simples" en 16gb a 200 balles :D
https://fr.aliexpress.com/item/1005011756606011.html


---------------
Victime de girafophobie, mais se soigne.
n°38654
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 15:01:31  profilanswer
 

Ouais j'ai pas mal hésité a en prendre une, mais j'ai opté pour la BC250.


---------------
Faudra que je teste un jour :o
n°38658
croustx
Modoadorateur
Posté le 10-06-2026 à 15:43:57  profilanswer
 

the_fennec a écrit :

Introducing North Mini Code: Cohere’s First Model For Developers
https://huggingface.co/blog/CohereL [...] -mini-code
 

Citation :

Today, we are releasing North Mini Code, a 30B-parameter Mixture-of-Experts model with 3B active parameters with powerful agentic coding capabilities, available on Hugging Face under the Apache 2.0 license.
 
North Mini Code is the first model in Cohere’s new family of models, and is specifically designed and trained for agentic software engineering tasks.


https://cdn-uploads.huggingface.co/ [...] J4XWbd.png
 
https://huggingface.co/unsloth/North-Mini-Code-1.0-GGUF
https://i.imgur.com/sOaiISz.png
 

Citation :


These are GGUF quants of North-Mini-Code-1.0. The model uses the cohere2moe architecture, which is not in a stock llama.cpp release yet. Until llama.cpp PR https://github.com/ggml-org/llama.cpp/pull/24260 is merged, build llama.cpp from that PR branch to load these files. Once the PR lands in a release, these same GGUFs will run on stock llama.cpp with no re-download, because they already declare general.architecture = cohere2moe.


Mieux que Gemma en dessous de Qwen, mais c'est bien d'avoir un nouveau joueur pour titiller Alibaba, ça les motivera peut être a sortir la 3.7 :love:


D'ailleurs, c'est quoi le plus malin pour faire rentrer Qwen 3.6 27B sur une carte ayant 16gb de RAM ?
 

n°38660
croustx
Modoadorateur
Posté le 10-06-2026 à 15:50:38  profilanswer
 

Tronklou a écrit :

Tu trouve aussi les versions "simples" en 16gb a 200 balles :D
https://fr.aliexpress.com/item/1005011756606011.html


2x NV100 16gb, qui sont carrément moins cher que 1x NV100 32gb :o

n°38662
Pipould's
Posté le 10-06-2026 à 15:56:32  profilanswer
 

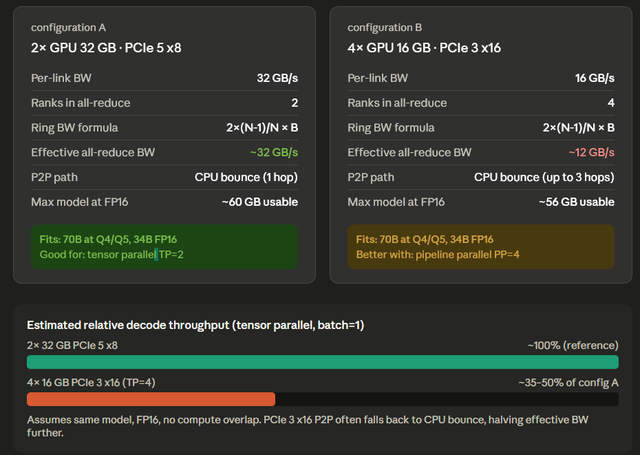
Non mais vous cablez comment X cartes des 16GB pour avoir une infra qui tient la route ?  
 
Car bon... La deja je vois j'ai pris une B850 creator pour avoir 2 pcie 5.0 en 8x...  
 
C'est pas du mining de bitcoin quoi... Tu peux pas avoir des deports en USB... Ca mange trop de perf...

n°38664
totosssfr
Pousse-testa
Posté le 10-06-2026 à 16:30:39  profilanswer
 

Beaucoup de lignes pcie = cartes mères de serveurs ou stations de travail  
 
Mon pauvre Xeon est capable de gérer 48 lignes pcie3.  
Si tu veux beaucoup de lignes pcie5, ça va te couter tes 2 reins.

n°38665
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 16:35:11  profilanswer
 

croustx a écrit :


D'ailleurs, c'est quoi le plus malin pour faire rentrer Qwen 3.6 27B sur une carte ayant 16gb de RAM ?


C'est un modèle dense, donc il faut tout dans la VRAM, un Q3_K_M fait 13.6Go:
https://huggingface.co/unsloth/Qwen3.6-27B-GGUF
 
Mais un 35B en MoE c'est mieux je pense, tu peux mettre un UD_Q4_K_M pour 22Go et mettre une partie des experts sur le CPU. Je pense que les perfs seront bien meilleures.


---------------
Faudra que je teste un jour :o
n°38666
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 16:36:56  profilanswer
 

Pipould's a écrit :

Non mais vous cablez comment X cartes des 16GB pour avoir une infra qui tient la route ?  
 
Car bon... La deja je vois j'ai pris une B850 creator pour avoir 2 pcie 5.0 en 8x...  
 
C'est pas du mining de bitcoin quoi... Tu peux pas avoir des deports en USB... Ca mange trop de perf...


Si t'es 100% en VRAM t'as plus trop besoin des lignes pcie une fois le modèle chargé non?


---------------
Faudra que je teste un jour :o
n°38668
Pipould's
Posté le 10-06-2026 à 16:53:28  profilanswer
 

the_fennec a écrit :


Si t'es 100% en VRAM t'as plus trop besoin des lignes pcie une fois le modèle chargé non?


https://i.ibb.co/gZzD962y/image.png

Message cité 1 fois
Message édité par Pipould's le 10-06-2026 à 17:02:11
n°38671
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 17:09:48  profilanswer


ça vient d'ou?
 
J'ai un Ethernet 1GB entre mes deux cartes et ça marche :o


---------------
Faudra que je teste un jour :o
n°38677
Pipould's
Posté le 10-06-2026 à 17:50:30  profilanswer
 

the_fennec a écrit :


ça vient d'ou?
 
J'ai un Ethernet 1GB entre mes deux cartes et ça marche :o


Claude ^^
 
Ok, ca marche, mais:  
 
1. Arrives-tu a charger un modele plus gros ? (je suppose que oui)
2. As-tu un meilleur prefill vs 1 carte ? Si oui, est-ce que le gain est lineaire, loga... ?  
3. As-tu une generation vs 1 carte ? Si oui, est-ce que le gain est lineaire, loga... ?  
 
Biensur sur le meme modele a taille de contexte equivalent.

Message cité 1 fois
Message édité par Pipould's le 10-06-2026 à 17:50:53
n°38682
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 10-06-2026 à 18:02:35  profilanswer
 

Si t'a la thune, vaut toujours mieux un gros gpu avec un max de vram, si t'a pas de thune ou besoin de plus de vram que ce que propose un mono gpu => tu fait du multi :D


---------------
Victime de girafophobie, mais se soigne.
n°38690
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 19:11:50  profilanswer
 

Pipould's a écrit :


Claude ^^
 
Ok, ca marche, mais:  
 
1. Arrives-tu a charger un modele plus gros ? (je suppose que oui)
2. As-tu un meilleur prefill vs 1 carte ? Si oui, est-ce que le gain est lineaire, loga... ?  
3. As-tu une generation vs 1 carte ? Si oui, est-ce que le gain est lineaire, loga... ?  
 
Biensur sur le meme modele a taille de contexte equivalent.


Les LLMs disent pas mal de conneries pour le tuning local. J'ai essayé avec Gemini et c'est a 80% de la merde, des paramètres hallucinés, des options qui ne font pas du tout ce qu'il dit qu'elles font, etc.
 
1. Oui
2. pas en RPC et surtout a cause du split=layers
3. pareil :o
 
En split=tensor ça devrait être linéaire mais je peux pas tester.
 
Pour les tests, ça va attendre :/
Je pense que j'ai un soucis avec mon server, ma VM windows a planté hier et depuis j'ai des perfs de merde :(


---------------
Faudra que je teste un jour :o
n°38725
Pipould's
Posté le 10-06-2026 à 20:27:25  profilanswer
 

Tronklou a écrit :

Si t'a la thune, vaut toujours mieux un gros gpu avec un max de vram, si t'a pas de thune ou besoin de plus de vram que ce que propose un mono gpu => tu fait du multi :D


Apres imagines tu prends 10 BC250... t'as de quoi faire un joli cluster :o

n°38741
neo world
Posté le 10-06-2026 à 21:39:51  profilanswer
 

Pipould's a écrit :


Apres imagines tu prends 10 BC250... t'as de quoi faire un joli cluster :o


C'est ce que je dis à The Fennec. A peine 3KW  [:fly_66] pour 196GB. Nickel :o

n°38776
the_fennec
f3nn3cUs z3rd4
Posté le 10-06-2026 à 23:59:20  profilanswer
 

[:je rage]  [:hurlement_primaire]  [:waterprout:2]  
 
BORDEL
 
Ca faisait des jours que je trouvais que j'avais de perfs de merde, le pp/tg qui se casse la gueule en 5 minutes et mon CPU a 100%. J'ai retesté plein de params, modèles, etc. Plein de versions de llama.cpp jusqu’à 2 semaines...
J'ai fini par trouver!!!
 
Suite a un post plus haut, j'étais passé avec un cache KV en -ctk q8_0 -ctv q5_1 qui était censé faire gagner 8% de mémoire gratos... mais pas du tout pour moi :( je repasse en -ctk q8_0 -ctv q8_0 et hop tout est réglé  :love:


---------------
Faudra que je teste un jour :o
n°38780
the_fennec
f3nn3cUs z3rd4
Posté le 11-06-2026 à 00:05:47  profilanswer
 

Pipould's a écrit :

Apres imagines tu prends 10 BC250... t'as de quoi faire un joli cluster :o


Non, je pense que doit pas scaler tant que ça.
 

neo world a écrit :

C'est ce que je dis à The Fennec. A peine 3KW  [:fly_66] pour 196GB. Nickel :o


J'y vais petit a petit :o j'attends la deuxième qui devrait pas tarder.
 
Par contre je pense qu'elle vont bien monter de prix avec le hack qui permet de monter a 40 CU gratos, le gain de perf est substantiel.


---------------
Faudra que je teste un jour :o
n°38792
Pipould's
Posté le 11-06-2026 à 07:39:23  profilanswer
 

the_fennec a écrit :

[:je rage]  [:hurlement_primaire]  [:waterprout:2]


BORDEL


Ca faisait des jours que je trouvais que j'avais de perfs de merde, le pp/tg qui se casse la gueule en 5 minutes et mon CPU a 100%. J'ai retesté plein de params, modèles, etc. Plein de versions de llama.cpp jusqu’à 2 semaines...
J'ai fini par trouver!!!


Suite a un post plus haut, j'étais passé avec un cache KV en -ctk q8_0 -ctv q5_1 qui était censé faire gagner 8% de mémoire gratos... mais pas du tout pour moi :( je repasse en -ctk q8_0 -ctv q8_0 et hop tout est réglé  :love:


Oui faut aligner les valeurs sinon ça tout la mouise.

n°38793
the_fennec
f3nn3cUs z3rd4
Posté le 11-06-2026 à 08:01:25  profilanswer
 

Pipould's a écrit :


Oui faut aligner les valeurs sinon ça tout la mouise.


Ça marchait en 8/4 il y a un moment. Pas mal de gens font des mix avec TQ. Sur beellama.cpp ça marchait aussi en 8/5.1.


---------------
Faudra que je teste un jour :o
n°38799
the_fennec
f3nn3cUs z3rd4
Posté le 11-06-2026 à 09:03:01  profilanswer
 

Une chaîne pas mal qui compare des modèles sur des prompts identiques:
https://www.youtube.com/@tokenchaser
 
Ya du local et du cloud.
(cross post topics IA locale et IA générative)


---------------
Faudra que je teste un jour :o
n°38801
Pipould's
Posté le 11-06-2026 à 09:07:24  profilanswer
 

the_fennec a écrit :


Ça marchait en 8/4 il y a un moment. Pas mal de gens font des mix avec TQ. Sur beellama.cpp ça marchait aussi en 8/5.1.


Je n'ai pas reussi a trouver de logique.. Du coup j'evite au possible les mistmatchs.

n°38853
morcok
Posté le 11-06-2026 à 12:54:45  profilanswer
 

Tronklou a écrit :

Autant prendre deux 3060 12gb, c'est le meilleur ratio prix/vram à mon sens, ca reste rationnel en consommation , pas trop dur de caser ça dans une vraie tour classique et pas besoin d'avoir des quantitée de ram folle.


Oui je trouve que la 3060 12go est un bon plan

 Page :   1  2  3  4  5  ..  13  14  15  ..  66  67  68  69  70  71

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)