Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
7475 connectés 


Au quotidien je suis


21.9 %
 7 votes
1.  Satisfait de mon setup d'inférence
 
 
21.9 %
 7 votes
2.  ça va mais c'est pas assez rapide
 
 
6.2 %
 2 votes
3.  ça va mais mon IA manque de skills
 
 
0.0 %
        0 vote
4.  ça plantouille pas mal quand même
 
 
0.0 %
        0 vote
5.  quelle IA ? j'attend la generation de modèle super intelligence rated :o
 
 
12.5 %
 4 votes
6.  Je souhaite en priorité plus de tok/s
 
 
15.6 %
 5 votes
7.  Je souhaite en priorité plus de skills (cyber, reverse engineering, code ...)
 
 
9.4 %
 3 votes
8.  Je souhaite en priorité moins d'hallucinations
 
 
6.2 %
 2 votes
9.  Je souhaite en priorité plus de sécurité (prompt injection, trojan, vols de credentials ...)
 
 
6.2 %
 2 votes
10.  Je souhaite en priorité moins de code spaghetti :-(
 

Total : 36 votes (4 votes blancs)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  94  95  96  97  98  99
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°55044
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 13:31:51  profilanswer
 

Reprise du message précédent :

moyen_moins a écrit :


Iq3_s
C'est pour ça que l'espoir est permis  :whistle:


Je me disais aussi, sinon les perfs seraient pas top pour une R9700  :lol:


---------------
Faudra que je teste un jour :o
n°55045
moyen_moin​s
chat réincarné
Posté le 29-10-2026 à 13:51:16  profilanswer
 

DDR4 et pcie 4.0 aussi :/
je vais peut être passer sur 128GB de RAM mais punaise, les prix :sweat:
ma R9700 a déjà pris 700 balles en 3 semaines :/

n°55047
neo world
Posté le 29-10-2026 à 13:55:24  profilanswer
 

moyen_moins a écrit :

DDR4 et pcie 4.0 aussi :/
je vais peut être passer sur 128GB de RAM mais punaise, les prix :sweat:
ma R9700 a déjà pris 700 balles en 3 semaines :/


mon bosgame qui a pris que 600 balles en 7 mois. je suis mauvais en spéculation  [:cheesecake]  :lol:

n°55048
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 14:17:33  profilanswer
 

moyen_moins a écrit :

DDR4 et pcie 4.0 aussi :/
je vais peut être passer sur 128GB de RAM mais punaise, les prix :sweat:
ma R9700 a déjà pris 700 balles en 3 semaines :/


J'aimerais bien passer en 128GB aussi, mais je résiste :o Et surtout je viens tout juste de passer a 64GB


Message édité par the_fennec le 29-10-2026 à 14:17:45

---------------
Faudra que je teste un jour :o
n°55049
speedboyz3​0
Guide Michelin :o
Posté le 29-10-2026 à 14:29:42  profilanswer
 

Et moi j'ai attendu Octobre avant d'acheter quoique ce soit, j'ai 0 gpu à la maison et 3x32go de ram mais sur 3 serveurs :(

n°55051
speedboyz3​0
Guide Michelin :o
Posté le 29-10-2026 à 14:32:38  profilanswer
 

moyen_moins a écrit :

DDR4 et pcie 4.0 aussi :/
je vais peut être passer sur 128GB de RAM mais punaise, les prix :sweat:
ma R9700 a déjà pris 700 balles en 3 semaines :/


 [:moonbloood:2]

n°55056
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 14:58:14  profilanswer
 

speedboyz30 a écrit :

Et moi j'ai attendu Octobre avant d'acheter quoique ce soit, j'ai 0 gpu à la maison et 3x32go de ram mais sur 3 serveurs :(


C'est quoi ton budget, tu veux faire quoi?


---------------
Faudra que je teste un jour :o
n°55057
speedboyz3​0
Guide Michelin :o
Posté le 29-10-2026 à 15:02:36  profilanswer
 

J'ai passé commande :o
Un mac studio 128Go :jap:

n°55058
minux
On Linux ...
Posté le 29-10-2026 à 15:05:18  profilanswer
 

Même pas le prix d'une 5090, radin va :o


---------------
Root des Google Pixel | Mes linux : 2002: Mandrake -> 2005: Ubuntu -> 2010: Arch | Mes smartphones
n°55059
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 15:09:15  profilanswer
 

speedboyz30 a écrit :

J'ai passé commande :o
Un mac studio 128Go :jap:


96GB de RAM qui vont servir a rien :o
 
 [:julm3]


Message édité par the_fennec le 29-10-2026 à 15:09:26

---------------
Faudra que je teste un jour :o
n°55060
speedboyz3​0
Guide Michelin :o
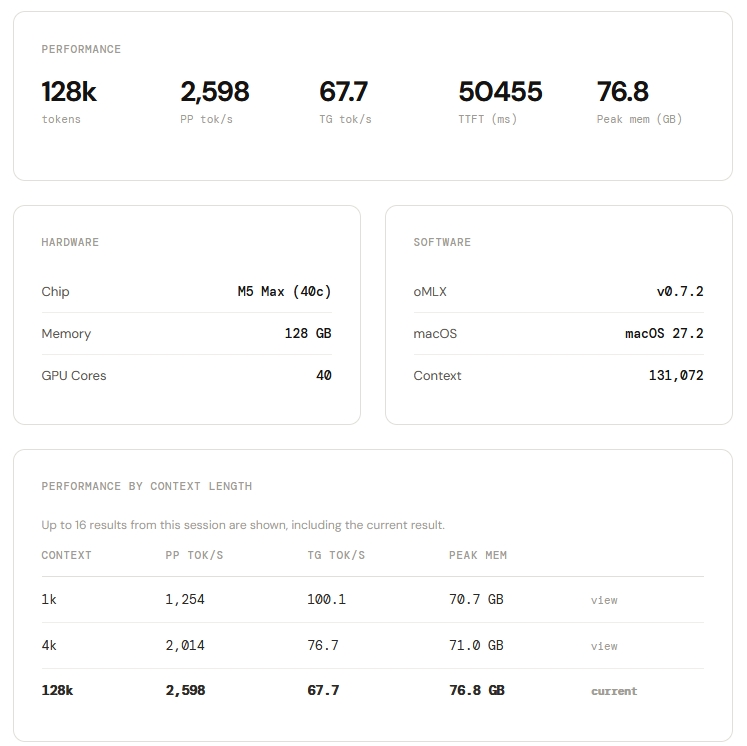
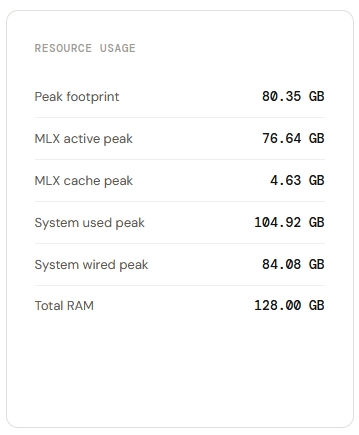
Posté le 29-10-2026 à 15:15:39  profilanswer
 

Il faut au moins 75-80Go de ram dans ce que je vois :o


https://omlx.ai/benchmarks/performance/oz0ly0at


https://rehost.diberie.com/Picture/Get/f/565839


https://rehost.diberie.com/Picture/Get/f/565840


Donc il reste de la place pour le système, quelques apps, voire un deuxième modèle :o


Message édité par speedboyz30 le 29-10-2026 à 15:17:58
n°55061
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 15:19:46  profilanswer
 

Je parlais de tes autres machines ;)


---------------
Faudra que je teste un jour :o
n°55062
speedboyz3​0
Guide Michelin :o
Posté le 29-10-2026 à 16:16:12  profilanswer
 

the_fennec a écrit :

Je parlais de tes autres machines ;)


Je vais garder le cluster proxmox avec tout ce qui tourne dessus :jap:
Le Studio c'est vraiment le node IA locale  [:speedboyz30:5]  
Encore 15j d'attente  [:jean_michel_covid:5]

n°55063
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 16:39:55  profilanswer
 

Grand saut dans l'inconnue ... j'ai upgrade Strata au dernier master, et je suis passé sur Gyro-S. Gyro-M fini par swap et tombe a 1 tg/s.
https://huggingface.co/agentionai/Q [...] -Gyro-GGUF
 
https://i.imgur.com/ayWq14W.png
 
Le prefill identique a plus de 1k/s, la génération est plus lente, autour de 40/50. Après faut voir si le modèle est plus ou moins équivalent au Q2, mais au moins il tient en entier en VRAM+RAM.
 
J'ai aussi préparé l'unlock GPU, le repo principal a ajouté le support des RTX 4xxx et 2xxx:
https://github.com/Zagitta/gpu-unlock
 
Je pense repasser sur Q2 pour comparer la vitesse.


---------------
Faudra que je teste un jour :o
n°55064
ionik
Posté le 29-10-2026 à 16:45:18  profilanswer
 

the_fennec a écrit :


J'ai aussi préparé l'unlock GPU, le repo principal a ajouté le support des RTX 4xxx et 2xxx:
https://github.com/Zagitta/gpu-unlock


Si c'était une méthode sur windows et réversible sans risque de tout planter, je testerais bien.


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°55065
xenom
Plaquettes chaussettes
Posté le 29-10-2026 à 16:47:50  profilanswer
 

Euh y a pas une histoire que justement tout ce qui est quantizé n'a aucun bénéfice d'accélération suite à ces méthodes?

n°55066
moyen_moin​s
chat réincarné
Posté le 29-10-2026 à 16:56:22  profilanswer
 

the_fennec a écrit :

Grand saut dans l'inconnue ... j'ai upgrade Strata au dernier master, et je suis passé sur Gyro-S. Gyro-M fini par swap et tombe a 1 tg/s.
https://huggingface.co/agentionai/Q [...] -Gyro-GGUF
 
https://i.imgur.com/ayWq14W.png
 
Le prefill identique a plus de 1k/s, la génération est plus lente, autour de 40/50. Après faut voir si le modèle est plus ou moins équivalent au Q2, mais au moins il tient en entier en VRAM+RAM.
 
J'ai aussi préparé l'unlock GPU, le repo principal a ajouté le support des RTX 4xxx et 2xxx:
https://github.com/Zagitta/gpu-unlock
 
Je pense repasser sur Q2 pour comparer la vitesse.


c'est beau l'aventure :jap:  

n°55067
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 17:03:30  profilanswer
 

ionik a écrit :

Si c'était une méthode sur windows et réversible sans risque de tout planter, je testerais bien.


Sous Windows c'est ici:
https://github.com/impacifist/Windows-GPU-UNLOCK
 
Mais je sais pas si c'est safe :o


xenom a écrit :

Euh y a pas une histoire que justement tout ce qui est quantizé n'a aucun bénéfice d'accélération suite à ces méthodes?


Certaines parties des modèles quantizé restent en FP16, donc il peut y avoir un gain, mais c'est pas du 2x:

Citation :

llama.cpp / Ollama with quantized GGUF  0–15%, mostly at long context


Pas mal de rapports:
https://github.com/Zagitta/gpu-unlo [...] ess-report
 
J'ai vu passer des +16% en prefill sur Strata. Ça coûte rien, faut pas se priver :D


---------------
Faudra que je teste un jour :o
n°55068
moyen_moin​s
chat réincarné
Posté le 29-10-2026 à 17:04:04  profilanswer
 

xenom a écrit :

Euh y a pas une histoire que justement tout ce qui est quantizé n'a aucun bénéfice d'accélération suite à ces méthodes?


l'unlock a de l'intérêt que pour le prefill normalement. [:transparency]

n°55069
xenom
Plaquettes chaussettes
Posté le 29-10-2026 à 17:05:16  profilanswer
 

Ok oui j'avoue ça se prend  :jap:

n°55071
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 17:51:50  profilanswer
 

Bon l'unlock a marché :D
 

Citation :

Oct 29 17:26:11 magi kernel: pci 0000:13:00.0: gpu_unlock: stage=host ss0=0x88888888 ss1=0x8 plm_feat=0xffffffff plm_wpr_cfg=0xfffff0ff
Oct 29 17:26:11 magi kernel: pci 0000:13:00.0: gpu_unlock: stage=flr post_wpr2=0x1ffffe00:0x0 ss0=0x88888888 ss1=0x8 plm=0xffffffff cmd=0x3 devsta=0x0 chip=0x196000a1
Oct 29 17:26:11 magi kernel: pci 0000:13:00.0: gpu_unlock: stage=handoff ret=0 state=4 retained=0 pages=0/20606 cleanup=0
Oct 29 17:26:11 magi kernel: pci 0000:13:00.0: gpu_unlock: unlocked
 
root@magi:~# lspci -nnk -s 0000:13:00.0
13:00.0 VGA compatible controller [0300]: NVIDIA Corporation AD106 [GeForce RTX 4060 Ti 16GB] [10de:2805] (rev a1)
        DeviceName: pciPassthru0
        Subsystem: PNY Device [196e:13eb]
        Kernel driver in use: nvidia
        Kernel modules: nouveau, nvidia_drm, nvidia


J'ai eu la flemme de changer de quant, donc je suis resté sur Gyro-S:

  • prefill avant: 1217/s pour 55k
  • prefill après: 1402/s pour 57k


Donc un gain de 15% :love:


---------------
Faudra que je teste un jour :o
n°55072
neo world
Posté le 29-10-2026 à 17:59:44  profilanswer
 

[:johnclaude:7]  
augmentation de conso associé au gain de perf ou en plus tu feras des économies d’énergie à nombre de tokens égale ? :D

n°55080
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 20:33:02  profilanswer
 

neo world a écrit :

[:johnclaude:7]  
augmentation de conso associé au gain de perf ou en plus tu feras des économies d’énergie à nombre de tokens égale ? :D


Difficile a dire :/


---------------
Faudra que je teste un jour :o
n°55081
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 20:34:55  profilanswer
 

Mistral released Mistral Large 4 (Le Chonk), a 1-trillion-parameter multimodal model
https://mistral.ai/news/mistral-large-4-oss/
 
https://huggingface.co/mistralai/Mi [...] -4-1T-A52B
 
1T A52B ...  
 
https://huggingface.co/unsloth/Mist [...] -A52B-GGUF
 

Citation :

Run the smallest 1-bit (233 GB) on a 256GB RAM device, 2-bit (302-378 GB) on 384-512GB, or near full precision (Q8, 1.1 TB) on 1.2TB+


---------------
Faudra que je teste un jour :o
n°55082
neo world
Posté le 29-10-2026 à 20:36:07  profilanswer
 

C'est un tirage de numéros aléatoires la tuile en haut à droite dans le dashboard de strata ? :o

n°55084
the_fennec
f3nn3cUs z3rd4
Posté le 29-10-2026 à 20:50:12  profilanswer
 

neo world a écrit :

C'est un tirage de numéros aléatoires la tuile en haut à droite dans le dashboard de strata ? :o


Un peu, ça oscille beaucoup entre 30W et 120W, j'aurais du mal à dire si ça a changé. Sachant que ça saute de génération à prefill, et qu'il y a plus de temps de gen que prefill.


---------------
Faudra que je teste un jour :o
n°55087
crazytiti
http://crazytiti.free.fr/
Posté le 29-10-2026 à 21:19:29  profilanswer
 

+1 mon strata a la même fonctionnalité :jap:


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°55096
moyen_moin​s
chat réincarné
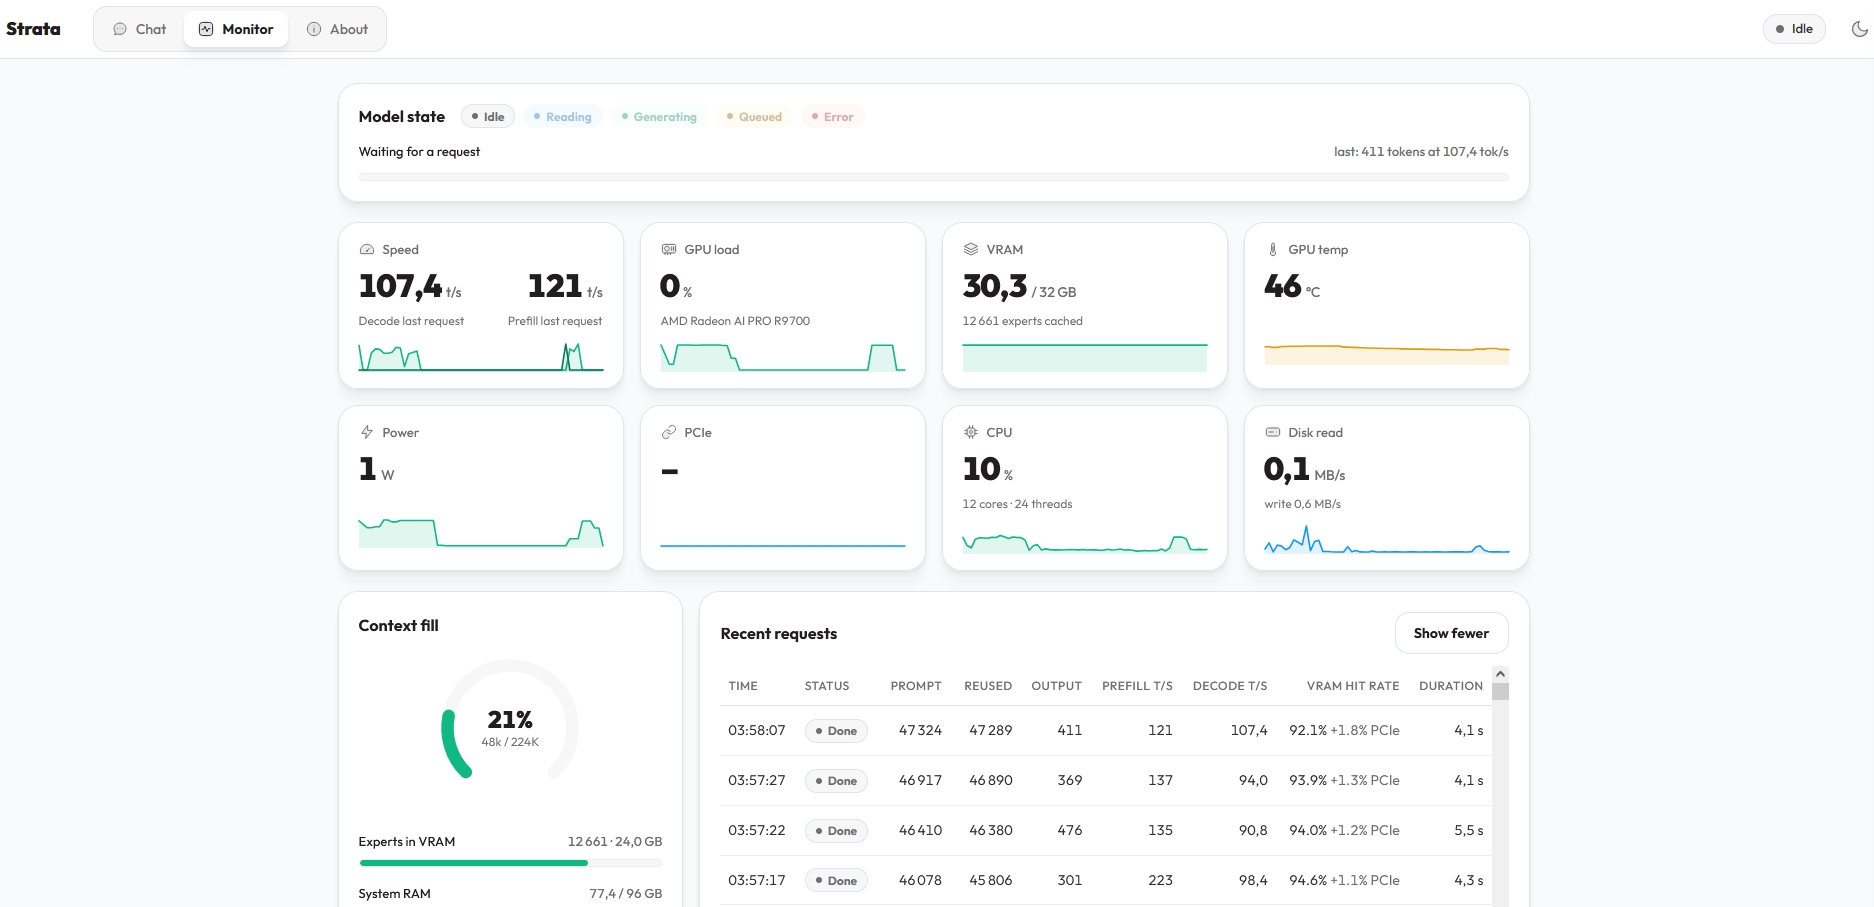
Posté le 30-10-2026 à 04:03:18  profilanswer
 

https://rehost.diberie.com/Picture/Get/f/565944

Citation :

Since mer. 21:12: 654 requests · 1 356 237 prompt tokens read at 756 tok/s (71 428 841 reused) · 583 269 written at 87,4 tok/s


que le pcie qui indique rien sous windows.
faut que j'essaie plus de contexte, marre des compactions tous les 200k vu la marge qu'il prend...
et passage à 128GB d'ici 10j :o

Message cité 1 fois
Message édité par moyen_moins le 30-10-2026 à 04:07:44
n°55143
shiryu
Posté le 30-10-2026 à 22:19:15  profilanswer
 

:hello:  
 
Dans la famille on utilise l´IA pour générer du PDF (comparatif d´offre), suivi de santé...  
On l´utilise aussi pour créer des petites applications (quiz pour la voiture, visite de ville,...)
 
Pour cela, on utilise Claude et Mistral.  
 
Depuis quelques semaine je lancé dans l´IA local en utilisant ma 5090 et mes 64Gb DDR5. Le résultat est plutot bon en utlisant Qwen avec Bionic.  
 
Pour pouvoir partager sur du multi device et pour la famille, je suis passé sur Ollama et Openwebui hébérgé sur mon NAS. Aucun problème de connection, le fonctionement est bon. Par contre, le problème est l´appel de fonction.
 
Impossible de générer des excels ou de générer des images (meme simple). Est ce que quelq´un ici utilise une IA local comme je souhait  l´utiliser ?


---------------
https://www.prusaprinters.org/socia [...] ain/prints
n°55175
moyen_moin​s
chat réincarné
Posté le 31-10-2026 à 10:33:50  profilanswer
 

truc con mais demande à l'ia :D

n°55177
the_fennec
f3nn3cUs z3rd4
Posté le 31-10-2026 à 10:38:11  profilanswer
 

shiryu a écrit :

:hello:  
 
Dans la famille on utilise l´IA pour générer du PDF (comparatif d´offre), suivi de santé...  
On l´utilise aussi pour créer des petites applications (quiz pour la voiture, visite de ville,...)
 
Pour cela, on utilise Claude et Mistral.  
 
Depuis quelques semaine je lancé dans l´IA local en utilisant ma 5090 et mes 64Gb DDR5. Le résultat est plutot bon en utlisant Qwen avec Bionic.  
 
Pour pouvoir partager sur du multi device et pour la famille, je suis passé sur Ollama et Openwebui hébérgé sur mon NAS. Aucun problème de connection, le fonctionement est bon. Par contre, le problème est l´appel de fonction.
 
Impossible de générer des excels ou de générer des images (meme simple). Est ce que quelq´un ici utilise une IA local comme je souhait  l´utiliser ?


C'est quoi ton NAS? Comment sont installés Ollama et Openwebui?  
Ollama tourne sur le NAS? Quel GPU il utilise?


---------------
Faudra que je teste un jour :o
n°55182
neo world
Posté le 31-10-2026 à 10:48:56  profilanswer
 

shiryu a écrit :

:hello:  
 
Dans la famille on utilise l´IA pour générer du PDF (comparatif d´offre), suivi de santé...  
On l´utilise aussi pour créer des petites applications (quiz pour la voiture, visite de ville,...)
 
Pour cela, on utilise Claude et Mistral.  
 
Depuis quelques semaine je lancé dans l´IA local en utilisant ma 5090 et mes 64Gb DDR5. Le résultat est plutot bon en utlisant Qwen avec Bionic.  
 
Pour pouvoir partager sur du multi device et pour la famille, je suis passé sur Ollama et Openwebui hébérgé sur mon NAS. Aucun problème de connection, le fonctionement est bon. Par contre, le problème est l´appel de fonction.
 
Impossible de générer des excels ou de générer des images (meme simple). Est ce que quelq´un ici utilise une IA local comme je souhait  l´utiliser ?


en fait le skill "création / modification / lecture" de fichiers excels doit résider là où l'appel est fait :
tu peux trouver un harness avec ces capacités (claude code il me semble mais faut chercher sérieusement) et le connecter à ton endpoint API ollama / Openwebui (je te conseillerai strata avec Qwen 3.8 flash next en passant mais bref c'est un autre sujet) : ton utilisateur envoie la requete via le harness (installé sur son ordi avec ses credentials par exemple) et c'est lui qui fera le pont entre ton modèle hebergé sur ta 5090 à travers l'API et les skills excel avec l'accès aux fichiers du NAS :jap:


Message édité par neo world le 31-10-2026 à 10:50:00
n°55236
extenue1
Posté le 31-10-2026 à 17:27:09  profilanswer
 

Budget 3000 boules : c'est quoi le meilleur matos pour faire de l'IA locale au jour d'aujourd'hui ?

n°55238
neo world
Posté le 31-10-2026 à 17:54:09  profilanswer
 

Bosgame M5 ai ( AMD strix halo)

n°55241
the_fennec
f3nn3cUs z3rd4
Posté le 31-10-2026 à 18:26:40  profilanswer
 

https://github.com/freriadoc/Avalon
 
src: Avalon Just Beat Strata by 47% on AMD (9x Faster)
https://www.youtube.com/watch?v=0F63pTS8Gt0
 
Un fork de llama.cpp qui annonce être plus rapide que Strata sur QFN!

Message cité 2 fois
Message édité par the_fennec le 31-10-2026 à 18:28:20

---------------
Faudra que je teste un jour :o
n°55247
epsiloncen​taury
Posté le 31-10-2026 à 19:47:42  profilanswer
 

moyen_moins a écrit :

https://rehost.diberie.com/Picture/Get/f/565944

Citation :

Since mer. 21:12: 654 requests · 1 356 237 prompt tokens read at 756 tok/s (71 428 841 reused) · 583 269 written at 87,4 tok/s


que le pcie qui indique rien sous windows.
faut que j'essaie plus de contexte, marre des compactions tous les 200k vu la marge qu'il prend...
et passage à 128GB d'ici 10j :o


J'arrive à faire tourner IQ3-XXS sur ma trottinette. Ma ram DDR4 2400 56go, fait de bric et de broc (3modeles differents) est à raz la gueule  [:rofl]


https://img.super-h.fr/images/2026/10/31/1d7b0fcd2933723aaedd29e9b1b59bd5.png


Message cité 1 fois
Message édité par epsiloncentaury le 31-10-2026 à 19:51:40
n°55250
moyen_moin​s
chat réincarné
Posté le 31-10-2026 à 20:21:06  profilanswer
 

[:xp1700]
 
bon, par contre, mon clone de Nitro ça avance pas fort, soit c'est moi qui suis une pipe (probable :o), soit le qwen FN montre ses limites.
c'est bof, ça ressemble de loin à l'original et c'est toujours aussi sec niveau design UI
 

Citation :


Since mer. 21:12: 2 429 requests · 6 168 444 prompt tokens read at 784 tok/s (266 012 158 reused) · 2 263 221 written at 86,4 tok/s

n°55252
chris282
id steam/psn : chris282_fr
Posté le 31-10-2026 à 20:35:05  profilanswer
 

the_fennec a écrit :

https://github.com/freriadoc/Avalon
 
src: Avalon Just Beat Strata by 47% on AMD (9x Faster)
https://www.youtube.com/watch?v=0F63pTS8Gt0
 
Un fork de llama.cpp qui annonce être plus rapide que Strata sur QFN!


trouvaille intéressante
je suis très content qu'il y ait des découvertes et des forks, mais pas content que les développements s'éparpillent entre X projets.

n°55253
epsiloncen​taury
Posté le 31-10-2026 à 20:35:26  profilanswer
 

J'ai toujours été attiré par les Jarvis que faisaient tourner certains YouTubeurs, et j'ai toujours eu envie d'avoir le mien.


C'est chose faite. J'ai réussi à faire un "Jarvis" maison entièrement local. On trouve pas mal de vidéos qui montrent ça, mais beaucoup "trichent" en utilisant des API cloud pour les voix. Bien sûr, d'autres font ça entièrement en local, mais pas avec une trottinette comme la mienne.


Après quelques jours passés à configurer ma machine l'aide de Claude, voilà le résultat.


Pour l'anecdote. Je n'ai même pas d'abonnement Claude. J'ai tout fait en utilisant la version gratuite, qui coupe souvent et me limite à deux questions max par jour quand la requête demande un peu trop.


Je rappelle que j'ai un Ryzen 7 5700G + 56 Go de DDR4 + 2 GTX 1080, donc sans Tensor Core (Pascal oblige).


KoboldCpp + XTTS + Wihsper pour le micro


J'ai testé plusieurs modèles au fil de mes essais :


Qwen 3.8B VL Instruct


Qwen 2.5 7B


Qwen 3.5 2B


Llama 3.2 7B


Mais pour l'instant, le Gemma4 12B QAT est celui qui offre les meilleures performances sur ma configuration.


https://img.super-h.fr/images/2026/10/31/2696ff84851f083c9a85f9e6e73c72f2.png


https://www.youtube.com/watch?v=HI6xdwxqhi4


Message édité par epsiloncentaury le 31-10-2026 à 20:47:08
n°55268
moyen_moin​s
chat réincarné
Posté le 31-10-2026 à 22:24:29  profilanswer
 

whisper, c'est le speech to text ? à l'époque sur home assistant, ce qui marchait le mieux pour le français, c'était Vosk [:paysan]

n°55271
epsiloncen​taury
Posté le 31-10-2026 à 23:43:39  profilanswer
 

moyen_moins a écrit :

whisper, c'est le speech to text ? à l'époque sur home assistant, ce qui marchait le mieux pour le français, c'était Vosk [:paysan]


Vosk est très leger et fait le job sur les commandes simples, mais sur de longues phrases, Whisper et bien meilleurs tout en étant plus lourd. 1.5go en Vram en medium si je me rappelle bien.


Vosk travaille à l'ancienne sur les phonèmes, alors que Whisper travaille sur des Transformers. Vosk est très leger dans 60mo et tient très bien dans un raspberrypi. Mais il est largué sur de longues phrases. Il lui manque surtout ce qui faite la voix humain, ponctuation, majuscule....


Message édité par epsiloncentaury le 31-10-2026 à 23:44:25
 Page :   1  2  3  4  5  ..  94  95  96  97  98  99

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)