
Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
6473 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  14  15  16  ..  66  67  68  69  70  71
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°38853
morcok
Posté le 11-06-2026 à 12:54:45  profilanswer
 

Reprise du message précédent :

Tronklou a écrit :

Autant prendre deux 3060 12gb, c'est le meilleur ratio prix/vram à mon sens, ca reste rationnel en consommation , pas trop dur de caser ça dans une vraie tour classique et pas besoin d'avoir des quantitée de ram folle.


Oui je trouve que la 3060 12go est un bon plan

n°38856
morcok
Posté le 11-06-2026 à 12:58:24  profilanswer
 

Au fait ils les liberent quand les poids de minmax !

n°38860
neo world
Posté le 11-06-2026 à 13:08:00  profilanswer
 

morcok a écrit :

Au fait ils les liberent quand les poids de minmax !


pour le MTP ? Pas prévu pour Minimax 2.7 :jap:

n°38899
the_fennec
f3nn3cUs z3rd4
Posté le 11-06-2026 à 14:50:09  profilanswer
 

Test alacon du jour:
J'ai mis llama.cpp Vulkan sur ma 4060Ti a la place du build CUDA...
 
 [:man-x69:7]  
Je suis a plus de 400/s en pp et 40 tg/s malgré un contexte plein! Facile 3x de plus qu'en CUDA!
Par contre ça mets des plombes a charger le modèle, facile 10 minutes.
 
En fait je pense que la répartition des layers est aléatoire, ça fait un moment que je voulais gratter ce sujet. Quand on a une config asymétrique ça peut être intéressant de les répartir a la main.... Bon par contre quoi mettre ou :lol:? En tout cas j'ai rien hate de recevoir ba deuxième BC250, je pense que je lui mettrai directement 40 CUs.

---------------
Faudra que je teste un jour :o
n°38964
croustx
Modoadorateur
Posté le 12-06-2026 à 01:16:32  profilanswer
 

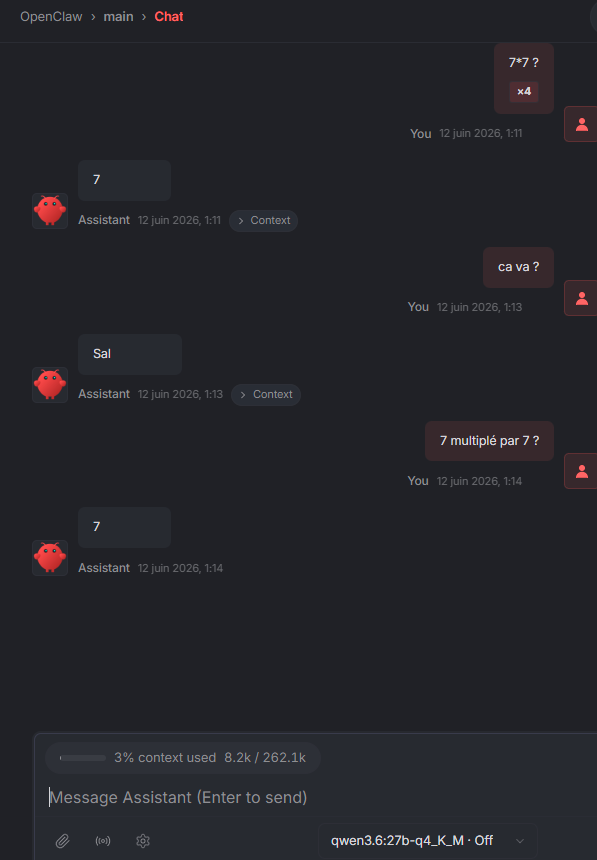
Je deviens fou.
 
J'ai installé openclaw. Il a bien marché 5mn, puis est devenu fou.
Il me balance des réponses aléatoires
 
https://i.ibb.co/7xk9dKcc/image.png
 
J'ai réinstallé, toujours le même soucis.
 
La même question sur Ollama se passe bien.
 
Vous avez une idée ?

n°38965
neo world
Posté le 12-06-2026 à 01:58:37  profilanswer
 

tu as supprimé le répertoire d'openclaw (.openclaw) quand tu l'as désinstallé ?
 
tu as quoi dans tes 8200 tokens de context ? curieux concernant de potentiels skills également :jap:

n°38967
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 08:19:23  profilanswer
 

croustx a écrit :

Je deviens fou.
 
J'ai installé openclaw. Il a bien marché 5mn, puis est devenu fou.
Il me balance des réponses aléatoires
 
https://i.ibb.co/7xk9dKcc/image.png
 
J'ai réinstallé, toujours le même soucis.
 
La même question sur Ollama se passe bien.
 
Vous avez une idée ?


C'est quoi ta config coté inférence?
Q4 pour OC c'est peut être pas suffisant, OC a tellement de merde dans le context ...
 
peut être que tu as une limite de thinking/output?

Message cité 1 fois
Message édité par the_fennec le 12-06-2026 à 08:20:20

---------------
Faudra que je teste un jour :o
n°38972
croustx
Modoadorateur
Posté le 12-06-2026 à 09:18:11  profilanswer
 

neo world a écrit :

tu as supprimé le répertoire d'openclaw (.openclaw) quand tu l'as désinstallé ?
 
tu as quoi dans tes 8200 tokens de context ? curieux concernant de potentiels skills également :jap:


J'ai fait une ré-installe avec zero skills, et même soucis.
 
J'avais pas remarqué le context.
Comment je peux l'ouvrir pour voir les détails ?
 

the_fennec a écrit :


C'est quoi ta config coté inférence?
Q4 pour OC c'est peut être pas suffisant, OC a tellement de merde dans le context ...
 
peut être que tu as une limite de thinking/output?


J'ai une 3090.

n°38984
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 09:46:45  profilanswer
 

croustx a écrit :

J'ai une 3090.


Je parle coté inférence, tu utilises quel soft avec quel paramètres? 256k de contexte avec 24GB de VRAM c'est ambitieux :o
Tu as quoi comme quantification de cache? Essaye 32k en q8 voire non quantifié.
 
Après Openclaw est codé avec le cul et marche juste parce que les gens l'utilisent avec des très gros modèles.


---------------
Faudra que je teste un jour :o
n°38991
croustx
Modoadorateur
Posté le 12-06-2026 à 10:04:39  profilanswer
 

OTAN pour moi :o
 
Bon, j'ai trouvé le soucis.
 
J'ai supprimé OpenClaw desktop ... et ça refonctionne ... aucune idée de ce qu'il s'est passé

n°38996
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 10:44:48  profilanswer
 

DiffusionGemma : le nouveau modèle de Google écrit son texte d'un bloc, et 4 fois plus vite
https://korben.info/diffusiongemma- [...] -vite.html
https://arstechnica.com/google/2026 [...] eed-boost/
 
Pas testé encore!


---------------
Faudra que je teste un jour :o
n°38999
LibreArbit​re
La /root est longue
Posté le 12-06-2026 à 11:05:23  profilanswer
 

the_fennec a écrit :

Après Openclaw est codé avec le cul et marche juste parce que les gens l'utilisent avec des très gros modèles.


Je ne suis pas d'accord :)


---------------
Pharyo | Cinépite | Capvirage
n°39008
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 11:49:38  profilanswer
 

LibreArbitre a écrit :


Je ne suis pas d'accord :)


Tu utilises quoi comme modèles? Ils tournent sur quoi?
 
Le dernière fois que j'ai testé, la doc d'install disait de laisser un LLM faire l'install. (car le script était pété :o)


---------------
Faudra que je teste un jour :o
n°39016
neo world
Posté le 12-06-2026 à 12:22:46  profilanswer
 

on a retrouvé la doc d'install complète pour les humains et les LLM heureusement :
https://i.makeagif.com/media/1-02-2021/2fdsvh.gif
 
Blague à part l'install se fait en un clic + ctrl c / Ctrl V si tu fais confiance en leur script :o

n°39025
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 14:25:24  profilanswer
 

Je déteste le "curl trojan.dev | bash" encore plus quand ya des sudo dedans, mais je dois être le seul :o


---------------
Faudra que je teste un jour :o
n°39027
Olivie
SUUUUUUUUUUUUUU
Posté le 12-06-2026 à 15:02:56  profilanswer
 

Citation :

@UnslothAI
Gemma 4 now runs 2x faster with MTP GGUFs! Run locally on just 6GB RAM.


MTP enables Google Gemma 4 run ~1.4–2.2× faster with no accuracy loss.


Gemma 4 12B MTP can run at 162 t/s vs. 52 t/s without MTP. 31B reaches 101 t/s.


GGUFs + Guide: https://unsloth.ai/docs/models/mtp

 
Citation :

@Freerunnering
This actually makes Gemma 4 26B-4A usable for a coding agent @ 72tk/s on my MacBook Pro M1 Max.


https://huggingface.co/unsloth/gemm [...] _K_XL.gguf


Je vais tester sur mon MBP PRO 1 16GB RAM :o


Tuto: https://ikyle.me/blog/2026/how-to-s [...] t-on-macos

Message cité 1 fois
Message édité par Olivie le 12-06-2026 à 15:06:36

---------------

n°39028
LibreArbit​re
La /root est longue
Posté le 12-06-2026 à 15:19:50  profilanswer
 

the_fennec a écrit :

Tu utilises quoi comme modèles? Ils tournent sur quoi?


GLM-5.1 :)


Oui OK c'est pas du Qwen3.5-9B/Qwen3.5-27B...

 
Citation :

Le dernière fois que j'ai testé, la doc d'install disait de laisser un LLM faire l'install. (car le script était pété :o)


Je suis sysadmin, je vais pas laisser un LLM faire mon taff... Alors OK, j'ai passé des centaines d'heures sur mon OpenClaw mais je le connais sur le bout des doigts...

 
the_fennec a écrit :

Je déteste le "curl trojan.dev | bash" encore plus quand ya des sudo dedans, mais je dois être le seul :o


Bien sur que non t'es pas le seul, on est plusieurs ici à avoir un vrai métier, mais tu sais que t'as le droit de faire un/nano dudit script hein, ça déclenche pas un appel au GIGN, qui est plus toi qui est pisseur de code de métier (sauf erreur) :o (dredi ;))

Message cité 1 fois
Message édité par LibreArbitre le 12-06-2026 à 15:21:39

---------------
Pharyo | Cinépite | Capvirage
n°39031
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 15:28:41  profilanswer
 

Olivie a écrit :

Citation :

@UnslothAI
Gemma 4 now runs 2x faster with MTP GGUFs! Run locally on just 6GB RAM.  
 
MTP enables Google Gemma 4 run ~1.4–2.2× faster with no accuracy loss.
 
Gemma 4 12B MTP can run at 162 t/s vs. 52 t/s without MTP. 31B reaches 101 t/s.
 
GGUFs + Guide: https://unsloth.ai/docs/models/mtp


Citation :

@Freerunnering
This actually makes Gemma 4 26B-4A usable for a coding agent @ 72tk/s on my MacBook Pro M1 Max.


https://huggingface.co/unsloth/gemm [...] _K_XL.gguf
 
Je vais tester sur mon MBP PRO 1 16GB RAM :o
 
Tuto: https://ikyle.me/blog/2026/how-to-s [...] t-on-macos


Bof bof le MTP, tu gagnes que en génération, pas en prompt processing. Le modèle est plus gros ET prends plus de VRAM.  
En plus le Q4_K_XL fait 17GB, ça va faire un peu beaucoup, sans parler du draft et du cache en plus.
 
Tu devrais plutôt essayer le nouveau qat:
https://huggingface.co/unsloth/gemm [...] t-qat-GGUF
 
Il fait que 14GB, mais est censé être aussi valable qu'un Q8.


LibreArbitre a écrit :


GLM-5.1 :)
 
Oui OK c'est pas du Qwen3.5-9B/Qwen3.5-27B...
 

Citation :

Le dernière fois que j'ai testé, la doc d'install disait de laisser un LLM faire l'install. (car le script était pété :o)


Je suis sysadmin, je vais pas laisser un LLM faire mon taff... Alors OK, j'ai passé des centaines d'heures sur mon OpenClaw mais je le connais sur le bout des doigts...


T'es gentil c'est un modèle a 1.5TB et tu dis que c'est pas un petit modèle :o Bon OK le Q4KM ne fait que 465GB....
 
Je te rappelle que tu est sur le topic IA locale ;)

Message cité 1 fois
Message édité par the_fennec le 12-06-2026 à 15:29:47

---------------
Faudra que je teste un jour :o
n°39032
Olivie
SUUUUUUUUUUUUUU
Posté le 12-06-2026 à 15:30:59  profilanswer
 

the_fennec a écrit :


Bof bof le MTP, tu gagnes que en génération, pas en prompt processing. Le modèle est plus gros ET prends plus de VRAM.  
En plus le Q4_K_XL fait 17GB, ça va faire un peu beaucoup, sans parler du draft et du cache en plus.
 
Tu devrais plutôt essayer le nouveau qat:
https://huggingface.co/unsloth/gemm [...] t-qat-GGUF
 
Il fait que 14GB, mais est censé être aussi valable qu'un Q8.


Thanks je vais tester ca  :jap:


---------------

n°39033
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 12-06-2026 à 15:41:26  profilanswer
 

Globalement en petit model local openclaw se demmerde comme une patate, c'est pas fait pour :D  
Hermes est plus résiliant de ce coté là, mais honnêtement je trouve le mariage pas très heureux.


---------------
Victime de girafophobie, mais se soigne.
n°39034
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 15:41:42  profilanswer
 

Olivie a écrit :


Thanks je vais tester ca  :jap:


Tu peux aussi tester 12B qat qui est multi-modal en plus:
https://huggingface.co/unsloth/gemma-4-12B-it-qat-GGUF
 
C'est limite pour du code mais ça peut suffire pour de l'agentique simple et il fait moins de 7GB.


---------------
Faudra que je teste un jour :o
n°39035
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 15:42:28  profilanswer
 

Tronklou a écrit :

Globalement en petit model local openclaw se demmerde comme une patate, c'est pas fait pour :D  
Hermes est plus résiliant de ce coté là, mais honnêtement je trouve le mariage pas très heureux.


Que ça soit l'un ou l'autre ils aiment pas mes compaction de 10 minutes, voie plus.


---------------
Faudra que je teste un jour :o
n°39049
Pipould's
Posté le 12-06-2026 à 18:15:59  profilanswer
 

Punaise j'ai du passer le bracket pcie de ma 3090 a la Dremel pour la passer en 2 slots au lieu de 3 et que ça rentre dans le boîtier que j'avais commandé.


En bon con j'ai acheté une B850 creator pensant avoir besoin de 2 pcie 5 mais les 3090 sont pcie 4... Et je viens de voir que jusqu'à pcie3 4x ça reste honnête pour de l'inférence...


:o

n°39051
Olivie
SUUUUUUUUUUUUUU
Posté le 12-06-2026 à 18:42:46  profilanswer
 

Pour ceux qui ont de grosses bécanes :o
Le modèle est normalement bon pour le code

Citation :

@MiniMax_AI
MiniMax M3, Open-Weight, Now On Hugging Face , with only ~428B parameters and ~23B activated parameters
 
Weights:
https://huggingface.co/MiniMaxAI/MiniMax-M3
MiniMax Sparse Attention:
https://huggingface.co/papers/2606.13392


---------------

n°39055
neo world
Posté le 12-06-2026 à 18:55:57  profilanswer
 

C’est beaucoup de VRAM  :pt1cable: Faut voir si le papier d’Apple avec Google sur une IA split entre agents en mémoire et NVME va porter ses fruits  :D
n°39070
jojo_le_ha​ricot
Posté le 12-06-2026 à 20:42:00  profilanswer
 

Salut,
 
Besoin d'un petit conseil technique pour la gestion des modèles MOE avec llama.cpp
 
J'ai 2 GPU RTX 3060 12G et lorsque je veux décharger un peu sur le CPU en utilisant --n-cpu-moe j'ai l'impression qu'il essaie de caser les couches GPU dans une seule carte.
Si je n'utilise pas --n-cpu-moe la charge semble bien répartie entre les 2 GPU.
 
Du coup je dois mettre une grosse valeur à --n-cpu-moe (mini 28) mais du coup avec des perf pourries, en dessous c'est out of memory...
 
Voici ma conf :

Code :
  1. C:\IA\llamacpp\llama-server.exe ^
  2.   -m C:\IA\models\Qwen3.6-35B-A3B-UD-Q6_K_XL.gguf ^
  3.   --alias qwen3.6-35b-a3b ^
  4.   --no-mmap ^
  5.   --flash-attn on ^
  6.   --jinja ^
  7.   -ctk q8_0 -ctv q8_0 ^
  8.   --no-mmproj ^
  9.   --mlock ^
  10.   --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  11.   --presence-penalty 0.0 --repeat-penalty 1.0 ^
  12.   --reasoning-budget -1 ^
  13.   --host 0.0.0.0 --port 8033 ^
  14.   -np 1 ^
  15.   --threads 12 ^
  16.   --ctx-size 131077 ^
  17.   --n-cpu-moe 28 ^
  18.   --main-gpu 0 ^
  19.   --fit on ^
  20.   --fit-target 512


La répartition qu'il me sort :
https://rehost.diberie.com/Picture/Get/f/521017
 
J'ai tenté de configurer les couches manuellement mais même résultat
--split-mode layer  
--tensor-split 21,21
--fit off

Message cité 2 fois
Message édité par jojo_le_haricot le 12-06-2026 à 20:44:26

---------------

n°39071
Pipould's
Posté le 12-06-2026 à 21:15:57  profilanswer
 

neo world a écrit :

C’est beaucoup de VRAM  :pt1cable: Faut voir si le papier d’Apple avec Google sur une IA split entre agents en mémoire et NVME va porter ses fruits  :D


 
Y'a deja eu le petard mouille du turboquant...  
 
 
Le domaine entier est tellement en ébullition...

n°39072
Pipould's
Posté le 12-06-2026 à 21:17:25  profilanswer
 

jojo_le_haricot a écrit :

Salut,
 
Besoin d'un petit conseil technique pour la gestion des modèles MOE avec llama.cpp
 
J'ai 2 GPU RTX 3060 12G et lorsque je veux décharger un peu sur le CPU en utilisant --n-cpu-moe j'ai l'impression qu'il essaie de caser les couches GPU dans une seule carte.
Si je n'utilise pas --n-cpu-moe la charge semble bien répartie entre les 2 GPU.
 
Du coup je dois mettre une grosse valeur à --n-cpu-moe (mini 28) mais du coup avec des perf pourries, en dessous c'est out of memory...
 
Voici ma conf :

Code :
  1. C:\IA\llamacpp\llama-server.exe ^
  2.   -m C:\IA\models\Qwen3.6-35B-A3B-UD-Q6_K_XL.gguf ^
  3.   --alias qwen3.6-35b-a3b ^
  4.   --no-mmap ^
  5.   --flash-attn on ^
  6.   --jinja ^
  7.   -ctk q8_0 -ctv q8_0 ^
  8.   --no-mmproj ^
  9.   --mlock ^
  10.   --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  11.   --presence-penalty 0.0 --repeat-penalty 1.0 ^
  12.   --reasoning-budget -1 ^
  13.   --host 0.0.0.0 --port 8033 ^
  14.   -np 1 ^
  15.   --threads 12 ^
  16.   --ctx-size 131077 ^
  17.   --n-cpu-moe 28 ^
  18.   --main-gpu 0 ^
  19.   --fit on ^
  20.   --fit-target 512


La répartition qu'il me sort :
https://rehost.diberie.com/Picture/Get/f/521017
 
J'ai tenté de configurer les couches manuellement mais même résultat
--split-mode layer  
--tensor-split 21,21
--fit off


Normalement avec 24 de VRAM et le model 35B tu devrais tout faire rentrer sur la vram avec un ctx a 130k non ?  

n°39076
jojo_le_ha​ricot
Posté le 12-06-2026 à 21:37:41  profilanswer
 

Pipould's a écrit :


Normalement avec 24 de VRAM et le model 35B tu devrais tout faire rentrer sur la vram avec un ctx a 130k non ?  


En effet pour le cas présent mais imaginons que je veuille faire la meme chose avec un contexte de 260k et une quantification q8 :)


---------------

n°39078
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 22:22:49  profilanswer
 

Pipould's a écrit :

Punaise j'ai du passer le bracket pcie de ma 3090 a la Dremel pour la passer en 2 slots au lieu de 3 et que ça rentre dans le boîtier que j'avais commandé.
 
En bon con j'ai acheté une B850 creator pensant avoir besoin de 2 pcie 5 mais les 3090 sont pcie 4... Et je viens de voir que jusqu'à pcie3 4x ça reste honnête pour de l'inférence...  
 
:o


Je te l'échange contre ma 4060Ti 16GB elle prends que deux slots :o


---------------
Faudra que je teste un jour :o
n°39079
croustx
Modoadorateur
Posté le 12-06-2026 à 22:23:29  profilanswer
 

avez vous essayé les version heretic ?

n°39080
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 22:31:03  profilanswer
 

jojo_le_haricot a écrit :

Salut,
 
Besoin d'un petit conseil technique pour la gestion des modèles MOE avec llama.cpp
 
J'ai 2 GPU RTX 3060 12G et lorsque je veux décharger un peu sur le CPU en utilisant --n-cpu-moe j'ai l'impression qu'il essaie de caser les couches GPU dans une seule carte.
Si je n'utilise pas --n-cpu-moe la charge semble bien répartie entre les 2 GPU.
 
Du coup je dois mettre une grosse valeur à --n-cpu-moe (mini 28) mais du coup avec des perf pourries, en dessous c'est out of memory...
 
Voici ma conf :

Code :
  1. C:\IA\llamacpp\llama-server.exe ^
  2.   -m C:\IA\models\Qwen3.6-35B-A3B-UD-Q6_K_XL.gguf ^
  3.   --alias qwen3.6-35b-a3b ^
  4.   --no-mmap ^
  5.   --flash-attn on ^
  6.   --jinja ^
  7.   -ctk q8_0 -ctv q8_0 ^
  8.   --no-mmproj ^
  9.   --mlock ^
  10.   --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  11.   --presence-penalty 0.0 --repeat-penalty 1.0 ^
  12.   --reasoning-budget -1 ^
  13.   --host 0.0.0.0 --port 8033 ^
  14.   -np 1 ^
  15.   --threads 12 ^
  16.   --ctx-size 131077 ^
  17.   --n-cpu-moe 28 ^
  18.   --main-gpu 0 ^
  19.   --fit on ^
  20.   --fit-target 512


La répartition qu'il me sort :
https://rehost.diberie.com/Picture/Get/f/521017
 
J'ai tenté de configurer les couches manuellement mais même résultat
--split-mode layer  
--tensor-split 21,21
--fit off


Je pense qu'il faut que la somme de tes layers arrive a 41
donc par exemple 5+18+18:
 

Code :
  1. --ctx-size 131077 ^
  2. --n-cpu-moe 5 ^
  3. --tensor-split 18,18^
  4. --fit off


---------------
Faudra que je teste un jour :o
n°39081
the_fennec
f3nn3cUs z3rd4
Posté le 12-06-2026 à 22:32:36  profilanswer
 

croustx a écrit :

avez vous essayé les version heretic ?


Oui, Qwen3.6-35B-A3B-uncensored-heretic-APEX-I-Balanced de mudler:
https://huggingface.co/mudler/Qwen3 [...] -APEX-GGUF
 
ça fait le taf' :o


---------------
Faudra que je teste un jour :o
n°39082
croustx
Modoadorateur
Posté le 12-06-2026 à 22:40:55  profilanswer
 

the_fennec a écrit :


Oui, Qwen3.6-35B-A3B-uncensored-heretic-APEX-I-Balanced de mudler:
https://huggingface.co/mudler/Qwen3 [...] -APEX-GGUF
 
ça fait le taf' :o


Impossible de le faire fonctionner sur openclaw par contre. Il ne répond pas

n°39084
jojo_le_ha​ricot
Posté le 12-06-2026 à 22:49:22  profilanswer
 

the_fennec a écrit :


Je pense qu'il faut que la somme de tes layers arrive a 41
donc par exemple 5+18+18:
 

Code :
  1. --ctx-size 131077 ^
  2. --n-cpu-moe 5 ^
  3. --tensor-split 18,18^
  4. --fit off


En fait il semblerait que le problème ne vienne pas de --n-cpu-moe car même quand je ne l'utilise pas ça merde quand j'utilise --tensor-split
 
Cette config fonctionne :

Code :
  1. --ctx-size 131077 ^
  2. --fit on


Celle-ci non (quelles que soient les valeurs pour tensor-split) :

Code :
  1. --ctx-size 131077 ^
  2. --tensor-split 21,20^
  3. --fit off


https://rehost.diberie.com/Picture/Get/f/521034


---------------

n°39085
neo world
Posté le 12-06-2026 à 22:52:59  profilanswer
 

croustx a écrit :


Impossible de le faire fonctionner sur openclaw par contre. Il ne répond pas


y'a pas de raison. Tu dois avoir une erreur de config dans l'URL / modèle. Tu le charges en just in time ?
 
sinon heretic marche bien chez moi aussi :jap:

n°39086
neo world
Posté le 12-06-2026 à 22:55:37  profilanswer
 

jojo_le_haricot a écrit :


En effet pour le cas présent mais imaginons que je veuille faire la meme chose avec un contexte de 260k et une quantification q8 :)


eh ben il est temps d'y installer une troisième carte je pense :D
 
https://i.redd.it/7rv548awfuea1.gif

Message cité 1 fois
Message édité par neo world le 12-06-2026 à 22:56:01
n°39088
jojo_le_ha​ricot
Posté le 12-06-2026 à 22:58:15  profilanswer
 

neo world a écrit :


eh ben il est temps d'y installer une troisième carte je pense :D
 
https://i.redd.it/7rv548awfuea1.gif


Déjà tenté  :o  
 
Malheureusement il ne reste que des ports pcie 1x de dispo donc ça fait chuter grandement les perf  :pfff:


---------------

n°39090
neo world
Posté le 12-06-2026 à 23:04:35  profilanswer
 

jojo_le_haricot a écrit :


Déjà tenté  :o  
 
Malheureusement il ne reste que des ports pcie 1x de dispo donc ça fait chuter grandement les perf  :pfff:


M2 + oculink pour récupérer 4 liens PCI express tout frais :D

n°39091
neo world
Posté le 12-06-2026 à 23:06:08  profilanswer
 
n°39094
jojo_le_ha​ricot
Posté le 12-06-2026 à 23:08:59  profilanswer
 

neo world a écrit :


M2 + oculink pour récupérer 4 liens PCI express tout frais :D


[:billy-bob jambonbeur]


---------------

 Page :   1  2  3  4  5  ..  14  15  16  ..  66  67  68  69  70  71

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)