Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5223 connectés 


Avez-vous basculé sur ChatGPT Plus ?


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  495  496  497  ..  551  552  553  554  555  556
Auteur Sujet :

[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co

n°48167
Quich
Pouet ?
Posté le 08-09-2026 à 10:33:47  profilanswer
 

Reprise du message précédent :

Quich a écrit :

En parlant d'amélioration, pour ne pas cramer tout mon quota codex (en Luna max, j'atteins souvent le quota 5h ), j'utilise la partie Chat de l'app pour faire les plans et les prompts à filer à codex, et parfois pour modifier un peu de documentation.


Souvent, il me donnait des prompts en inline dans "des balises codes" (je ne sais pas comment ça s'appelle sur l'appli) comme ceci :
https://rehost.diberie.com/Picture/Get/r/540437
Mais la "balise" était souvent cassé en plein milieu du prompt qu'il me donnait et ça mettait la suite du prompt en "texte normal" donc à copier-coller c'était très chiant.
Depuis quelques jours je n'ai plus le soucis du tout, donc c'est plus pratique.


Je ne sais pas si c'est une très bonne approche cela dit, parce que les prompts qu'il me génère sont de plus en plus longs  :pt1cable:


Par ailleurs, j'ai installé l'app ChatGPT "officielle" sur Ubuntu 24 et non plus l'adaptation de l'app MacOS qu'on trouvait sur https://github.com/ilysenko/codex-desktop-linux et ça fonctionne correctement pour mon cas d'usage :jap:


Je fais tout depuis mon téléphone : un VPS 3vCPU/20GBram/100GBssd à 8€/mois sur PacketDecreaser ; Ubuntu 24 server + xfce avec l'app desktop ChatGPT ; contrôle de codex via l'app Android ChatGPT en remote ; accès ssh/sftp avec Termius pour les actions git ou quand j'ai des fichiers à transférer ; accès au desktop via l'app Android aRDP dans un tunnel ssh si vraiment j'ai besoin de voir le desktop.


J'avais installé Hermes sur le VPS avec utilisation du backend codex car le remote de l'app ChatGPT a été cassé ~24h mais finalement je ne m'en sers pas.


Quelques updates sur mon approche.


Je cramais le quota assez vite même en sélectionnant toujours 5.6-luna depuis l'App Android.
Je me suis rendu compte que j'avais laissé les définitions de certains sous agents avec du 5.6-tera, du 5.5 voire rien et qu'il choisissait le modèle de manière non pertinente.
https://rehost.diberie.com/Picture/Get/r/542210
J'ai corrigé ça en mettant 5.6-luna partout mais j'avais toujours une grosse conso.


J'ai fait un audit avec le chat de l'App ChatGPT, ce qui a permis d'améliorer l'agents.md et les définitions des sous-agents.
Synthèse :

Citation :


Alarming symptom: development was consuming roughly 3.6 billion tokens over Aug 28–Sep 2, with about 96–97% cached input. We initially suspected context inheritance and long-lived chats. Both turned out to be secondary or mostly false leads.


The current Codex strategy is therefore: Fresh compact task → bounded root coordinator → scoped implementer for substantial changes → focused tests → only justified specialist reviewers → final verification → stop.


And several things we originally suspected have now been effectively ruled out as primary causes: Android Remote chat reuse, full-history subagent forking, giant tool outputs, exact-command repetition, and implementer reasoning effort.


The dominant historical causes were overactive root execution, excessive iterative repository exploration/validation, repeated compaction cycles, and automatic specialist/reviewer fan-out.


OLD
large cached context x ~1,000 execution/reasoning cycles x many compactions = enormous usage


NEW
large cached context x ~200-300 cycles x 1-3 compactions = far lower usage


Before, the substantial-task distribution was roughly:
- Q1: 176M
- median: 251M
- Q3: 360M


After:
- Q1: 51M
- median: 69M
- Q3: 99M


Bon, par contre ma plus value dans l'histoire est assez faible :
1) je demande au chat dans l'App ChatGPT de me produire un prompt pour codex en respectant certains guidelines, pour implémenter telle feature.
2) je copie-colle le prompt à codex.
3) je copie-colle la réponse de codex à l'App ChatGPT, l'App me donne un nouveau prompt de vérification indépendante.
4) je copie-colle le prompt de vérification dans une nouvelle session codex.
5a) si la vérification ne ressort aucun problème (rarement le cas), l'implémentation est validée.
5b) si la vérification ressort des problèmes, je copie-colle la réponse de codex suite à la vérification à l'App ChatGPT pour qu'il me donne un prompt de remédiation et on repart en étape 2 jusqu'à arriver en 5.a.


J'ai déjà une liste de features à implémenter qui sont relativement bien spécifiées avec des priorités, donc c'est assez chiant de devoir faire ça où je ne sers globalement qu'à faire du copier-coller.


Vu que j'ai mis Hermes sur le VPS, j'essaie d'automatiser cela via Hermes (en m'appuyant sur le chat ChatGPT pour tout ce qui est conf/archi), en utilisant sur des modèles dispos via NVIDIA Build pour éviter de bouffer le quota codex et pour garder les contextes bien séparés, mais c'est pour l'instant un échec.
Auriez-vous des idées ?


Edit : et merci pour les infos sur les resets, il me restait 15% en weekly hier soir, j'ai lancé une tâche de review en 6-astra medium sur un point particulier et il a trouvé pas mal de trucs, ça a bouffé 8% du quota en 10-15 minutes, et j'ai pu commencé les corrections avec mon process habituel avant le reset :jap:


Message édité par Quich le 08-09-2026 à 10:39:09

---------------
Feedback
n°48168
magicien96
Même pas peur @sato
Posté le 08-09-2026 à 10:38:39  profilanswer
 

jix a écrit :


Tu as quand même toutes tes données en local, github et cie [:transparency]


Yes et sauvegardées sur Github :jap:


---------------
Ils ne savaient pas que c'était impossible, alors ils l'ont fait. ©Mark Twain
n°48169
Piwig
SteamID : Piwig
Posté le 08-09-2026 à 10:47:10  profilanswer
 

C'est vrai qu'on garde les données en local avec obsidian...
Tu as néanmoins raison. Après on peut adopter les deux je dirais. En tout cas pour l'instant c'est ce que j'ai en place :)

n°48170
FlorentG
Posté le 08-09-2026 à 10:49:36  profilanswer
 

Piwig a écrit :

Pour le développement logiciel, l’avancée est particulièrement intéressante : combinée à la capacité du modèle à poursuivre un objectif sur plusieurs heures, elle ouvre la voie à des agents réellement autonomes sur des tâches complexes.


Ça c'est une des avancées les plus importantes.
 
Je l'ai lancé sur la transformation de mon Excel de gestion de comptes personnels vers une application web full-fledged. On a commencé par faire un cahier des charges complet. Là il bosse depuis hier soir, et il est en train d'itérer tout seul. Je peux même voir ce qu'il fabrique à distance avec le mode Remote [:implosion du tibia]

n°48171
Jules Winn​field
порой не та...
Posté le 08-09-2026 à 10:49:39  profilanswer
 

C'est passé, Astra qui régularise les captchas ?
https://www.numerama.com/tech/23269 [...] eveux.html

n°48172
FlorentG
Posté le 08-09-2026 à 10:51:42  profilanswer


J'ai vu ça hier sur X. Mais il me semblait que de toute manière le captcha du genre "saisissez les lettres" ou "sélectionnez les bornes à incendies" étaient morts depuis longtemps. C'est pour ça que ReCaptcha v3 utilise une analyse comportementale avec un score heuristique à la clé.

n°48173
XaTriX
Posté le 08-09-2026 à 11:03:02  profilanswer
 

Au bout de presque 5 jours de travail avec Fable 5.1 low et quelques subagent Opus 5 xhigh je suis à 46% sur la quota Fable et 32% sur le quota tous modèles, pour un Max6.
Je pense tester une semaine entière sur Fable 5.1 xhigh, il fait l'orchestration et fait du gate aussi en subagent, voir de la review.  
Ma théorie - toujours la même - c'est qu'autant y aller à fond avec le même mode de chaque modèle pour l'efficacité/meilleure efficience. Si on peut éviter de revenir plus tard sur un truc généré par le meilleur mode, c'est de l'économie de token/temps au final.
 
En tout cas Fable 5.1 est moins débile qu'Opus 5 xhigh sur de l'orchestration/"long" run.
Astra est très bon mais putain le quota il se barre vite :o mais quand même y'a de quoi faire sur un compte à 20 boules ... alors avec les reset ;)


---------------
[:dawa]
n°48176
speedboyz3​0
Guide Michelin :o
Posté le 08-09-2026 à 11:39:13  profilanswer
 

Mevo a écrit :


Tu n'es pas forcément obligé de faire du H24, les GPUs peuvent se louer facilement à l'heure (et tu payes très peu, voire quasi rien, lorsque tu n'utilises pas. Ensuite, tu bootes le truc dès que t'as besoin, tu lances un gros batch, et tu ré-arrêtes - c'est même automatique)
 
Ca ne se vend pas "au Go", mais par GPU, donc tu ne peux pas ajuster exactement comme tu veux, il faut prendre ce qui colle à peu près pour que tu aies au moins assez + ce qu'il faut pour le contexte, tout en essayant que ce soit le moins possible (pour les $$$ :o ). En plus, ce qui est chiant est que tu ne peux généralement avoir qu'un nombre pair de GPUs. Si tu pouvais en avoir 3, ca t'arrangerait bien pour utiliser du GLM 5.3 Flash quantifié en Q4 (c'est un peu moins performant, mais ca marche tout de même bien). Ca ferait 200 Go tout rond pour du Q4 XL, mais 3 GPU, c'est pas trop possible.
 
Tu peux regarder chez AWS, ou il y a un tas de providers qui proposent ca. (Lambda, Vast, etc.)
 
Disons que si t'es quand même un peu radin comme moi ( :o ), et que tu te contentes d'une quantification en 6 bits (là, t'es bien, en rapport taille/perf). GLM 5.3 Flash Q6 XL, c'est 292 Go.
4 GPUs de 80 Go te fera 320 Go, ca devrait être chouette. De l'A100, qui est dans le "pas trop cher", mais tout de même performant, et ca a 80 Go, ca coute par exemple $2.5 de l'heure chez AWS. Donc $10 l'heure pour 4. T'as 720 ou 750 heures par mois (30 ou 31 jours) si tu veux tourner en continu (soit $7200 à $7500 par mois). EDIT: En fait, c'est 744 heures pour un mois de 31 jours, mais 750 est souvent utilisé pour tout calculer facilement :o
 
Tu dois pouoir trouver assez facilement moins cher que AWS, surtout si t'es flexible (certains providers font de super tarifs si tu acceptes de te faire éjecter dès qu'ils ont un besoin. Tu loues ce qui est inutilisé et t'acceptes de lâcher à n'importe quel moment en échange d'un bon prix).
 
Vast annonce de la H100 (une version supérieure à la A100, aussi avec 80 Go) mentionée par LibreArbitre à $2 de moyenne en ce moment et à partir de $1.33. Ca te donne à peu près les chiffres pour faire tes calculs (donc x4 et c'est par heure).


Intéressant  [:zyzz:2]

n°48177
Olivie
SUUUUUUUUUUUUUU
Posté le 08-09-2026 à 11:42:29  profilanswer
 

Astra Pro qui vient de disparaître dans mon app ChatGPT alors que je l’ai presque pas utilisé aujourd’hui (après reset)
 
https://img3.super-h.fr/images/2026/09/08/snapshot_6316293841480413489.jpg


---------------

n°48178
XaTriX
Posté le 08-09-2026 à 11:43:58  profilanswer
 

cheh


---------------
[:dawa]
n°48179
AllenMadis​on
Oracle du Keb's
Posté le 08-09-2026 à 11:50:16  profilanswer
 

Des nouvelles du bébou Mistralou


https://i.imgur.com/c3PvAcJ.png


On est sauvés :o


Et HuggingFace va héberger le modèle Le Chaton Fat


Fat annonces que cela


Message édité par AllenMadison le 08-09-2026 à 11:51:04

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°48184
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 08-09-2026 à 12:32:45  profilanswer
 

AllenMadison a écrit :

Saint Tibo a délivré le reset :o


 [:bulldozer_fusion:1]

Piwig a écrit :


Oui !
En plus, ça va éviter qu’avec une requête mal formée on bouffe tous nos tokens dans deux secondes…
Je me demande si on peut aller plus loin en lui demandant d’estimer combien il utiliserait de pourcentage de notre abonnement pour pour un prompt…


Faut pas trop en demander non plus :O


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°48186
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 08-09-2026 à 12:52:50  profilanswer
 

Olivie a écrit :

Y a des petits soucis de réseau avec ChatGPT la…


Le gars qui veut encore gratter un reset  :O


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°48193
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 08-09-2026 à 13:24:54  profilanswer
 

Mistral donne signe de vie

Citation :

L'entreprise française d'intelligence artificielle Mistral est désormais valorisée à plus de 21 milliards d'euros, après avoir levé 3 milliards d'euros auprès du géant coréen Samsung notamment, afin de développer son infrastructure et ses travaux de recherche.


https://x.com/BFMTV/status/2097199689191874831


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°48199
Olivie
SUUUUUUUUUUUUUU
Posté le 08-09-2026 à 14:09:38  profilanswer
 

Vous avez tous encore accès à Astra Pro dans le chat ? Je suis le seul à ne plus le voir ? :o


---------------

n°48200
XaTriX
Posté le 08-09-2026 à 14:10:20  profilanswer
 

oui


---------------
[:dawa]
n°48201
Olivie
SUUUUUUUUUUUUUU
Posté le 08-09-2026 à 14:12:08  profilanswer
 

bulldozer_fusion a écrit :

Mistral donne signe de vie

Citation :

L'entreprise française d'intelligence artificielle Mistral est désormais valorisée à plus de 21 milliards d'euros, après avoir levé 3 milliards d'euros auprès du géant coréen Samsung notamment, afin de développer son infrastructure et ses travaux de recherche.


https://x.com/BFMTV/status/2097199689191874831


Cool :o
 
https://img3.super-h.fr/images/2026/09/08/snapshot_7413006242947890349.jpg


---------------

n°48202
XaTriX
Posté le 08-09-2026 à 14:23:54  profilanswer
 

OQTF :fou:


---------------
[:dawa]
n°48203
XaTriX
Posté le 08-09-2026 à 14:33:20  profilanswer
 

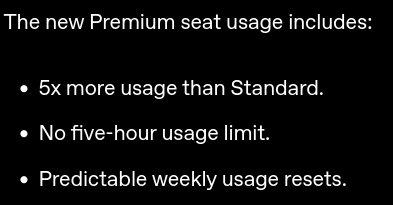
https://rehost.diberie.com/Picture/Get/f/542265
C'est quoi ce predictable weekly usage resets ? :D


---------------
[:dawa]
n°48204
fabien
Vive la super 5 !
Posté le 08-09-2026 à 14:36:53  profilanswer
 

XaTriX a écrit :

https://rehost.diberie.com/Picture/Get/f/542265
C'est quoi ce predictable weekly usage resets ? :D


sûrement des reset fixe au lieu du bon vouloir de tibo genre 1 par semaine ? 4 par mois? ...


---------------
✈ Découvre le HFRcoin ✈ - smilies ♥
n°48206
FlorentG
Posté le 08-09-2026 à 14:44:52  profilanswer
 

XaTriX a écrit :

https://rehost.diberie.com/Picture/Get/f/542265
C'est quoi ce predictable weekly usage resets ? :D


C'est le reset automatique tous les 7 jours [:petrus dei]

n°48207
XaTriX
Posté le 08-09-2026 à 14:45:04  profilanswer
 

:D


---------------
[:dawa]
n°48211
AllenMadis​on
Oracle du Keb's
Posté le 08-09-2026 à 15:09:45  profilanswer
 

Tu sais en exclusivité quand Tibo va reset ? :o


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°48214
ezzz
23
Posté le 08-09-2026 à 15:18:08  profilanswer
 
n°48224
skipass
Posté le 08-09-2026 à 17:03:37  profilanswer


Ils ont clairement pivoté sur:
- du service,
- des modèles de niche,
- des datacenters.
 
C'est pas glorieux pour "3 génies des LLM".
Mais ca justifie sans pb les 3 mds.
 
Après avoir échoué sur leur cœur de compétence, vont-ils réussir sur des domaines qui semblent très différents ? Je ne sais pas.  
S'ils sont capables de ne pas se prendre pour plus malins qu'ils ne sont, ils peuvent encore faire un truc.
 
J'aurais bien voulu voir OVH la dessus. Mais ovh est resté tres bas niveau, donc bon (pour info, ovh met a dispo des modeles open source d'ailleurs).
 
Le pire aurait été qu'ils continuent a faire des modèles très en retard mais que politiquement ils arrivent à la jouer pour que l'administration et les entreprises de défense soient forcées de l'utiliser. La un codeur de chez Dassault peut bosser avec un modèle correct. Chinois mais correct :o
 
Et on sait jamais, si les progrès se stabilisent dans 1 ou 2 ans ils pourront revenir. Je serais moins inquiet par la valo a 20mds de Mistral que par celle a 2000 Mds d'Anthropic.

Message cité 1 fois
Message édité par skipass le 08-09-2026 à 17:05:01
n°48225
XaTriX
Posté le 08-09-2026 à 17:13:07  profilanswer
 

J'ai envie de loger mes quotas, ça se fait déjà ?
 
J'ai codexbar qui m'export la donnée vers mes harness CC/Codex pour donner aux modèles cette info (et quand switcher de compte, lancer un cooldown, etc) mais j'aimerais bien loguer tout ça..  
Peut être même inclure l'utilisation des modèles, ça peut aider pour le comparo.
 
Je sais pas si les data codex (web) peuvent être extraites


---------------
[:dawa]
n°48228
Mevo
Divergent
Posté le 08-09-2026 à 17:25:41  profilanswer
 

skipass a écrit :

Ils ont clairement pivoté sur:
- du service,
- des modèles de niche,
- des datacenters.
 
C'est pas glorieux pour "3 génies des LLM".
Mais ca justifie sans pb les 3 mds.


Ouais, je sais pas trop. Si ca devient une boite de services, est-ce que ca vaut 21 Mards ? OVH n'en vaut guère que 2, par exemple. Donc tout OVH est valorisé MOINS que la dernière levée de fonds de Mistral.
 
Et sur les modèles, je crains qu'on en arrive à du "monopole à la Google".
Les "meilleurs" (ou LE meilleur) modèles deviennent les plus utilisés et captent la majorité des prompts (datas) afin de pouvoir améliorer le modèle. Ca créé une boucle de rétroaction qui laisse les autres dans le vent.
 
Surtout que la collecte de données publiques sur le web ne s'annonce pas forcément super bien. Tu as ceux qui limitent de plus en plus l'accès, les données qui ne sont déjà plus que de la création d'anciens modèles et la baisse de la création par changement de paradigme (tu vas encore te faire ch*er à créer du contenu original alors qu'il peut être pompé, repackagé et reposté automatiquement et instantanément ? + Google ou autre moteur de recherche qui ne te renvoie plus personne et ton contenu n'est même plus découvert comme avant. En fait, ce sont les moteurs de recherches et l'ensemble des plateformes de LLMs eux-même qui te piquent et repackagent ton contenu directement...)
 
La meilleure source de donnée à l'avenir semble l'UTILISATION des modèles. Celui qui gagne éventuellement là, risque de peut-être tout rafler => Donc il faut engloutir autant de pognon que possible pour développer le meilleur modèle. Mistral là-dedans ? Please :o

Message cité 1 fois
Message édité par Mevo le 08-09-2026 à 17:26:15

---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°48229
kaloskagat​os
Posté le 08-09-2026 à 17:40:45  profilanswer
 

XaTriX a écrit :

J'ai envie de loger mes quotas, ça se fait déjà ?
 
J'ai codexbar qui m'export la donnée vers mes harness CC/Codex pour donner aux modèles cette info (et quand switcher de compte, lancer un cooldown, etc) mais j'aimerais bien loguer tout ça..  
Peut être même inclure l'utilisation des modèles, ça peut aider pour le comparo.
 
Je sais pas si les data codex (web) peuvent être extraites


https://ccusage.com/ ?


---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°48231
skipass
Posté le 08-09-2026 à 17:50:44  profilanswer
 

Mevo a écrit :

Ouais, je sais pas trop. Si ca devient une boite de services, est-ce que ca vaut 21 Mards ?


Je sais pas non plus. Le modèle de Forward Deployed Engineer, c'est pas exactement du service classique. C'est le truc poussé par Palantir, même si ca existait bien avant. C'est "J'ai un framework compliqué pour des besoins compliqués, donc je met des ingénieurs de choc chez le client pour utiliser et surtout développer le framework".  Si tu réussi c'est top. C'est aussi très très dur a faire. Tu finis souvent avec une version de ton framework par client, et tu exploses sous les problèmes de qualité et de coûts dus a la duplication.
 
Ils ont échoué la ou ils étaient sensé être bons, donc il y a sans doute des problèmes sérieux à résoudre quelque part chez eux pour réussir ca. Sont-ils dessus? No idea.


Mevo a écrit :

Et sur les modèles, je crains qu'on en arrive à du "monopole à la Google".
Les "meilleurs" (ou LE meilleur) modèles deviennent les plus utilisés et captent la majorité des prompts (datas) afin de pouvoir améliorer le modèle. Ca créé une boucle de rétroaction qui laisse les autres dans le vent.


Ah, mais c'est tout l'interet de leur move vers les datacenters et l'hébergement de modèles chinois open source. Ils vont avoir ces infos. Pas toutes les infos du monde mais des infos.
 
Par contre, j'ai l'impression qu'actuellement il y a un travail sur la qualité plus que sur la quantité, cf. les dev facebook a qui on demande d'écrire des exemples pour leur modèle.


n°48232
Iryngael
Awesome, ain't it ?
Posté le 08-09-2026 à 17:51:22  profilanswer
 

Comment et dans quel cadre vous demandez/faites spawner des sous-agents ?


---------------
/!\ Le point de rendez-vous des amateurs de vieux matos informatique c'est ici !/!\
n°48234
LePcFou
Delinquant textuel
Posté le 08-09-2026 à 17:59:28  profilanswer
 

Je comprend rien à ce topic !
Vous utilisez l'ia pour le boulot ?
Pour du dev d'applications ?
Bizarre votre monde :o


---------------
Je reste dans mon coin enfermé chez moi et je regarde la fin du monde tranquillement car j'y peux rien
n°48235
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 08-09-2026 à 18:01:18  profilanswer
 

Iryngael a écrit :

Comment et dans quel cadre vous demandez/faites spawner des sous-agents ?


Ben quand tu juges en avoir besoin
Ça permet dans mon cas plutôt que de lancer une tâche avec un modèle super intelligent puis de manuellement devoir basculer vers un autre modèle moins intelligent par la suite pour l'exécution
De toute faire d'une traite avec le prompt et tu optimises les coûts


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°48236
Iryngael
Awesome, ain't it ?
Posté le 08-09-2026 à 18:02:28  profilanswer
 

Mais comment ca se passe ? tu dis dans le prompt de reflechir avec un modele et coder avec un autre ?


---------------
/!\ Le point de rendez-vous des amateurs de vieux matos informatique c'est ici !/!\
n°48237
AllenMadis​on
Oracle du Keb's
Posté le 08-09-2026 à 18:04:11  profilanswer
 

LePcFou a écrit :

Je comprend rien à ce topic !
Vous utilisez l'ia pour le boulot ?
Pour du dev d'applications ?
Bizarre votre monde :o


Pour cuisiner et pour optimiser le trajet pour promener le cleb's :o


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°48238
Olivie
SUUUUUUUUUUUUUU
Posté le 08-09-2026 à 18:09:09  profilanswer
 

Iryngael a écrit :

Comment et dans quel cadre vous demandez/faites spawner des sous-agents ?


Quand il me reste du quota et que je veux aller vite.
Je lui dis "utilises des sous-agents"  [:michel_cymerde:7]


---------------

n°48239
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 08-09-2026 à 18:11:17  profilanswer
 

Iryngael a écrit :

Mais comment ca se passe ? tu dis dans le prompt de reflechir avec un modele et coder avec un autre ?


Bah oui


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°48241
Mevo
Divergent
Posté le 08-09-2026 à 18:22:27  profilanswer
 

skipass a écrit :

Par contre, j'ai l'impression qu'actuellement il y a un travail sur la qualité plus que sur la quantité, cf. les dev facebook a qui on demande d'écrire des exemples pour leur modèle.

Très clairement. La qualité de la donnée utilisée pour entrainer un modèle est super importante. Tu ne peux pas utiliser n'importe quoi, sinon t'as du "garbage in/garbage out".
Mais avec la quantité, tu peux ensuite analyser avec un modèle afin de trouver la qualité. Ou des patterns. Et que le modèle en extrait les paires de données "qui vont bien" pour l'entrainement futur. En soumettant ce qu'il trouve à des humains d'abord, au besoin.
 
Rien que si tu cherches les occurences fréquentes d'utilisateurs qui répondent quelque chose du genre "mais tu racontes n'importe quoi !", tu peux éventuellement identifier des corrections/améliorations à apporter par rapport à l'entrainement précédent. Et tu peux décliner cette facon de faire à fond: Tous les prompts qui indiquent qu'il a fallu corriger une manière de faire, là où les utilisateurs ont copié/collé un exemple, etc.
 
Je suppose que la quantité n'est pas une fin en soi, mais elle permet tout cela.
 
Se baser sur l'open-weight Chinois a aussi sa dose d'incertitude: Ils peuvent arrêter de fournir en open-weight à tout moment et passer en propriétaire (peut-être qu'il y a des deals qui sont conclus pour que les modèles restent partagés en privé s'ils deviennent proprio, ca, j'en sais rien)


Message édité par Mevo le 08-09-2026 à 18:26:05

---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°48242
Quich
Pouet ?
Posté le 08-09-2026 à 18:24:31  profilanswer
 

Iryngael a écrit :

Mais comment ca se passe ? tu dis dans le prompt de reflechir avec un modele et coder avec un autre ?


Mon agents.md définit, entre autres : pour quelles tâches codex doit lancer un sous agent ; quels sont les types de sous agents et leurs rôles ; qu'est-ce que codex doit transmettre aux sous agents ; etc.
Une bonne moitié du agents.md est dédiée à l'orchestration des sous agents en fait.
Extrait :

Citation :

## Subagent orchestration
Use the minimum number of agents needed to complete the task reliably.
Delegation is for bounded work, not a mandatory workflow stage.
### Available roles
- `explorer`: targeted read-only repository discovery when affected paths or architecture
are genuinely uncertain.
- `implementer`: implement one clearly bounded component.
- `tester`: independent test design, substantial coverage analysis, or failure diagnosis when separately useful.
- `security_reviewer`: review material security-boundary changes.
- `persistence_reviewer`: review material schema or persistence changes.
- `verifier`: independently verify completed non-trivial changes.


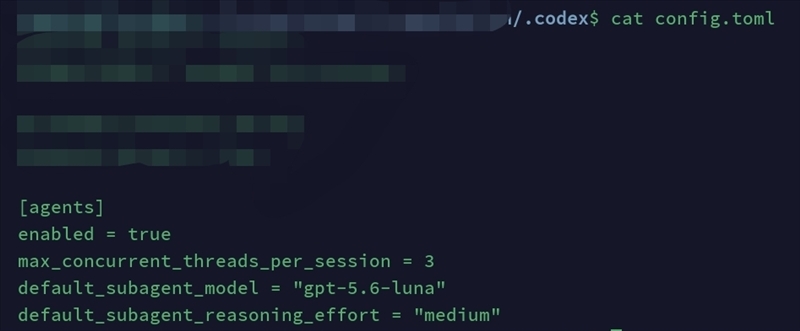
Le config.toml dans le dossier .codex du projet active l'utilisation des agents :
https://rehost.diberie.com/Picture/Get/r/542321


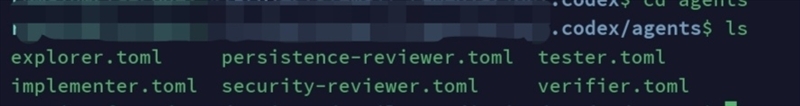
Ainsi que un .toml par type d'agent pour les infos par sous agents (type de modèle , reasoning, objectifs de l'agent, etc.) dans le répertoire .codex/agents/ du projet :
https://rehost.diberie.com/Picture/Get/r/542319


Quand je demande à codex de développer un truc, le thread de base ne sert que d'orchestrateur et il s'appuie sur l'agents.md et utilise des sous agents des différents types suivant le besoin et suivant où il est rendu.


Tout ça a été fait en suivant les recos de ChatGPT qui sortent de la doc d'OpenAI, enfin s'il n'a pas fait de conneries :o


Message édité par Quich le 08-09-2026 à 18:32:29

---------------
Feedback
n°48243
ezzz
23
Posté le 08-09-2026 à 18:35:29  profilanswer


je crois que dans ma boite, les deux modèles mis à dispo sont les deux à 0%
du coup, c'est la courses à faire 12000 skills car les agents sont trop mauvais de base
et les mecs sont contents de faire des "démo IA" pour dire qu'ils ont réussi à faire corriger 2 lignes de Python après 8 prompts
 
on est bien  [:otobox:2]


---------------
mon flick r - 23 - https://youtu.be/LAr6oAKieHk
n°48245
ChrisPc
Posté le 08-09-2026 à 19:40:46  profilanswer
 

LePcFou a écrit :

Je comprend rien à ce topic !
Vous utilisez l'ia pour le boulot ?
Pour du dev d'applications ?
Bizarre votre monde :o


Bah quand tu es dans le dev, tu travailles 100 fois plus vite pour faire un site, un jeu, un fichier 3D, des actions répétitives, des modèles de machine learning/deep learning, ton apprentissage, ton résumé du matin technologiques devant ton café, chercher un boulot après trie par l'IA,...
 
Tu fais comment toi pour faire sans ?  :lol:

n°48246
Olivie
SUUUUUUUUUUUUUU
Posté le 08-09-2026 à 19:44:55  profilanswer
 

LePcFou a écrit :

Je comprend rien à ce topic !
Vous utilisez l'ia pour le boulot ?
Pour du dev d'applications ?
Bizarre votre monde :o


Dans moins d’un an ça aura autant de sens que de demander si les gens utilisent internet. Donc autant si mettre maintenant[:michel_cymerde:7]


---------------

 Page :   1  2  3  4  5  ..  495  496  497  ..  551  552  553  554  555  556

Aller à :
Ajouter une réponse
 

Sujets relatifs
sécurité de l'IA / agentique et des Devs en roue libre 
Plus de sujets relatifs à : [Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)