Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
2236 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  83  84  85  86  87  88  89  90
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°53246
neo world
Posté le 13-10-2026 à 17:32:43  profilanswer
 

Reprise du message précédent :

the_fennec a écrit :


Mais au final est-ce qu'on a besoin de tant de BP que ça? Même en passant en mode tensor RPC le 27B la BP était pas haute que ça, mais la latence tue tout.
 
Quand j'avais testé en 2.5Gbps j'ai pas noté de différence de perf.


le problème est bien la latence : quand la bande passante sature elle explose. Diminuer la vitesse des échanges revient à augmenter la latence des échanges. Les deux sont importants et interdépendants :jap:

n°53248
moyen_moin​s
chat réincarné
Posté le 13-10-2026 à 17:36:09  profilanswer
 

the_fennec a écrit :


Mais au final est-ce qu'on a besoin de tant de BP que ça? Même en passant en mode tensor RPC le 27B la BP était pas haute que ça, mais la latence tue tout.
 
Quand j'avais testé en 2.5Gbps j'ai pas noté de différence de perf.


the_fennec a écrit :


La prochain Qwen4 35BA3B (ou équivalent) va être un massacre je pense, surtout si on a un "Strata" like pour le servir. Même llama.cpp déboîte bien avec le 35B. Ya moyen d'avoir les même perfs que 35B avec la qualité du 27B :love: genre avec 8GB de VRAM et 16GB de RAM!.


Dommage qu'il y ait pas eu ça en 3.8
Le 27B est bon mais punaise, en xhigh, faut avoir le temps ou la machine a craché du token...

n°53249
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 17:37:20  profilanswer
 

neo world a écrit :

sinon je suis en train de télécharger https://huggingface.co/huihui-ai/Hu [...] ed-v2-GGUF en UD Q4 K XL pour l'héberger avec gufo. Je vous tiens au courant si ça semble être un bon modèle non censuré :jap:


J'ai vu passer ça, mais pas testé :o
https://www.reddit.com/r/LocalLLaMA [...] _inject_a/
 
L'idée est de précharger le contexte de n'importe quel modèle avec un KV "graft" qui évite les refusal. Je pensais qu'il y avait plus de retours, j'avais gardé ça dans le coin de ma tête. Visiblement ça n'a pas eu beaucoup de succès mais le potentiel est intéressant.


---------------
Faudra que je teste un jour :o
n°53251
neo world
Posté le 13-10-2026 à 18:02:26  profilanswer
 

Bon des gens déclarent leur amour à une IA mais est-ce qu'on a déjà observé ce phénomène avec un moteur d'hébergement d'IA ?  [:lavie_lavraie]  
 

Citation :


262K context at about 1,430 tok/s prefill
about 42 tok/s decode with MTP  
Draft acceptance : 64-71%
prefix-cache hits in under 5 seconds
33 GiB of memory still free


Toujours avec mon https://huggingface.co/huihui-ai/Hu [...] ed-v2-GGUF UD Q4 K XL
 
Je sais pas où Gufo planque le reste des données comme y'en a pour 111GO quand même mais puré  [:palmyre] :D
 
le modèle ne refuse rien et ne semble pas halluciner particulièrement :D

Message cité 1 fois
Message édité par neo world le 13-10-2026 à 18:03:48
n°53252
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 18:30:29  profilanswer
 

Ben t'as les lookups tables qui restent sur disque, d’où tes 33GB de libre.


---------------
Faudra que je teste un jour :o
n°53253
neo world
Posté le 13-10-2026 à 18:38:37  profilanswer
 

Sans impact sur les perfs ? [:siluro]

n°53254
tfpsly
Sly
Posté le 13-10-2026 à 18:39:45  profilanswer
 

moyen_moins a écrit :


Dommage qu'il y ait pas eu ça en 3.8
Le 27B est bon mais punaise, en xhigh, faut avoir le temps ou la machine a craché du token...


3.8 MoE reste très bon en medium qu'en xhigh, mais bien plus rapide.
https://www.youtube.com/watch?v=oKb [...] eRefresh=1

n°53256
moyen_moin​s
chat réincarné
Posté le 13-10-2026 à 18:51:17  profilanswer
 

3.8 en MoE existe pas (enfin pas le flash next), c'est du dense et c'est tout.
ou alors j'ai pas compris.

n°53257
tfpsly
Sly
Posté le 13-10-2026 à 19:03:27  profilanswer
 

Tu parlais pas du 27B - qui existe bien en MoE ? Le Flash Next fait 125B.

n°53266
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 19:51:41  profilanswer
 

neo world a écrit :

Sans impact sur les perfs ? [:siluro]


Oui; c'est une des nouveautés de Qwen4, la lookup table qui fait 30GB et reste sur le disque. Faut quand même un SSD, mais ça cache les résolutions de tokens les plus communes.


---------------
Faudra que je teste un jour :o
n°53267
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 19:52:13  profilanswer
 

tfpsly a écrit :

Tu parlais pas du 27B - qui existe bien en MoE ? Le Flash Next fait 125B.


Non le 27B n'est que dense, c'est le 35BA3B qui est MoE.


---------------
Faudra que je teste un jour :o
n°53268
neo world
Posté le 13-10-2026 à 20:02:01  profilanswer
 

the_fennec a écrit :


Oui; c'est une des nouveautés de Qwen4, la lookup table qui fait 30GB et reste sur le disque. Faut quand même un SSD, mais ça cache les résolutions de tokens les plus communes.


Bah on attend quoi pour escalader à Q6 ? :o
 
Vers l’infini et au delà ! [:xtech93:2] comme dirait l’autre :D

n°53271
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 20:52:00  profilanswer
 

neo world a écrit :


Bah on attend quoi pour escalader à Q6 ? :o
 
Vers l’infini et au delà ! [:xtech93:2] comme dirait l’autre :D


Wut?


---------------
Faudra que je teste un jour :o
n°53273
neo world
Posté le 13-10-2026 à 21:25:12  profilanswer


Ben le Q4 est le sweet spot communément admis mais avec toute cette VRAM disponible soit faut augmenter leKV cache soit faut prendre le modele du dessus quand / si il est supporté.
 
La nature a horreur du vide :o

n°53280
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 23:33:13  profilanswer
 

neo world a écrit :


Ben le Q4 est le sweet spot communément admis mais avec toute cette VRAM disponible soit faut augmenter leKV cache soit faut prendre le modele du dessus quand / si il est supporté.
 
La nature a horreur du vide :o


C'est la que ça se passe :o
https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
 
Mais bon je trouve que Q2 ça marche déjà très bien :love:  
 
Il est bien avancé a faire le proxy Vulkan, il déploie tout seul sur la BC250, s'est fait un demon et fait des tests. Je sais pas trop ou il en est, mais ya du code :D


---------------
Faudra que je teste un jour :o
n°53281
neo world
Posté le 13-10-2026 à 23:36:38  profilanswer
 

Tout le monde n'a pas la chance de bosser avec llama cpp bare. Gufo ne supporte que la mouture Q4 K XL (ce qui est très bien. si il y en avait un seul à choisir c'était bien celui là). Après c'est des problèmes de riches mais j'ai un trou de 30GB de LPDDR5 ce qui doit faire 400€ qui se tourne les pouces. Inacceptable :o

n°53282
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 23:43:17  profilanswer
 

Il prends feu ton Strix si tu lance llama.cpp dessus? :o
 
Avec toute cette RAM libre tu peux nous tester ce nouveau MoE:
https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-GGUF
https://www.reddit.com/r/LocalLLaMA [...] m2524ba2b/


---------------
Faudra que je teste un jour :o
n°53283
neo world
Posté le 13-10-2026 à 23:50:54  profilanswer
 

the_fennec a écrit :

Il prends feu ton Strix si tu lance llama.cpp dessus? :o
 
Avec toute cette RAM libre tu peux nous tester ce nouveau MoE:
https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-GGUF
https://www.reddit.com/r/LocalLLaMA [...] m2524ba2b/


non justement c'est bien ça le problème : y'avait pas le feu avec llamacpp. Après plusieurs nuits de fine tuning j'en tirais environ 200 tokens / seconde en prefill avec un context de 250k vs 1400 avec Gufo dans les mêmes conditions et 17 à 25 tokens par seconde avec MTP alors que j'ai un 40+ bien stable avec Gufo.  :jap:  
 
Je télécharge ça sur le Mac déjà pour voir ce que ça donne  :jap:


Message édité par neo world le 13-10-2026 à 23:51:32
n°53284
neo world
Posté le 14-10-2026 à 00:08:15  profilanswer
 

très rapide :love:, parfait dans 48GB :love: mais :
contexte max deux fois plus petit que qwen
incapable de chercher correctement sur internet sans se mettre à boucler sans fin
 
J'ai pas fait de tuning pour l'empêcher de répéter mais ça commence mal quand je mets à préférer nemotron :o
 
peut être attendre quelques jours ? Y'a sans doute une merde quelque part potentiellement spécifique à la mouture MLX (j'ai jamais eu de problème avec MLX avant)
 
edit : ils se comparent à Qwen 3.6 (makes sense, c'était du MoU contrairement à 3.8 mais bref ...)
https://preview.redd.it/liquidai-lfm2-5-24b-a2b-v0-dkq58updp9vh1.png?width=2796&format=png&auto=webp&s=6cebdf251c3a4f3902dae1458069d76313bba41a

Message cité 1 fois
Message édité par neo world le 14-10-2026 à 00:12:56
n°53301
the_fennec
f3nn3cUs z3rd4
Posté le 14-10-2026 à 08:21:23  profilanswer
 

Les retours sur Reddit sont pas extraordinaires non plus, mais ya peut-être du tuning possible:

Code :
  1. --temp 0.1 --top-k 50 --repeat-penalty 1.05


Étrange une température si basse!
 
Mais bon, on a pas des nouveau MoE tous les jours.


---------------
Faudra que je teste un jour :o
n°53306
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 09:30:42  profilanswer
 

neo world a écrit :

très rapide :love:, parfait dans 48GB :love: mais :
contexte max deux fois plus petit que qwen
incapable de chercher correctement sur internet sans se mettre à boucler sans fin
 
J'ai pas fait de tuning pour l'empêcher de répéter mais ça commence mal quand je mets à préférer nemotron :o
 
peut être attendre quelques jours ? Y'a sans doute une merde quelque part potentiellement spécifique à la mouture MLX (j'ai jamais eu de problème avec MLX avant)
 
edit : ils se comparent à Qwen 3.6 (makes sense, c'était du MoU contrairement à 3.8 mais bref ...)
https://preview.redd.it/liquidai-lf [...] 6313bba41a


ornith :o
https://huggingface.co/peculiar-rag [...] .5-35B-A3B
https://huggingface.co/gbuzhf/Ornit [...] -APEX-GGUF
https://huggingface.co/pfeifferj/Or [...] Q-RCO-GGUF
https://huggingface.co/mudler/Ornit [...] -APEX-GGUF
 
j'ai le 1er sur le bc-250 (Q4_K_S), franchement, ça marche bien (je suis toujours surpris des résultats, mode thinking obligatoire par contre et il faut pas se tromper dans la température) :)

n°53307
the_fennec
f3nn3cUs z3rd4
Posté le 14-10-2026 à 09:35:03  profilanswer
 

Ornith c'est juste un fine-tune passable, pas un nouveau MoE.


---------------
Faudra que je teste un jour :o
n°53311
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 09:42:00  profilanswer
 

c'est exactement ça :)
mais qui va vite, léger et qui fait de bonne recherche, je le trouve impec' :o
j'avais un finetune 3.6 35B, à la 12ème version, il était encore moins bon.


sinon, y'a : https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3B
pas testé les CPM


edit: normal, pas de gguf :/


edit²: https://huggingface.co/Venastine-Re [...] B-A4B-GGUF mais rien vu passer la dessus :o


Message édité par moyen_moins le 14-10-2026 à 09:50:30
n°53314
Pipould's
Posté le 14-10-2026 à 09:52:50  profilanswer
 

Radiance et la 9700 c'est du petit lait...  
 
Avec Qwen Flash Next...
 
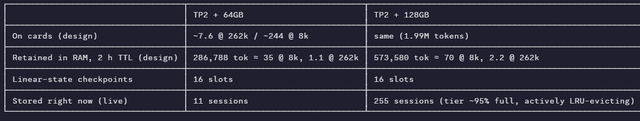
https://i.ibb.co/XZq4BYh8/image.png
 
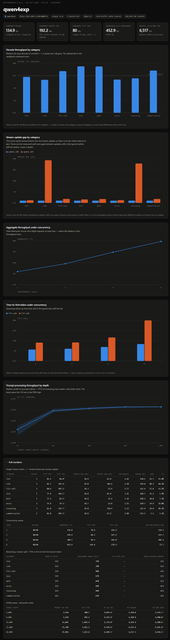
https://i.ibb.co/BV2mT7TL/image.png
 
Du coup maintenant j'ai 2 desktop un avec 64 ram 2 9700, un autre avec 128 ram 2 9700 aussi...  
 
L'ironie est qu'avec ca t'as de quoi servir une equipe de 15 dev....  
 
Le domaine avance beaucoup trop vite...

n°53319
speedboyz3​0
Guide Michelin :o
Posté le 14-10-2026 à 10:05:34  profilanswer
 

the_fennec a écrit :


Oui; c'est une des nouveautés de Qwen4, la lookup table qui fait 30GB et reste sur le disque. Faut quand même un SSD, mais ça cache les résolutions de tokens les plus communes.


Content d'avoir pris 1To de SSD avec 2x plus de bande passante que le 512Go du coup  :love:

 
Pipould's a écrit :

Du coup maintenant j'ai 2 desktop un avec 64 ram 2 9700, un autre avec 128 ram 2 9700 aussi...


L'ironie est qu'avec ca t'as de quoi servir une equipe de 15 dev....


Le domaine avance beaucoup trop vite...


[:la chancla:1]  [:moonbloood:2]  [:sire de botcor:1]


Solide comême  [:moonbloood:2]


Vous faites tout en local ?


T'as encore besoin de 15 dev ?  [:speedboyz30:5]  [:speedboyz30:5]  [:speedboyz30:5]

Message cité 1 fois
Message édité par speedboyz30 le 14-10-2026 à 10:11:11
n°53334
hardcorsai​re
Posté le 14-10-2026 à 10:49:44  profilanswer
 

Pipould's a écrit :

Du coup maintenant j'ai 2 desktop un avec 64 ram 2 9700, un autre avec 128 ram 2 9700 aussi...


Pour quel montant investit ?

n°53338
the_fennec
f3nn3cUs z3rd4
Posté le 14-10-2026 à 11:07:33  profilanswer
 

L'équipe de llama.cpp sort un GUI pour Windows:
https://github.com/ggml-org/Llama-Windows
 

Citation :


Local LLMs, one click away — right from your Windows system tray.
 
Llama is a Windows 11 tray app for running llama.cpp models locally. It's a WinUI 3 port of Llama for Mac.
 
Highlights

  • Lives in your tray — a borderless, Mica-backed flyout anchored to the tray icon
  • Zero-setup llama.cpp — uses your existing llama.exe, or downloads one for you
  • One-click models — browse and download recommended models from the Hugging Face Hub
  • Model details — click any model for a context-length picker with per-option memory estimates (read from the GGUF header), remembered per model, plus chat, copy-model-ID, curl-request, and Hugging Face actions
  • Standard storage — models live in the Hugging Face cache, shared with llama.cpp and other tools
  • Spotlight-like overlay — press Alt+Space from any app to chat with your loaded model


Il y en avait donc un pour Mac aussi:
https://github.com/ggml-org/Llama-macOS
 
Bon, ceux la je testerais pas :o
 
src: https://www.clubic.com/actualite-63 [...] ndows.html


Message édité par the_fennec le 14-10-2026 à 11:08:07

---------------
Faudra que je teste un jour :o
n°53339
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 11:25:01  profilanswer
 

si on peut faire mumuse avec la répartition des layers entre les GPUs :o

n°53341
neo world
Posté le 14-10-2026 à 11:33:11  profilanswer
 

Sur Mac je reste sur lm studio : il s'occupe aussi de choper les nouvelles version du moteur MLX :D
 
Sinon Gufo toujours très bon. J'ai activé le cache persistant en disque (200GO + la RAM dispo histoire d'avoir de pouvoir mettre en cache environ 10M de tokens soit une cinquantaine de sessions en parallèle) ça restore plutôt vite : 400ms depuis le NVMe vs 50ms depuis la ram pour une session de 70K tokens. en tok generation je suis toujours entre 42 et 48 tokens / seconde.
 
 je continué mes essais de Qwen 3.8 flash next Hui v2 sans detecter d'hallucinations ni de bugs donc il va passer en daily driver :-)

n°53343
neo world
Posté le 14-10-2026 à 11:38:36  profilanswer
 

Pipould's a écrit :


L'ironie est qu'avec ca t'as de quoi servir une equipe de 15 dev....  
 
Le domaine avance beaucoup trop vite...


On postule comment pour rejoindre ton équipe ?  [:darksamus] :D
 
Mais sinon je confirme ça évolue vite et ça prend la direction que j’espérais à la création du topic : beaucoup d'optimisations des modèles / moteur d'inférence pour squeezer du token / seconde en pagaille. Je pense que ça continueras dans cette voie encore jusqu'en 2028 si pas de grosse crise financière (difficile à prédire : les progrès depuis quelques mois pour les modèles frontier et open weights sont juste phénoménaux. On a pas fini de balancer du pognon dans la marmite  [:catalonix:10] )

n°53349
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 12:22:59  profilanswer
 

j'ai updaté Strata, j'ai doublé mon prefill sur la 9700pro. [:mouais]
et le decode a progressé aussi :)


edit: punaise ce con a basculé sur la 9070XT et le pcie 4.0 16X :fou:

Message cité 2 fois
Message édité par moyen_moins le 14-10-2026 à 12:31:20
n°53351
neo world
Posté le 14-10-2026 à 12:40:49  profilanswer
 

moyen_moins a écrit :

j'ai updaté Strata, j'ai doublé mon prefill sur la 9700pro. [:mouais]
et le decode a progressé aussi :)
 
edit: punaise ce con a basculé sur la 9070XT et le pcie 4.0 16X :fou:


ben il a amélioré tes perfs. Tu voulais quoi ? :o
 
Surveille tes colis, je crois qu'il t'a commandé une RTX5090 pour le prochain performance gap que tu lui as demandé :o


Message édité par neo world le 14-10-2026 à 13:05:40
n°53353
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 12:42:54  profilanswer
 

j'ai surtout trouvé une X570 dans mon coin :o

n°53355
Pipould's
Posté le 14-10-2026 à 13:14:55  profilanswer
 

speedboyz30 a écrit :


Content d'avoir pris 1To de SSD avec 2x plus de bande passante que le 512Go du coup  :love:  


speedboyz30 a écrit :


 [:la chancla:1]  [:moonbloood:2]  [:sire de botcor:1]  
 
Solide comême  [:moonbloood:2]  
 
Vous faites tout en local ?
 
T'as encore besoin de 15 dev ?  [:speedboyz30:5]  [:speedboyz30:5]  [:speedboyz30:5]  


Je fais tout en local, c'est pour moi  :lol:  
 
Au debut je voulais 64 GB de vram, du coup j'ai pris 2 9700, puis je voulais de la vitesse, du coup j'en ai pris 2 autres.  
 
Sauf qu'entre temps les performances de radiance ont explosees.
 
Le temps que je monte les 2 configurations... Je pourrais en vendre une sans soucis.

n°53356
Pipould's
Posté le 14-10-2026 à 13:16:33  profilanswer
 

hardcorsaire a écrit :


Pour quel montant investit ?


6800 balles de CG, plus le reste, 8K au pifometre ? Mais apres ca reste des 9700, donc je peux jouer sur une on va dire  :o  
 
Mais oui c'est temporaire, on va dire que c'est une representation reelle de mon livret A  :lol:

n°53357
neo world
Posté le 14-10-2026 à 13:17:20  profilanswer
 

Pipould's a écrit :


Je fais tout en local, c'est pour moi  :lol:  
 
Au debut je voulais 64 GB de vram, du coup j'ai pris 2 9700, puis je voulais de la vitesse, du coup j'en ai pris 2 autres.  
 
Sauf qu'entre temps les performances de radiance ont explosees.
 
Le temps que je monte les 2 configurations... Je pourrais en vendre une sans soucis.


garde là et comande un cable USB4 / thunderbolt (selon ce qui est dispo sur la machine) pour le clusteriser les deux machines [:perco_35:2]  
 
et revend la seconde dans un an quand elle aura tellement pris qu'elle te rembourse l'achat de l'autre machine :o

n°53358
Pipould's
Posté le 14-10-2026 à 13:18:47  profilanswer
 

neo world a écrit :


On postule comment pour rejoindre ton équipe ?  [:darksamus] :D


Ca s'auto-gere par agent  :lol: Apres le souci c'est que je peux pas gerer plus gros que du qfn / glm flash....

n°53359
Pipould's
Posté le 14-10-2026 à 13:19:13  profilanswer
 

moyen_moins a écrit :

j'ai updaté Strata, j'ai doublé mon prefill sur la 9700pro. [:mouais]
et le decode a progressé aussi :)
 
edit: punaise ce con a basculé sur la 9070XT et le pcie 4.0 16X :fou:


Passes sur radiance, il y a eu des ameliorations pour le tp1.

n°53360
Pipould's
Posté le 14-10-2026 à 13:20:13  profilanswer
 

neo world a écrit :


garde là et comande un cable USB4 / thunderbolt (selon ce qui est dispo sur la machine) pour le clusteriser les deux machines [:perco_35:2]  
 
et revend la seconde dans un an quand elle aura tellement pris qu'elle te rembourse l'achat de l'autre machine :o


Tu penses que c'est possible de les clusteriser facilement par USB ? bonne question... Je n'ai que des ports 10G par contre.  
 
Et radiance ne supporte pas le "rpc" :-(

n°53368
moyen_moin​s
chat réincarné
Posté le 14-10-2026 à 13:57:52  profilanswer
 

Pipould's a écrit :


Passes sur radiance, il y a eu des ameliorations pour le tp1.


j'essaie de migrer sous linux ce weekend.

n°53369
hardcorsai​re
Posté le 14-10-2026 à 14:01:16  profilanswer
 

Pipould's a écrit :

plus le reste, 8K au pifometre ?


8k€ ça représente 6 à 7 ans ~ d'un abo claude max 5x au tarif actuel
 
C'est pas plus intéressant que d'investir 8k€ dans du matos qui sera totalement déprécié d'ici 1 and et ½ ?  [:bakk5]  
 

 Page :   1  2  3  4  5  ..  83  84  85  86  87  88  89  90

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)