Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3459 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  85  86  87  88  89  90
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°53939
moyen_moin​s
chat réincarné
Posté le 18-10-2026 à 10:50:42  profilanswer
 

Reprise du message précédent :
c'est quoi encore tous ces gpus :o
c'est sûr qu'à côté ma config... :whistle:

n°53943
alanou
Remembering M.P.
Posté le 18-10-2026 à 11:38:20  profilanswer
 

Config 2 x 3090 partie ce matin même... une demi journée pour la vente.


Bref !


Oh et puis la news de ce matin à 3h sur le Discord cmpunlocker... une partie de la logique de déblocage des CMP est applicable aux 3090, donc quelqu'un a réussi à doubler la puissance en BF16/FP16 pour la rendre similaire aux A6000 / A40 avec le même die... ca va pas faire du bien au marché ca encore...
https://flopper.io/compare?s=nvidia [...] -3090-24gb

Message cité 1 fois
Message édité par alanou le 18-10-2026 à 11:59:13

---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°53953
moyen_moin​s
chat réincarné
Posté le 18-10-2026 à 13:18:08  profilanswer
 

ah ça... faudrait qu'il trouve les mêmes trucs pour les gpu amd :o

n°53957
neo world
Posté le 18-10-2026 à 13:56:37  profilanswer
 

J'ai fait X3 en PP et X2 TG depuis la sortie de Qwen 3.8 flash next grâce aux optis de RocM avec les nouveaux moteurs d'inférence mieux pensés. Ca peut encore monter à 2500 tokens / secondes en PP en sacrifiant un peu la qualité (iq3) et en utilisant le NPU en parallèle :pt1cable:
 

n°53972
moyen_moin​s
chat réincarné
Posté le 18-10-2026 à 15:07:21  profilanswer
 

j'avoue, c'est assez impressionnant l'évolution des perfo des strix halo ces dernières semaines.
c'est passé de pas ouf à sexy :D

n°53977
speedboyz3​0
Guide Michelin :o
Posté le 18-10-2026 à 16:50:21  profilanswer
 

C'est les perfs partout qui explosent, mais oui top pour le Strix Halo qui étaient un peu lent.

n°53996
neo world
Posté le 18-10-2026 à 20:13:56  profilanswer
 

et on a pas encore vu ce qu'allait vraiment donner Qwen 4 et les autres labs qui vont lui emboiter le pas :D
 
2025 a été une super année pour acheter du hardware (spoiler alert : j'ai rien acheté :o ) et 2026 est un très bon cru pour l'inférence à la maison.
 
2027 sera l'année des agents partout à la maison et au travail ou ne sera pas :o
 
et 2028 le grand crash  [:ticento:6]


Message édité par neo world le 18-10-2026 à 20:14:27
n°53997
neo world
Posté le 18-10-2026 à 22:20:47  profilanswer
 

si vous n'arrivez pas à mettre la main sur un bc250 vous pouvez aussi taper à la source ... :o
 
https://github.com/cobanov/PS5LM/raw/main/docs/media/ps5lm-home.gif
 
https://github.com/cobanov/PS5LM  :pt1cable:

n°53999
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 08:55:34  profilanswer
 

moyen_moins a écrit :

j'ai remarqué qu'avec strata et le modèle iq3_s gsq rco, il y avait quand même beaucoup de "tool calling" ratés. :/
je vois que le iq4_xs d'unsloth apporte pas forcément plus sur les métriques mais est peut être plus consistant sur les tool calls ? [:paysan]


Aucuns tool-calls foiré avec Q2 et Claude, ou je les vois pas et il se rattrape ensuite.


---------------
Faudra que je teste un jour :o
n°54000
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 08:56:56  profilanswer
 

moyen_moins a écrit :

je suis sur opencode v2
j'ai pris mes habitudes là dessus :)
 
bon, il a au moins réussi à faire marcher le monitor de strata qui ne fonctionne comme il faut que sous linux.  
à part la charge du bus pcie, j'ai tout maintenant sous windows :)


Ça me donne pas envie de repasser sur Opencode alors :o c'était déjà un problème que j'avais avec avant.


---------------
Faudra que je teste un jour :o
n°54001
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 08:59:07  profilanswer
 

alanou a écrit :

Config 2 x 3090 partie ce matin même... une demi journée pour la vente.
 
Bref !
 
Oh et puis la news de ce matin à 3h sur le Discord cmpunlocker... une partie de la logique de déblocage des CMP est applicable aux 3090, donc quelqu'un a réussi à doubler la puissance en BF16/FP16 pour la rendre similaire aux A6000 / A40 avec le même die... ca va pas faire du bien au marché ca encore...
https://flopper.io/compare?s=nvidia [...] -3090-24gb


Wow énorme ça!
Ils vont finir par complètement débloquer les CG :lol:
Je voudrais bien un bus 256bit sur ma 4060... (sans soudures :o)
 

neo world a écrit :

si vous n'arrivez pas à mettre la main sur un bc250 vous pouvez aussi taper à la source ... :o
 
https://github.com/cobanov/PS5LM/ra [...] m-home.gif
 
https://github.com/cobanov/PS5LM  :pt1cable:


J'ai vu passer ça :lol:
 
Sinon dans les trucs alacon, ya KytyPS5 qui tourne sur PS5 aussi!


Message édité par the_fennec le 19-10-2026 à 09:02:12

---------------
Faudra que je teste un jour :o
n°54003
moyen_moin​s
chat réincarné
Posté le 19-10-2026 à 10:09:07  profilanswer
 

the_fennec a écrit :


Ça me donne pas envie de repasser sur Opencode alors :o c'était déjà un problème que j'avais avec avant.


il se rattrape mais en "1er jet", ça lui arrive souvent d'en rater.
genre avec le mcp home assistant.
 
sinon, j'avais une question surement très con mais bon : est ce qu'on peut avoir des agents sur d'autres machines que la machine qui fait tourner le modèle principal ?
peut être que c'est idiot mais ça pourrait faire des requetes en parallèle sur des machines plus petites qui font tourner un modèle plus petit mais qui suffisent largement.
j'sais pas si je suis clair [:transparency]

n°54005
neo world
Posté le 19-10-2026 à 10:21:41  profilanswer
 

moyen_moins a écrit :


il se rattrape mais en "1er jet", ça lui arrive souvent d'en rater.
genre avec le mcp home assistant.
 
sinon, j'avais une question surement très con mais bon : est ce qu'on peut avoir des agents sur d'autres machines que la machine qui fait tourner le modèle principal ?
peut être que c'est idiot mais ça pourrait faire des requetes en parallèle sur des machines plus petites qui font tourner un modèle plus petit mais qui suffisent largement.
j'sais pas si je suis clair [:transparency]


C'est exactement comme ça que je fais : j'ai Gufo sur le strix halo derrière un reverse proxy caddy qui gère l'authentification et les certificats https avec let's encrypt et mon domaine DNS (OVH). Mes agents sont dans des VMs sur le même réseau. Tout passe dans une API qui imite openAI (mais tu as d'autres modèles). Demande à ton IA de t'aider à le mettre en place. ça prend une grosse demi heure. 45 minutes avec la partie TLS :jap:

n°54008
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 10:45:12  profilanswer
 

moyen_moins a écrit :


il se rattrape mais en "1er jet", ça lui arrive souvent d'en rater.
genre avec le mcp home assistant.
 
sinon, j'avais une question surement très con mais bon : est ce qu'on peut avoir des agents sur d'autres machines que la machine qui fait tourner le modèle principal ?
peut être que c'est idiot mais ça pourrait faire des requetes en parallèle sur des machines plus petites qui font tourner un modèle plus petit mais qui suffisent largement.
j'sais pas si je suis clair [:transparency]


J'ai pas remarqué de soucis avec Claude, ça doit être un problème Open-code :o
 
Oui, mon moteur tourne toujours sur une autre machine, une Debian dédiée maintenant sans UI comme ça toute la VRAM est libre. J'ai pas un setup compliqué comme neo world, juste http://<host>:8080 au lieu de 127.0.0.1.


---------------
Faudra que je teste un jour :o
n°54011
neo world
Posté le 19-10-2026 à 10:58:04  profilanswer
 

the_fennec a écrit :


J'ai pas remarqué de soucis avec Claude, ça doit être un problème Open-code :o
 
Oui, mon moteur tourne toujours sur une autre machine, une Debian dédiée maintenant sans UI comme ça toute la VRAM est libre. J'ai pas un setup compliqué comme neo world, juste http://<host>:8080 au lieu de 127.0.0.1.


compliqué ... le fichier de config caddy fait 20 lignes. J'en ait écrit aucune moi même  :lol:

n°54016
moyen_moin​s
chat réincarné
Posté le 19-10-2026 à 11:25:31  profilanswer
 

je voulais dire genre le modèle principal délègue des tâches à d'autres modèles sur d'autres machines histoire de gagner du temps sur les trucs qui demandent pas forcément des centaines de milliards de paramètres quoi :o

n°54017
neo world
Posté le 19-10-2026 à 11:31:42  profilanswer
 

oui chez moi ça tape le même modèle avec les sessions concurentes et une queue d'attente au pire si je dépasse la capa de mon serveur.
 
mais tu peux aussi avoir un plus petit modèle si tu veux gagner en vitesse en lachant un peu la qualité. Faut faire des essais et voir ce qui passe bien sur ton infra et reste utile pour ton besoin (genre un bonsai ou autre modèle optimisé mais les tests que j'ai fait n'étaient pas très concluants)

n°54020
speedboyz3​0
Guide Michelin :o
Posté le 19-10-2026 à 12:11:58  profilanswer
 

Lequel d'entre vous a piqué les 2 palettes de RTX 5090 au Brésil ?  [:gordon shumway]  
 
https://videocardz.com/newz/two-pal [...] an-airport


Message édité par speedboyz30 le 19-10-2026 à 12:12:16
n°54021
neo world
Posté le 19-10-2026 à 12:14:36  profilanswer
 

https://external-content.duckduckgo.com/iu/?u=https%3A%2F%2Fmedia.tenor.co%2Fimages%2Fd63d1d3a02249e0d09546cc54bc413e8%2Fraw&f=1&nofb=1&ipt=c0433445f439c039ad04450f2dc2c06b30e3933791620dd64c66aa73eaeb44e8&ipo=images

n°54025
Pipould's
Posté le 19-10-2026 à 13:35:49  profilanswer
 

neo world a écrit :

nouveau joueur entre dans l'arène du strix halo :
 
https://github.com/warpfront/hipfir [...] o-dark.png
 
https://preview.redd.it/hipfire-0-4 [...] c1e0469d0e
 
https://preview.redd.it/hipfire-0-4 [...] fec9806580
 
Y'a une hype pour rust qui a l'air payante (en plus de faire appel au NPU ici). Pour ceux qui hésitaient pour l'achat d'un strix halo (128GB recommandé) sans avoir le budget pour prendre un GB10 / Mac M5/6 je pense que c'est votre machine / modele / engine d'agentique. Les prix vont probablement stagner jusqu'au black friday (je ne m'attends pas à de grosses reducs cette année malheureusement) puis probablement repartir à la hausse en mode YOLO si les modèles Qwen 4 arrivent à ce type de vitesse (l'archi sera similaire à 3.8 flash next)
 
pour ceux qui se posent la question de la machine 64GB :
 

Citation :

27B is supported: `hipfire pull qwen3.8:27b-mq4-xts` is about 15 GB, so it fits a 32 GB machine with room for context, and it runs with dflash speculative decoding. the NPU prefill route is Flash-Next only for now, so 27B prefill runs on the iGPU alone. I am working on Q3 and Q2 quants of Flash-Next as well, 48 gb of memory (vram+ram) I think may be the absolute floor for flash next.


Est-ce que t'as reussi a trouver des tests de qualite vs halogen et autre ?  

n°54026
Pipould's
Posté le 19-10-2026 à 14:11:58  profilanswer
 

alanou a écrit :

Bon voilà, ma machine avec le 3 x Radeon V620 est vendue et partie à son nouveau propriétaire.
 
J'ai mis mon autre Lenovo P620 avec ces 2 x RTX 3090 en annonce sur leboncoin et en moins de 5 minutes j'ai eu deux offres presque intéressantes... C'est pas tout à fait le même attrait.
 
Pour vous donner un ordre d'idée, sur la machine à 3xV620 j'avais tout de même une 60 aine de contacts, et entre 12 ou 15 offres (dont 10 "sérieuses" à plus de 3000€).
 
https://img3.super-h.fr/images/2026 [...] 373171.jpg
 
Si ça intéresse du monde ici, hésitez pas
 
Money shot HFR en bonus  
https://img3.super-h.fr/images/2026 [...] 045004.jpg


Polalala.... les CMP170 c'est celles que t'avais postees avant ?

n°54027
Pipould's
Posté le 19-10-2026 à 14:12:59  profilanswer
 

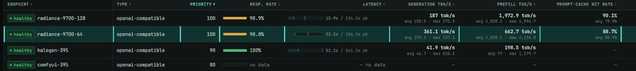
De mon cote ca cruise plutot bien ce matin:
https://i.ibb.co/MDfrx8gk/image.png
 
Le souci c'est que je bosse sur 6 projets en //...

n°54031
Pipould's
Posté le 19-10-2026 à 14:31:47  profilanswer
 

neo world a écrit :

Bon bah j'ai ma roadmap pour Q4 2026. J'espère que N8n est vraiment bien :D :
https://rehost.diberie.com/Picture/Get/f/562473
 
https://rehost.diberie.com/Picture/Get/f/562474
 
Pour ce weekend je fais la partie détection d'attaque / prompt injection / evasion sur la gateway devant le strix halo pour pas être à pwal au premier site qui demande à mon IA de démarrer une usine d'avis frauduleux sur internet au détour d'une question sur la meteo demain :o


N8N c'est pas ouf ouf pour moi...

n°54034
chris282
id steam/psn : chris282_fr
Posté le 19-10-2026 à 14:48:26  profilanswer
 

chris282 a écrit :

auriez vous quelques minutes pour faire une critique constructive de mon dashboard (je n'avais qu'un dashboard moyennement satisfaisant, et j'avais envie d'avoir quelque chose d'aussi bien que ce vous m'avez montré - je l'ai construit avec grok)
 
https://rehost.diberie.com/Picture/Get/t/562424


the_fennec a écrit :


Tes unités sont pas bonnes ou manquantes
Un peu bizarre de mélanger anglais et français
La casse des titres n'est pas consistante, soit norme US avec première lettres en majuscule (Dernière Vitesse Prompt), soir FR avec seulement la première (Dernière vitesse prompt)
Tes échelles de vitesses devraient commencer a 0
Dark mode c'est le mal :o


neo world a écrit :


moi ça me semble bien J'ai été assez loin dans mon dashboard avec trois volets :
1 chat => valide la prise en charge par le modèle d'images, PDFs et me permet de tester les requetes dangereuses / absurdes (reproduire les conditions du big bang à échelle 1 ou reconstruire à la maison une tsar bomba classiquement) sans qu'il fasse des requêtes cheloues au kremlin pour trouver des plans ou demande de l'anti matière à un chercheur du CERN dans le process :o
 
2 le dashboard que j'ai montré et un peu amélioré (compteur d’énergie totale consommée y compris en veille, état de santé des caches, logs d'erreurs de Gufo, extrait des réponses aux 20 dernières requetes (derrière un password et évidement le tout en https) pour pouvoir débuguer un problème, vérifier que tout va bien quand je veux
 
3 un dashboard sur les dernières versions de Gufo avec un extrait des changelogs entre ma version installée et la dernière résumée par mon IA locale chaque jour. Pareil avec Rocm. La version du kernel linux installé, les paramètres de démarrage et la ligne de commande de Gufo (pour vérifier en deux secondes si y'a pas un paramètre à optimiser / faire des diffs en un coup d'oeil avec ce que je trouve sur reddit ou dans les blogs sans faire de ssh
 
https://rehost.diberie.com/Picture/Get/f/562440
https://rehost.diberie.com/Picture/Get/f/562441
https://rehost.diberie.com/Picture/Get/f/562442
 
p'tit focus sur la partie troubleshot des outputs :
https://rehost.diberie.com/Picture/Get/f/562443
 
Ce rêve de faire des bidouilles en 2026  [:mapix:1]


sur la base de vos retour, j'ai fait une vingtaine d'itérations avant d'obtenir quelque chose qui me convienne  
 
voici le résultat. je pense que l'on voit bien le avant / après
https://rehost.diberie.com/Picture/Get/t/563300
 
il est possible qu'il y ai encore des choses a améliorer, cela viendra plus tard.

n°54035
Pipould's
Posté le 19-10-2026 à 14:49:51  profilanswer
 

chris282 a écrit :


sur la base de vos retour, j'ai fait une vingtaine d'itérations avant d'obtenir quelque chose qui me convienne  
 
voici le résultat. je pense que l'on voit bien le avant / après
https://rehost.diberie.com/Picture/Get/t/563300
 
il est possible qu'il y ai encore des choses a améliorer, cela viendra plus tard.


Faut que je fasse la meme chose... t'aurais un guidelines.md a partage histoire que je crame pas trop de tokens ?  
 
Merci

n°54036
moyen_moin​s
chat réincarné
Posté le 19-10-2026 à 15:02:17  profilanswer
 

Pipould's a écrit :

De mon cote ca cruise plutot bien ce matin:
https://i.ibb.co/MDfrx8gk/image.png
 
Le souci c'est que je bosse sur 6 projets en //...


quand même :D
falsh next ? quel quant ?
 
j'utilise le gsq rco classique (iq3_s), pas le coder. je trouve que les interfaces qu'il développe se ressemblent toutes et sont ternes et pas super inspirées :/

n°54038
neo world
Posté le 19-10-2026 à 15:30:58  profilanswer
 

Pipould's a écrit :


N8N c'est pas ouf ouf pour moi...


tu gères comment l'orchestration et la gestion des ACL selon les tâches ?  
 
Un agent à tout ?  [:setlel]  
 
/vrai question j'ai pas encore mis en place :D

n°54039
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 15:50:54  profilanswer
 

Petite expérience du WE.  
 
J'ai laissé Strata/QFN_Q2 tourner sur le dernier problème "fonctionnel" de mon "montage de GPU distant".
Il a pas trop avancé, il boucle a tester des trucs différent mais semble tourner un peu en rond...
 
Je passe a llama.cpp/Qwen3.8-27B-GSQ-RCO-IQ3_XXS et 2h de taf il a trouvé et réglé le problème!
Bon c'est peut être juste le fait d'utiliser un autre modèle qui donne de nouvelles pistes.
 
Je vais remettre Strata au boulot, il est quand même beaucoup plus rapide.
Il reste "un peu" d'optimisation a faire :o
https://i.imgur.com/kltQDTC.png


---------------
Faudra que je teste un jour :o
n°54040
neo world
Posté le 19-10-2026 à 16:01:34  profilanswer
 

Pipould's a écrit :


Est-ce que t'as reussi a trouver des tests de qualite vs halogen et autre ?  


J'en ai pas cherché et j'ai pas déployé : j'ai une version hui de flash next qui me convient bien pour l'instant (mais qui accepte toutes les requêtes donc faut que je le blinde avant de me retrouver avec le FBI / FSB à la maison à cause d'un prompt injection après lui avoir demandé l'heure :whistle: )
 
Je reste sur Gufo qui me va très bien pour l'instant :jap:

n°54041
moyen_moin​s
chat réincarné
Posté le 19-10-2026 à 16:17:23  profilanswer
 

the_fennec a écrit :

Petite expérience du WE.


J'ai laissé Strata/QFN_Q2 tourner sur le dernier problème "fonctionnel" de mon "montage de GPU distant".
Il a pas trop avancé, il boucle a tester des trucs différent mais semble tourner un peu en rond...


Je passe a llama.cpp/Qwen3.8-27B-GSQ-RCO-IQ3_XXS et 2h de taf il a trouvé et réglé le problème!
Bon c'est peut être juste le fait d'utiliser un autre modèle qui donne de nouvelles pistes.


Je vais remettre Strata au boulot, il est quand même beaucoup plus rapide.
Il reste "un peu" d'optimisation a faire :o
https://i.imgur.com/kltQDTC.png


C'est intéressant. :jap:
Je me demandais ce weekend si descendre trop bas en quant sur le flash next ne le lobotimisait pas de trop et qu'un q4 sur un 27B était pas aussi voire plus performant (pas en t/s mais sur la qualité de la sortie).
Le 27B est lent globalement mais en xhigh ça sort vraiment des trucs quali.


C'est pour ça que je parlais de tâches confiées à d'autres modèles ce matin  :whistle:

n°54044
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 17:10:06  profilanswer
 

moyen_moins a écrit :


C'est intéressant. :jap:  
Je me demandais ce weekend si descendre trop bas en quant sur le flash next ne le lobotimisait pas de trop et qu'un q4 sur un 27B était pas aussi voire plus performant (pas en t/s mais sur la qualité de la sortie).
Le 27B est lent globalement mais en xhigh ça sort vraiment des trucs quali.
 
C'est pour ça que je parlais de tâches confiées à d'autres modèles ce matin  :whistle:


Jusqu'à présent je déclarait un modèle débile et inutilisable soit avec des tool-calls foireux, des boucles ou quand il faisait pas du tout ce que je lui demandais. J'ai pas eu ces soucis avec Q2. Mais pour ce projet, je l'ai un peu lancé a l'aventure, ne sachant pas si ce que je lui demandais était possible :D
 
La j'ai remis Q2 et me dit que le bug est toujours la, mais c'est possible qu'il l'ait remis.


---------------
Faudra que je teste un jour :o
n°54047
chris282
id steam/psn : chris282_fr
Posté le 19-10-2026 à 17:32:28  profilanswer
 

Pipould's a écrit :


Faut que je fasse la meme chose... t'aurais un guidelines.md a partage histoire que je crame pas trop de tokens ?


Merci


désolé je ne sais pas encore faire de cadrage d'ia a base de guidelines.md ou de claude.md (c'est dans ma todo list), j'ai fais avec les moyens du bord en faisant des aller retour de prompts (a la base je suis partit d'un dashboard opensource completement retravaillé, ça par contre je peux te donner le lien : https://grafana.com/grafana/dashboa [...] onitoring/ )


Message édité par chris282 le 19-10-2026 à 17:32:42
n°54050
tfpsly
Sly
Posté le 19-10-2026 à 18:36:18  profilanswer
 

the_fennec a écrit :

Petite expérience du WE.


J'ai laissé Strata/QFN_Q2 tourner sur le dernier problème "fonctionnel" de mon "montage de GPU distant".
Il a pas trop avancé, il boucle a tester des trucs différent mais semble tourner un peu en rond...


Je passe a llama.cpp/Qwen3.8-27B-GSQ-RCO-IQ3_XXS et 2h de taf il a trouvé et réglé le problème!
Bon c'est peut être juste le fait d'utiliser un autre modèle qui donne de nouvelles pistes.


Pareil : parfois Q27B va trouver directement le bug. Mais Q125B reste plus rapide en général, surtout pour développer de nouvelles features ou refactorer.


Le pire est quand la sortie d'un outil ne tient pas dans le contexte; 125B ne s'en rend pas compte et boucle dessus; un coup de 27B et il se rend compte du problème, par exemple coupe une partie des logs, et répare le pb.


J'ai fini par baisser le budget reasonning de 125B à 512 au lieu de 1024, il a l'air de perdre moins de temps et de ne plus re-re-re-vérifier ses hypothèses et décisions.

Message cité 1 fois
Message édité par tfpsly le 19-10-2026 à 18:38:21
n°54057
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 20:27:39  profilanswer
 

tfpsly a écrit :


Pareil : parfois Q27B va trouver directement le bug. Mais Q125B reste plus rapide en général, surtout pour développer de nouvelles features ou refactorer.
 
Le pire est quand la sortie d'un outil ne tient pas dans le contexte; 125B ne s'en rend pas compte et boucle dessus; un coup de 27B et il se rend compte du problème, par exemple coupe une partie des logs, et répare le pb.
 
J'ai fini par baisser le budget reasonning de 125B à 512 au lieu de 1024, il a l'air de perdre moins de temps et de ne plus re-re-re-vérifier ses hypothèses et décisions.


J'ai pas de soucis de reasoning; j'ai tout laissé par défaut. Pas de problème pour les outils non plus.
J'ai mis 200k de contexte, mais configuré 150k coté claude, par contre Strata se débrouille pas bien pour la gestion, la ou j'ai pas eu de soucis avec llama.cpp.
 
Sinon j'ai testé le support de 35B avec Strata, c'est bof bof, il vaut tout charger en VRAM, KV en bf16 seulement et peu de quants au choix, aucun intérêt.


---------------
Faudra que je teste un jour :o
n°54061
the_fennec
f3nn3cUs z3rd4
Posté le 19-10-2026 à 20:49:00  profilanswer
 

Nouvelle version de Qwen3.8-Flash-Next Coder
https://huggingface.co/ISTA-DASLab/ [...] Coder-GGUF
 

Citation :

We’ve updated the model following the community’s feedback. To get the update, you only need to redownload the first GGUF shard. The second shard is unchanged.
 
We focused on making generation more reliable. Previously, the model could get stuck in repetitive loops or stop before delivering the requested result. In our latest tests, we haven’t encountered either issue. These were limited tests, so we cannot guarantee that either behavior will never occur. Still, the results are encouraging and suggest that both are now less likely. Reports of remaining failure cases would be especially helpful.
 
We’ve also seen substantial improvements in vision capabilities. Below are two games we built with the updated model to show some of what it can do.
 
What changed
 
This update changes which experts are retained. No retained weights were modified relative to the base IQ3_S model. About 25% of the retained expert selection differs from the previous release.
 
The model remains English-only. With a limited expert budget, we prioritized preserving English capabilities so unfortunately, multilingual capabilities were not preserved.
 
Benchmark results
 
SWE-bench Verified accuracy increased from 75.8% to 79.2%, an improvement of 3.4 percentage points in agentic coding compared to 82.8% for the base model. LiveCodeBench v6 accuracy remains essentially unchanged within statistical variation.


---------------
Faudra que je teste un jour :o
n°54065
Pipould's
Posté le 19-10-2026 à 22:30:22  profilanswer
 

moyen_moins a écrit :


quand même :D
falsh next ? quel quant ?
 
j'utilise le gsq rco classique (iq3_s), pas le coder. je trouve que les interfaces qu'il développe se ressemblent toutes et sont ternes et pas super inspirées :/


qwen4exp-swift15-w4dn8-i8-hc8m.rad
 
Radiance

n°54066
Pipould's
Posté le 19-10-2026 à 22:31:48  profilanswer
 

neo world a écrit :


tu gères comment l'orchestration et la gestion des ACL selon les tâches ?  
 
Un agent à tout ?  [:setlel]  
 
/vrai question j'ai pas encore mis en place :D


Bah je commence a gratter le sujet, idealement variable d'environment que les agents utilisent eux. sinon j'ai un agent par sujet, je leur demande de documenter leur tache et la session d'apres continue...

n°54069
the_fennec
f3nn3cUs z3rd4
Posté le 20-10-2026 à 08:44:09  profilanswer
 

A priori il il faut pas passer sur Strata 2:
https://www.reddit.com/r/LocalLLaMA [...] g_changes/
 
Pas mal de régressions en plus d'imposer une app desktop :/


---------------
Faudra que je teste un jour :o
n°54086
moyen_moin​s
chat réincarné
Posté le 20-10-2026 à 09:58:24  profilanswer
 

the_fennec a écrit :

Nouvelle version de Qwen3.8-Flash-Next Coder
https://huggingface.co/ISTA-DASLab/ [...] Coder-GGUF
 

Citation :

We’ve updated the model following the community’s feedback. To get the update, you only need to redownload the first GGUF shard. The second shard is unchanged.
 
We focused on making generation more reliable. Previously, the model could get stuck in repetitive loops or stop before delivering the requested result. In our latest tests, we haven’t encountered either issue. These were limited tests, so we cannot guarantee that either behavior will never occur. Still, the results are encouraging and suggest that both are now less likely. Reports of remaining failure cases would be especially helpful.
 
We’ve also seen substantial improvements in vision capabilities. Below are two games we built with the updated model to show some of what it can do.
 
What changed
 
This update changes which experts are retained. No retained weights were modified relative to the base IQ3_S model. About 25% of the retained expert selection differs from the previous release.
 
The model remains English-only. With a limited expert budget, we prioritized preserving English capabilities so unfortunately, multilingual capabilities were not preserved.
 
Benchmark results
 
SWE-bench Verified accuracy increased from 75.8% to 79.2%, an improvement of 3.4 percentage points in agentic coding compared to 82.8% for the base model. LiveCodeBench v6 accuracy remains essentially unchanged within statistical variation.


tu as testé ?

n°54090
moyen_moin​s
chat réincarné
Posté le 20-10-2026 à 10:32:42  profilanswer
 

the_fennec a écrit :

A priori il il faut pas passer sur Strata 2:
https://www.reddit.com/r/LocalLLaMA [...] g_changes/
 
Pas mal de régressions en plus d'imposer une app desktop :/


il y avait encore un petit boost de perfo sur AMD mais tout le bordel entre l'app, le terminal etc., ça m'a soulé, je migrerai pas.

n°54092
speedboyz3​0
Guide Michelin :o
Posté le 20-10-2026 à 10:41:50  profilanswer
 

Y a un nouveau moteur d'inférence sur Mac : Kapitsa.
A voir ce que ça apporte concrètement.
 
Si on peut encore grater quelques tokens c'est pas mal.
 
Et d'ici là on aura peut-être un support eGPU sur Apple qui tient la route (ThunderLlamaX / TiniGPU).

 Page :   1  2  3  4  5  ..  85  86  87  88  89  90

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)