Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3471 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  85  86  87  88  89  90
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°53672
neo world
Posté le 15-10-2026 à 23:19:31  profilanswer
 

Reprise du message précédent :

chris282 a écrit :

auriez vous quelques minutes pour faire une critique constructive de mon dashboard (je n'avais qu'un dashboard moyennement satisfaisant, et j'avais envie d'avoir quelque chose d'aussi bien que ce vous m'avez montré - je l'ai construit avec grok)
 
https://rehost.diberie.com/Picture/Get/t/562424


moi ça me semble bien J'ai été assez loin dans mon dashboard avec trois volets :
1 chat => valide la prise en charge par le modèle d'images, PDFs et me permet de tester les requetes dangereuses / absurdes (reproduire les conditions du big bang à échelle 1 ou reconstruire à la maison une tsar bomba classiquement) sans qu'il fasse des requêtes cheloues au kremlin pour trouver des plans ou demande de l'anti matière à un chercheur du CERN dans le process :o
 
2 le dashboard que j'ai montré et un peu amélioré (compteur d’énergie totale consommée y compris en veille, état de santé des caches, logs d'erreurs de Gufo, extrait des réponses aux 20 dernières requetes (derrière un password et évidement le tout en https) pour pouvoir débuguer un problème, vérifier que tout va bien quand je veux
 
3 un dashboard sur les dernières versions de Gufo avec un extrait des changelogs entre ma version installée et la dernière résumée par mon IA locale chaque jour. Pareil avec Rocm. La version du kernel linux installé, les paramètres de démarrage et la ligne de commande de Gufo (pour vérifier en deux secondes si y'a pas un paramètre à optimiser / faire des diffs en un coup d'oeil avec ce que je trouve sur reddit ou dans les blogs sans faire de ssh
 
https://rehost.diberie.com/Picture/Get/f/562440  
https://rehost.diberie.com/Picture/Get/f/562441  
https://rehost.diberie.com/Picture/Get/f/562442  
 
p'tit focus sur la partie troubleshot des outputs :
https://rehost.diberie.com/Picture/Get/f/562443  
 
Ce rêve de faire des bidouilles en 2026  [:mapix:1]

Message cité 2 fois
Message édité par neo world le 15-10-2026 à 23:19:49
n°53676
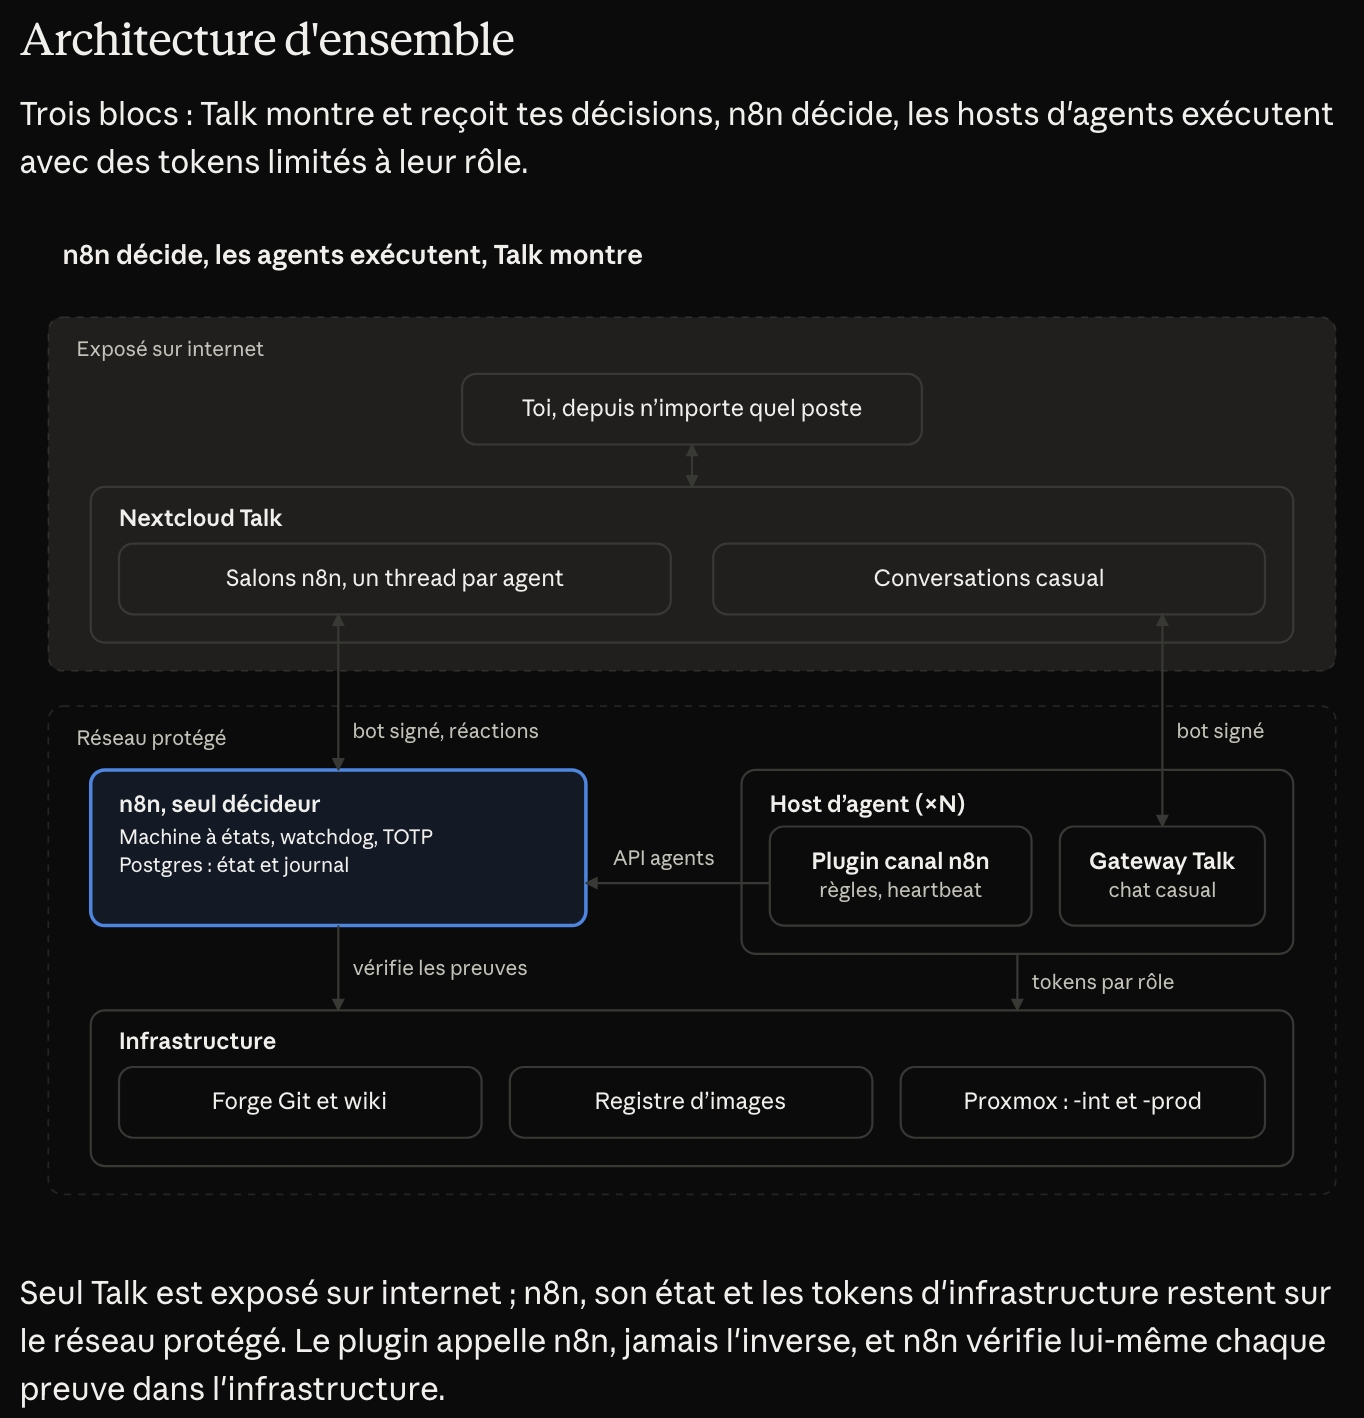
neo world
Posté le 16-10-2026 à 00:40:03  profilanswer
 

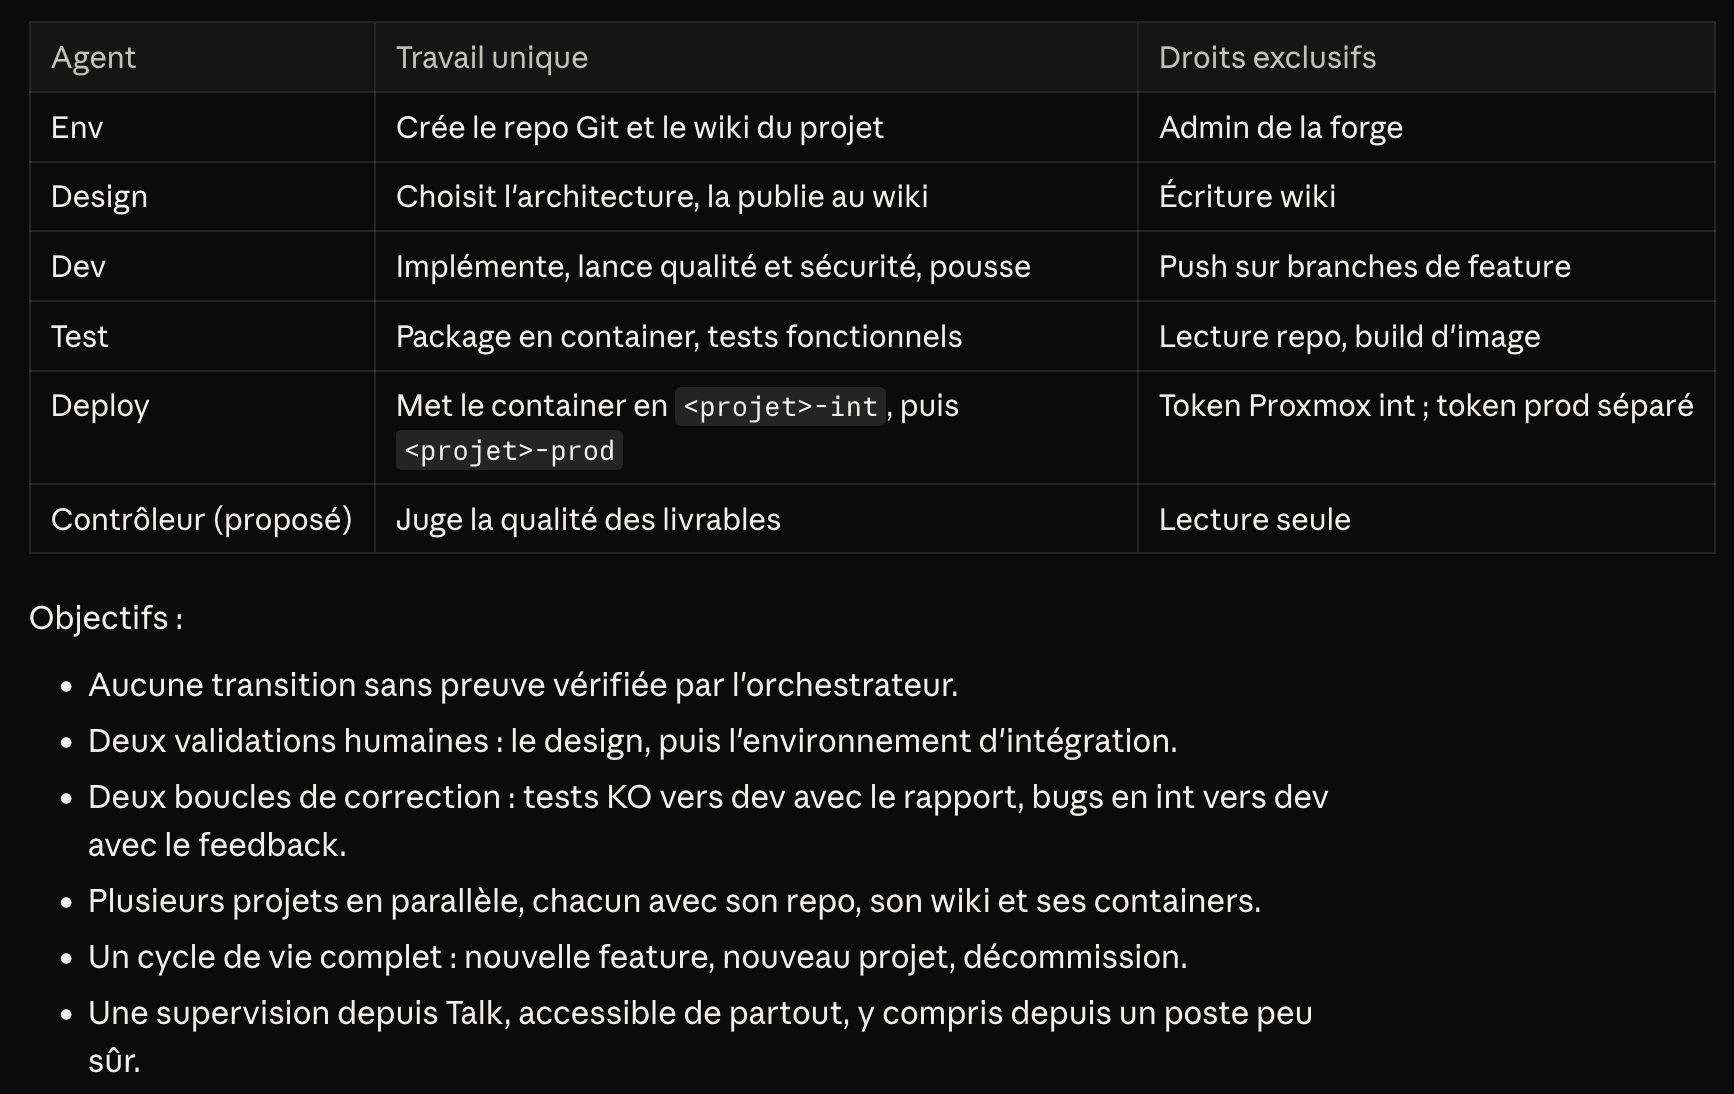
Bon bah j'ai ma roadmap pour Q4 2026. J'espère que N8n est vraiment bien :D :
https://rehost.diberie.com/Picture/Get/f/562473
 
https://rehost.diberie.com/Picture/Get/f/562474
 
Pour ce weekend je fais la partie détection d'attaque / prompt injection / evasion sur la gateway devant le strix halo pour pas être à pwal au premier site qui demande à mon IA de démarrer une usine d'avis frauduleux sur internet au détour d'une question sur la meteo demain :o
 

n°53686
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 07:27:45  profilanswer
 

Citation :

Muse Spark Open is an 816B total/42B active parameter open weights model with a context window of 1M tokens. Built for coding and agentic work, Muse Spark Open is natively multimodal. This open weights version has additional safety post-training to make it more robust against misuse as a standalone model without system guardrails. We recommend deploying Muse Spark Open as part of a broader AI system, with additional guardrails suited to the specific use case.


https://huggingface.co/meta-models/ [...] -816B-A42B
https://research.meta.ai/blog/muse-spark-open
 

Citation :

Today, we’re releasing the weights for Muse Spark Open, the most capable US open-weight model to date. Muse Spark Open is a natively multimodal model with 816B total parameters (42B active) and a 1M-token context window.


L'aveu d’échec :lol:
 
https://i.imgur.com/V1Hq29X.png


Message édité par the_fennec le 16-10-2026 à 07:30:33

---------------
Faudra que je teste un jour :o
n°53694
neo world
Posté le 16-10-2026 à 08:44:47  profilanswer
 

Bon c’est pas trop ridicule non plus et ça reste open weight :D
 
Par contre c’est clairement fait pour un gros DGX ou un cluster. Faudra attendre que ça decomissionne à la pelle des H100 / H200 avant de pouvoir jouer avec ce qui revient à ne jamais y toucher comme de tout façon y’aura Qwen 7 à ce moment là  :whistle:

n°53701
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 09:17:58  profilanswer
 

1.7TB le merdier et il se fait boloss sur le code (le seul truc qui m'intéresse :o) par les modèles chinois dont GLM qui fait 1TB de moins, et même Mistral!
 
J'aurais pas tiqué si il n'y avait pas "the most capable US open-weight model" sachant qu'il n'y a que Netromon que je connaisse dans le tas.


---------------
Faudra que je teste un jour :o
n°53703
neo world
Posté le 16-10-2026 à 09:20:22  profilanswer
 

the_fennec a écrit :

1.7TB le merdier et il se fait boloss sur le code (le seul truc qui m'intéresse :o) par les modèles chinois dont GLM qui fait 1TB de moins, et même Mistral!
 
J'aurais pas tiqué si il n'y avait pas "the most capable US open-weight model" sachant qu'il n'y a que Netromon que je connaisse dans le tas.


Et GPT OSS ? Fraîchement sorti en août… 2025 :o

n°53711
neo world
Posté le 16-10-2026 à 09:37:31  profilanswer
 

Nvidia qui exposait 100M$ de matos sans mot de passe sur internet :
https://cybernews.com/security/nvid [...] erability/
 
Et les gars veulent pas sortir une 5090 à MSRP après pendant qu’ils ne savent pas quoi faire du matos qu’ils possèdent :o

n°53715
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 09:44:10  profilanswer
 

T'inquiète ils préparent une 5080 24GB au même prix, enfin pas le MSRP :D


---------------
Faudra que je teste un jour :o
n°53730
sardhaukar
Posté le 16-10-2026 à 10:31:47  profilanswer
 

Je voulais voter ! Mais y'a pas le modèle que j'utilise au quotidien Muse Glimmer 30B....
Je le trouve assez capable, un assez bon généraliste comme Gemma4 mais meilleur en appels d'outils et en suivi de longues taches d'après mes tests.
 
Je lui ai donné la tache de lire tout ce thread et de me consolider les posts intéressants dans un markdown de synthèse et il m'a fait un beau boulot. (Flemme de lire les 86 pages).  [:cacique:5]

Message cité 1 fois
Message édité par sardhaukar le 16-10-2026 à 10:34:22
n°53733
moyen_moin​s
chat réincarné
Posté le 16-10-2026 à 10:43:15  profilanswer
 

the_fennec a écrit :

1.7TB le merdier et il se fait boloss sur le code (le seul truc qui m'intéresse :o) par les modèles chinois dont GLM qui fait 1TB de moins, et même Mistral!
 
J'aurais pas tiqué si il n'y avait pas "the most capable US open-weight model" sachant qu'il n'y a que Netromon que je connaisse dans le tas.


c'est pas non plus la grosse cata.
ils reviennent dans le game, ils restent open weight
et ils ont plus les moyens d'y rester que Mistral malheureusement.

n°53737
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 10:58:46  profilanswer
 

Oui, c'est juste sur le coté modèle US open weight.
 
Vous connaissiez Inkling et Beam?


---------------
Faudra que je teste un jour :o
n°53741
neo world
Posté le 16-10-2026 à 11:08:09  profilanswer
 

sardhaukar a écrit :

Je voulais voter ! Mais y'a pas le modèle que j'utilise au quotidien Muse Glimmer 30B....
Je le trouve assez capable, un assez bon généraliste comme Gemma4 mais meilleur en appels d'outils et en suivi de longues taches d'après mes tests.
 
Je lui ai donné la tache de lire tout ce thread et de me consolider les posts intéressants dans un markdown de synthèse et il m'a fait un beau boulot. (Flemme de lire les 86 pages).  [:cacique:5]


balance le contenu. Si c'est intéressant ça finira en FP :D

n°53742
neo world
Posté le 16-10-2026 à 11:11:12  profilanswer
 

the_fennec a écrit :

Oui, c'est juste sur le coté modèle US open weight.
 
Vous connaissiez Inkling et Beam?


nope mais Beam par exemple a des gros clients en Europe (volkwagen / Porsche / la ville de Zurich ...) J'imagine que l'approche c'est de vendre du consulting / support sur un agent dont les données restent supprimés leakés manipulés exclusivement en local :D

n°53746
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 11:31:00  profilanswer
 

OK, on est pas vraiment les premier intéressés :o


---------------
Faudra que je teste un jour :o
n°53750
moyen_moin​s
chat réincarné
Posté le 16-10-2026 à 11:43:49  profilanswer
 

the_fennec a écrit :

Oui, c'est juste sur le coté modèle US open weight.
 
Vous connaissiez Inkling et Beam?


inkling, j'ai vu passer un truc dessus, c'est gros, c'est open, c'est pas fou.
beam, connaisssais pas.

n°53760
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 12:34:51  profilanswer
 

Petite pres de REA
 
Reverse Engineering is Officially Automated. (Rea MCP)
kintu
https://youtu.be/Ae4wsTTLNRI


---------------
Faudra que je teste un jour :o
n°53764
moyen_moin​s
chat réincarné
Posté le 16-10-2026 à 12:47:24  profilanswer
 

c'est pas ça qui a servi à faire des clones des apps adobe ?

n°53765
chris282
id steam/psn : chris282_fr
Posté le 16-10-2026 à 13:00:37  profilanswer
 

il y a beaucoup de bruit, c'est difficile a suivre parfois. j'ai vu passer des news vite fait. 2 nouveaux modèles
"ultramarine 1 flash"  en opensource qui sera publié prochainement
"nemotron 3.5 super VL" (opensource, nvidia)
et un nouveau moteur d'inférence qui veut concurrencer llama.cpp et ollama (ils prétendent avoir de meilleurs perfs) : magnitude https://github.com/magnitudedev/magnitude


Message édité par chris282 le 16-10-2026 à 13:00:54
n°53766
chris282
id steam/psn : chris282_fr
Posté le 16-10-2026 à 13:11:32  profilanswer
 

the_fennec a écrit :


Tes unités sont pas bonnes ou manquantes
Un peu bizarre de mélanger anglais et français
La casse des titres n'est pas consistante, soit norme US avec première lettres en majuscule (Dernière Vitesse Prompt), soir FR avec seulement la première (Dernière vitesse prompt)
Tes échelles de vitesses devraient commencer a 0
Dark mode c'est le mal :o


neo world a écrit :


moi ça me semble bien J'ai été assez loin dans mon dashboard avec trois volets :
1 chat => valide la prise en charge par le modèle d'images, PDFs et me permet de tester les requetes dangereuses / absurdes (reproduire les conditions du big bang à échelle 1 ou reconstruire à la maison une tsar bomba classiquement) sans qu'il fasse des requêtes cheloues au kremlin pour trouver des plans ou demande de l'anti matière à un chercheur du CERN dans le process :o
 
2 le dashboard que j'ai montré et un peu amélioré (compteur d’énergie totale consommée y compris en veille, état de santé des caches, logs d'erreurs de Gufo, extrait des réponses aux 20 dernières requetes (derrière un password et évidement le tout en https) pour pouvoir débuguer un problème, vérifier que tout va bien quand je veux
 
3 un dashboard sur les dernières versions de Gufo avec un extrait des changelogs entre ma version installée et la dernière résumée par mon IA locale chaque jour. Pareil avec Rocm. La version du kernel linux installé, les paramètres de démarrage et la ligne de commande de Gufo (pour vérifier en deux secondes si y'a pas un paramètre à optimiser / faire des diffs en un coup d'oeil avec ce que je trouve sur reddit ou dans les blogs sans faire de ssh
 
https://rehost.diberie.com/Picture/Get/f/562440
https://rehost.diberie.com/Picture/Get/f/562441
https://rehost.diberie.com/Picture/Get/f/562442
 
p'tit focus sur la partie troubleshot des outputs :
https://rehost.diberie.com/Picture/Get/f/562443
 
Ce rêve de faire des bidouilles en 2026  [:mapix:1]


merci pour vos retours

n°53767
speedboyz3​0
Guide Michelin :o
Posté le 16-10-2026 à 13:25:17  profilanswer
 

Vous pensez que tous les pc AI Max+ PRO 495 vont faire un flop ?
Pour moi c'est pricé beaucoup trop haut et ça ne va pas se vendre.
 
Attendons de voir les discounts arriver si c'est le cas :o

n°53770
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 13:43:03  profilanswer
 

moyen_moins a écrit :

c'est pas ça qui a servi à faire des clones des apps adobe ?


Si il me semble.


---------------
Faudra que je teste un jour :o
n°53771
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 13:49:28  profilanswer
 

speedboyz30 a écrit :

Vous pensez que tous les pc AI Max+ PRO 495 vont faire un flop ?
Pour moi c'est pricé beaucoup trop haut et ça ne va pas se vendre.
 
Attendons de voir les discounts arriver si c'est le cas :o


Ils vont en vendre des palettes je pense, tout le hard lié à l'inférence se vend, quelque soit le prix :(

Message cité 1 fois
Message édité par the_fennec le 16-10-2026 à 13:49:41

---------------
Faudra que je teste un jour :o
n°53772
neo world
Posté le 16-10-2026 à 13:56:47  profilanswer
 

the_fennec a écrit :


Ils vont en vendre des palettes je pense, tout le hard lié à l'inférence se vend, quelque soit le prix :(


+1 et vu ce qu’on peu en faire depuis l’arrivée de moteurs optimisés open source et non open source ça va pas s’arranger  :(

n°53783
moyen_moin​s
chat réincarné
Posté le 16-10-2026 à 15:36:59  profilanswer
 

speedboyz30 a écrit :

Vous pensez que tous les pc AI Max+ PRO 495 vont faire un flop ?
Pour moi c'est pricé beaucoup trop haut et ça ne va pas se vendre.
 
Attendons de voir les discounts arriver si c'est le cas :o


ça se vendra, peut être que des bosgame s'ils continuent leur tarification agressive :whistle:

n°53785
the_fennec
f3nn3cUs z3rd4
Posté le 16-10-2026 à 15:37:19  profilanswer
 

Quand on parle du loup:
reflection/Beam-1.0-501B-A23B
https://www.reddit.com/r/LocalLLaMA [...] ging_face/
https://huggingface.co/reflection/Beam-1.0-501B-A23B
 
Encore un truc qui tournera pas chez moi :o


---------------
Faudra que je teste un jour :o
n°53787
moyen_moin​s
chat réincarné
Posté le 16-10-2026 à 15:42:47  profilanswer
 

the_fennec a écrit :

Quand on parle du loup:
reflection/Beam-1.0-501B-A23B
https://www.reddit.com/r/LocalLLaMA [...] ging_face/
https://huggingface.co/reflection/Beam-1.0-501B-A23B


Encore un truc qui tournera pas chez moi :o


t'inquiètes, tu seras pas le seul :(


edit: il y a du unsloth UD3 mais à moins de Q2_K_XL, ça a pas l'ai génial :o
et c'est déjà 180GB+ sur le disque...


Message édité par moyen_moins le 16-10-2026 à 15:49:53
n°53823
neo world
Posté le 16-10-2026 à 20:57:04  profilanswer
 

pour info un strix halo (64GO) à un prix relativement intéressant :
https://forum.hardware.fr/hfr/Achat [...] 0192_1.htm

n°53837
neo world
Posté le 17-10-2026 à 00:43:03  profilanswer
 

nouveau joueur entre dans l'arène du strix halo :
 
https://github.com/warpfront/hipfire/raw/master/docs/assets/hero-dark.png
 
https://preview.redd.it/hipfire-0-4-2-1-qwen3-8-flash-125-gb-moe-on-strix-halo-16k-v0-9g0dx7dqmjvh1.png?width=1200&format=png&auto=webp&s=a01baf3c7afd21cd7d7c3a60efdd2dc1e0469d0e
 
https://preview.redd.it/hipfire-0-4-2-1-qwen3-8-flash-125-gb-moe-on-strix-halo-16k-v0-l88p1euumjvh1.png?width=1200&format=png&auto=webp&s=2bbf703edcb576184043e57d63f3d3fec9806580
 
Y'a une hype pour rust qui a l'air payante (en plus de faire appel au NPU ici). Pour ceux qui hésitaient pour l'achat d'un strix halo (128GB recommandé) sans avoir le budget pour prendre un GB10 / Mac M5/6 je pense que c'est votre machine / modele / engine d'agentique. Les prix vont probablement stagner jusqu'au black friday (je ne m'attends pas à de grosses reducs cette année malheureusement) puis probablement repartir à la hausse en mode YOLO si les modèles Qwen 4 arrivent à ce type de vitesse (l'archi sera similaire à 3.8 flash next)
 
pour ceux qui se posent la question de la machine 64GB :
 

Citation :

27B is supported: `hipfire pull qwen3.8:27b-mq4-xts` is about 15 GB, so it fits a 32 GB machine with room for context, and it runs with dflash speculative decoding. the NPU prefill route is Flash-Next only for now, so 27B prefill runs on the iGPU alone. I am working on Q3 and Q2 quants of Flash-Next as well, 48 gb of memory (vram+ram) I think may be the absolute floor for flash next.

Message cité 1 fois
Message édité par neo world le 17-10-2026 à 00:45:25
n°53842
aster
Chaotic Neutral
Posté le 17-10-2026 à 01:10:56  profilanswer
 

Salut,
J'ai de quoi monter la conf suivante avec le matos qui traine :
12900K 8+8 cores, 24 threads
2x24Go DDR5 5600 C40
Asus Z690 Hero 2xPCIE5.0 8x/8x
2x3060Ti 12Go
 
Est-ce équilibré pour un homelab ? Quel serait le goulot d'étranglement ?
:jap:

n°53845
neo world
Posté le 17-10-2026 à 01:38:40  profilanswer
 

aster a écrit :

Salut,
J'ai de quoi monter la conf suivante avec le matos qui traine :
12900K 8+8 cores, 24 threads
2x24Go DDR5 5600 C40
Asus Z690 Hero 2xPCIE5.0 8x/8x
2x3060Ti 12Go
 
Est-ce équilibré pour un homelab ? Quel serait le goulot d'étranglement ?
:jap:


Salut,
 
C'est une belle machine, moyen de monter à 64GB de RAM ? C'est le sweetspot avec strata/ Qwen 3.8 flash next (32GB seront suffisants quand même. Ce sera juste un peu moins la vida loca (ou la vida local :o ) : https://github.com/Niko1221/Strata#what-you-need https://github.com/Niko1221/Strata/ [...] LTI_GPU.md )
 
Par contre il va pas te rester grand chose pour héberger des services/app en parallèle dans la RAM. Qwen 3.8 27b est très bien pour ça : tu peux le mettre intégralement en VRAM (UD-Q4-K-XL) dans de bonnes conditions et garder ta ram pour autre chose. A mon avis faut plutôt voir côté vllm / llama dans ce cas :jap:
 
 
:jap:

n°53848
Jeanmanchz​eck
Posté le 17-10-2026 à 05:08:54  profilanswer
 

neo world a écrit :


balance le contenu. Si c'est intéressant ça finira en FP :D


pour la blague, voici de mon coté le digest du thread avec 3.8 27 b + pp
 
le "prompt" (avec hermes) : lit tout ce thread et consolide/résume les posts intéressants forum.hardware.fr/hfr/ia/infra-troubleshot-locaux-sujet_4_1.htm + pp
 
lien pp : https://www.transfernow.net/dl/20261017oFXke0hu
 
-----------------------------------------

Code :
  1. J'ai lu les 4 parties du digest (86 pages, ~3 429 posts, t15799 → t53837, du 26 avril au 17 octobre 2026). Voici la consolidation des posts qui comptent :
  2. HFR « IA locale — infra & troubleshooting » — synthèse du thread
  3. Habitués : neo world (OP, homelab Strix Halo + agentique), the_fennec (analyses techniques, cluster RPC multi-nœuds), speedboyz30 (goulot de prefill), yohaskan (assistant vocal temps réel RTX 5090), Pipould's (dual GPU), moyen_moins (AMD multi-cartes + mini-PC BC250), Tronklou (hardware petit budget).
  4. Principes et goulots
  5. Le prefill est le goulot de l'agentique : les sessions agent = gros prompt processing, compute-bound. C'est ce qui fait perdre aux Apple M sur les agents malgré le contexte, même avec des caches KV hiérarchiques [t47245]. Request type agent ≈ 60k tokens prefill + ~800 tokens générés.
  6. Le KV cache est le deuxième mur : à ctx 131k+, la KV pèse plus que les poids. Quantiser (q8_0/q4_0) devient nécessaire, mais q4 dégrade visiblement la génération (mots « inventés » proches du bon mot, caractères chinois parasites) — rester en q8 ou q5_1 même à 256k ctx [t51342].
  7. Paliers VRAM : 32/40 Go puis directement 128/256 Go — les tailles intermédiaires = payer plus pour rien. Et ne pas courir après la VRAM chez soi : un 27B/30B actuel est au niveau d'un GPT-OSS-120B de l'année dernière [t46003].
  8. Manque de RAM DDR5 + transition DDR6 = offload CPU cher en ce moment, censé se calmer (the_fennec [t46902]).
  9. Modèles et quantisations (ère Qwen 3.8)
  10. Qwen3.8-27B dense = le modèle local de référence : bench pondéré 87 vs Sonnet 5 à 95 — « derrière, mais pas dégueulasse » [t49715]. Point notable : dit « je ne sais pas » au lieu d'halluciner (contrairement à Gemma/Mistral sur ce test) [t45629].
  11. Qwen3.8 Flash Next : nouvelle archi avec pools mémoire séparés — poids actifs ~55GB en RAM rapide, table n-gram ~38GB qui se page depuis le SSD (~2,7KB/token de lectures aléatoires, largement faisable) [t46946]. Config référence Strix Halo : UD-Q4_K_XL + ROCm 7.14 + léger OC ryzenadj → ctx 200–262k, prefill qui démarre à ~890 t/s, MTP accepté à ~70 % [t48781].
  12. Quantisation optimale 27B sur carte unique (tfpsly, RTX 5060 Ti 16GB) : Qwen3.8-27B-4.2BPW-16GB (couches de connaissance compressées, couches logiques préservées) → ctx 110–120k en 12,9 Go VRAM, gros refactor de 17 étapes validé ; la variante GSQ-RCO-IQ3_S-mtp foire sur les compactions de contexte [t50689, t50801].
  13. Pièges : LM Studio ignore les params reasoning_effort/thinking de Qwen 3.8 (bug connu) [t45258] ; quant K_L en dual AMD = repli partiel CPU silencieux qui divise par 2 la vitesse (buffers F16/BF16), vérifier les logs au-delà de « ça fit » [t50434].
  14. Moteurs et outils
  15. llama.cpp reste le socle : -fit auto-split, spec-draft/MTP, RPC inter-machines à devices mixtes (cluster du fennec sur son LAN), PR 100% IA acceptés si qualité/transparency au rendez-vous [t43021], et un GUI Windows officiel (Llama-Windows, tray app) est sorti [t53338].
  16. vLLM : roi du prefill + prefix caching (>54 % de hit), 200–300 t/s gén sur RTX PRO Blackwell [t43916]. Astuce notée : P2P sans NVLink entre deux 3090 via la branche open-gpu-kernel-modules (p2p-v3, DKMS) + TP=2 Qwen3.8-27B int4 fp8 KV [t49217].
  17. Intel Arc B60 Pro ×2 : vllm-openai-xpu 0.30 avec xpu-graphs → fiable à ~900 t/s prefill / 14 t/s gén sur Qwen3.8-27B FP8, ctx 65k [t52205]. Attention aux cartes CMP : liens PCIe x4 1.0 + pas de tensor cores = mauvais pour le prefill [t45478].
  18. KoboldCpp sous-coté pour débuter (CUDA/Vulkan en simple, UI web fournie) [t49832] ; Unsloth Desktop annoncé (run+train local, GGUF/MLX, 70 % VRAM en moins à l'entraînement) mais ses quants font « refroidir » quelques utilisateurs côté qualité [t44811, t52612].
  19. Moteurs niche Strix Halo : Halogen (peonist-ai, fermé, format propriétaire non-GGUF, container à droits larges — neo world trouve ça « too good to be true ») [t48792], et un engine « rust » qui exploite le NPU du Strix Halo [t53837].
  20. Maya/Strata : fait tourner GLM-5.3-Flash (321B MoE, ~18B actifs/token, ctx 1M) sur GPU grand public — NVIDIA cc7+, AMD expérimental, démarrage dès 32 Go de RAM [t53099].
  21. Astuce bien notée : donner sa config llama-server + son hardware au modèle pour qu'il optimise lui-même le tensor-split → +25 % TG et +65k ctx trouvés par l'IA elle-même [t49501].
  22. Matériel — petit budget vs haut de gamme
  23. Sweet spot budget : dual 2080 Ti 22 Go NVLink sous ~1 k€ (CUDA, VRAM au meilleur prix/Go, tourne sur plateformes vieilles) ; X99 chinoise = porte d'entrée multi-GPU à bas coût [t46003, t45816].
  24. Strix Halo / BC250 : cœurs morts → kernel custom + isolation de CU (bc250-cu-live-manager) ; tuning maxpower 110W/95 °C = +16 % prefill [t48769] ; SSD Kingston NV3 qui chauffe à mort sur ~30 s dans les boxes Strix Halo [t47482]. Verdict de fin de thread : Strix Halo 128 Go = la machine agentique si GB10/Mac M5 hors budget, Qwen4 attendu à vitesse similaire [t53837].
  25. Haut de gamme : RTX PRO 6000 Blackwell + vLLM en entreprise → ~100–200 t/s par requête constants quelle que soit la concurrence d'utilisateurs [t47523] ; données spec-decoding réelles GLM : acceptation 0,80→0,1 sur 7 positions, longueur moyenne acceptée 3,75.
  26. CPU seul : VM 128–200 Go RAM + ~20 cœurs = 10–15 t/s en MoE — OK pour de la synthèse batch nocturne, pas du chat interactif [t42196]. Mobile (llama.cpp sur Android) reste marginal : ~3,6 t/s, surchauffe [t50415].
  27. Workflows agentiques
  28. Hybride local/cloud : dev en local (Qwen3.8 Flash Next Q4 + pi.dev), phases de validation longues envoyées au cloud pas cher — le débat « cloud à 15 €/mois vs local » n'a pas tranché, consensus = l'hybride [t47720].
  29. Sécurisation : scan ClamAV toutes les 5 min + log des appels d'outils suspects (curl/wget/npm/apt/nc) vers Wazuh — l'agent local est une nouvelle surface d'attaque [t48117].
  30. Infra maison : gateway pi.dev ↔ Nextcloud Talk (webhook → session par thread, pièces jointes en WebDAV) [t53495], salons familiaux avec agents dédiés. NVIDIA PAIR (router multi-machines RTX/DGX/Mac) signalé comme à suivre [t53603].
  31. Assistant vocal temps réel (yohaskan, 5090) : TTFA < 4 s en moyenne après optimisation (vs ~45 s il y a 3 ans), thinking adaptatif OFF/MEDIUM/HIGH selon la complexité [t45962].
  32. CAD local : FreeCAD piloté via MCP par Qwen 3.6 35B — cube perçé OK, boulon fileté échec ; pas viable en l'état [t52547].
  33. Débats de fond
  34. Chinois vs Américains : les modèles ouverts chinois gagnent du terrain, Nvidia parie sur le datacenter et délaisse le grand public [t48948] ; JEV (nouvelle technique d'inférence) = « rien de nouveau, c'est du parallélisme », reproduit avec un petit modèle + orchestration [t50395].
  35. La confidentialité reste l'argument local massue pour le home lab, mais le rapport qualité/prix cloud est très dur à battre sur les gros modèles [t43920].
  36. Posts à relire en priorité
  37. Post
  38. Contenu
  39. t48781 Config référence Strix Halo, 262k ctx
  40. t49217 P2P dual 3090 sans NVLink + vLLM
  41. t50801 Qwen3.8-27B sur carte unique 16 Go
  42. t53099 GLM-5.3-Flash sur matos grand public (Maya)
  43. t52205 Dual Arc B60 Pro fiable sous XPU
  44. t45837 Rapport long « montage IA local improbable »
  45. t44262 Rack + réseau complet de neo world en photos
  46. Note : la lecture couvre les 182 posts substantiels (≥700 caractères) des 3 429 du thread ; les petites réactions et salutations ont été filtrées. Les fichiers bruts sont dans

n°53872
aster
Chaotic Neutral
Posté le 17-10-2026 à 13:35:15  profilanswer
 

neo world a écrit :


Salut,
 
C'est une belle machine, moyen de monter à 64GB de RAM ? C'est le sweetspot avec strata/ Qwen 3.8 flash next (32GB seront suffisants quand même. Ce sera juste un peu moins la vida loca (ou la vida local :o ) : https://github.com/Niko1221/Strata#what-you-need https://github.com/Niko1221/Strata/ [...] LTI_GPU.md )
 
Par contre il va pas te rester grand chose pour héberger des services/app en parallèle dans la RAM. Qwen 3.8 27b est très bien pour ça : tu peux le mettre intégralement en VRAM (UD-Q4-K-XL) dans de bonnes conditions et garder ta ram pour autre chose. A mon avis faut plutôt voir côté vllm / llama dans ce cas :jap:
:jap:


Merci ! :jap:
Oui je pourrais monter à 64Go de RAM, j'ai quelques kits que je réservais à la spéculation :p

n°53874
neo world
Posté le 17-10-2026 à 14:20:11  profilanswer
 

Jeanmanchzeck a écrit :


pour la blague, voici de mon coté le digest du thread avec 3.8 27 b + pp
 
le "prompt" (avec hermes) : lit tout ce thread et consolide/résume les posts intéressants forum.hardware.fr/hfr/ia/infra-troubleshot-locaux-sujet_4_1.htm + pp
 
lien pp : https://www.transfernow.net/dl/20261017oFXke0hu
 
-----------------------------------------

Code :
  1. J'ai lu les 4 parties du digest (86 pages, ~3 429 posts, t15799 → t53837, du 26 avril au 17 octobre 2026). Voici la consolidation des posts qui comptent :
  2. HFR « IA locale — infra & troubleshooting » — synthèse du thread
  3. Habitués : neo world (OP, homelab Strix Halo + agentique), the_fennec (analyses techniques, cluster RPC multi-nœuds), speedboyz30 (goulot de prefill), yohaskan (assistant vocal temps réel RTX 5090), Pipould's (dual GPU), moyen_moins (AMD multi-cartes + mini-PC BC250), Tronklou (hardware petit budget).
  4. Principes et goulots
  5. Le prefill est le goulot de l'agentique : les sessions agent = gros prompt processing, compute-bound. C'est ce qui fait perdre aux Apple M sur les agents malgré le contexte, même avec des caches KV hiérarchiques [t47245]. Request type agent ≈ 60k tokens prefill + ~800 tokens générés.
  6. Le KV cache est le deuxième mur : à ctx 131k+, la KV pèse plus que les poids. Quantiser (q8_0/q4_0) devient nécessaire, mais q4 dégrade visiblement la génération (mots « inventés » proches du bon mot, caractères chinois parasites) — rester en q8 ou q5_1 même à 256k ctx [t51342].
  7. Paliers VRAM : 32/40 Go puis directement 128/256 Go — les tailles intermédiaires = payer plus pour rien. Et ne pas courir après la VRAM chez soi : un 27B/30B actuel est au niveau d'un GPT-OSS-120B de l'année dernière [t46003].
  8. Manque de RAM DDR5 + transition DDR6 = offload CPU cher en ce moment, censé se calmer (the_fennec [t46902]).
  9. Modèles et quantisations (ère Qwen 3.8)
  10. Qwen3.8-27B dense = le modèle local de référence : bench pondéré 87 vs Sonnet 5 à 95 — « derrière, mais pas dégueulasse » [t49715]. Point notable : dit « je ne sais pas » au lieu d'halluciner (contrairement à Gemma/Mistral sur ce test) [t45629].
  11. Qwen3.8 Flash Next : nouvelle archi avec pools mémoire séparés — poids actifs ~55GB en RAM rapide, table n-gram ~38GB qui se page depuis le SSD (~2,7KB/token de lectures aléatoires, largement faisable) [t46946]. Config référence Strix Halo : UD-Q4_K_XL + ROCm 7.14 + léger OC ryzenadj → ctx 200–262k, prefill qui démarre à ~890 t/s, MTP accepté à ~70 % [t48781].
  12. Quantisation optimale 27B sur carte unique (tfpsly, RTX 5060 Ti 16GB) : Qwen3.8-27B-4.2BPW-16GB (couches de connaissance compressées, couches logiques préservées) → ctx 110–120k en 12,9 Go VRAM, gros refactor de 17 étapes validé ; la variante GSQ-RCO-IQ3_S-mtp foire sur les compactions de contexte [t50689, t50801].
  13. Pièges : LM Studio ignore les params reasoning_effort/thinking de Qwen 3.8 (bug connu) [t45258] ; quant K_L en dual AMD = repli partiel CPU silencieux qui divise par 2 la vitesse (buffers F16/BF16), vérifier les logs au-delà de « ça fit » [t50434].
  14. Moteurs et outils
  15. llama.cpp reste le socle : -fit auto-split, spec-draft/MTP, RPC inter-machines à devices mixtes (cluster du fennec sur son LAN), PR 100% IA acceptés si qualité/transparency au rendez-vous [t43021], et un GUI Windows officiel (Llama-Windows, tray app) est sorti [t53338].
  16. vLLM : roi du prefill + prefix caching (>54 % de hit), 200–300 t/s gén sur RTX PRO Blackwell [t43916]. Astuce notée : P2P sans NVLink entre deux 3090 via la branche open-gpu-kernel-modules (p2p-v3, DKMS) + TP=2 Qwen3.8-27B int4 fp8 KV [t49217].
  17. Intel Arc B60 Pro ×2 : vllm-openai-xpu 0.30 avec xpu-graphs → fiable à ~900 t/s prefill / 14 t/s gén sur Qwen3.8-27B FP8, ctx 65k [t52205]. Attention aux cartes CMP : liens PCIe x4 1.0 + pas de tensor cores = mauvais pour le prefill [t45478].
  18. KoboldCpp sous-coté pour débuter (CUDA/Vulkan en simple, UI web fournie) [t49832] ; Unsloth Desktop annoncé (run+train local, GGUF/MLX, 70 % VRAM en moins à l'entraînement) mais ses quants font « refroidir » quelques utilisateurs côté qualité [t44811, t52612].
  19. Moteurs niche Strix Halo : Halogen (peonist-ai, fermé, format propriétaire non-GGUF, container à droits larges — neo world trouve ça « too good to be true ») [t48792], et un engine « rust » qui exploite le NPU du Strix Halo [t53837].
  20. Maya/Strata : fait tourner GLM-5.3-Flash (321B MoE, ~18B actifs/token, ctx 1M) sur GPU grand public — NVIDIA cc7+, AMD expérimental, démarrage dès 32 Go de RAM [t53099].
  21. Astuce bien notée : donner sa config llama-server + son hardware au modèle pour qu'il optimise lui-même le tensor-split → +25 % TG et +65k ctx trouvés par l'IA elle-même [t49501].
  22. Matériel — petit budget vs haut de gamme
  23. Sweet spot budget : dual 2080 Ti 22 Go NVLink sous ~1 k€ (CUDA, VRAM au meilleur prix/Go, tourne sur plateformes vieilles) ; X99 chinoise = porte d'entrée multi-GPU à bas coût [t46003, t45816].
  24. Strix Halo / BC250 : cœurs morts → kernel custom + isolation de CU (bc250-cu-live-manager) ; tuning maxpower 110W/95 °C = +16 % prefill [t48769] ; SSD Kingston NV3 qui chauffe à mort sur ~30 s dans les boxes Strix Halo [t47482]. Verdict de fin de thread : Strix Halo 128 Go = la machine agentique si GB10/Mac M5 hors budget, Qwen4 attendu à vitesse similaire [t53837].
  25. Haut de gamme : RTX PRO 6000 Blackwell + vLLM en entreprise → ~100–200 t/s par requête constants quelle que soit la concurrence d'utilisateurs [t47523] ; données spec-decoding réelles GLM : acceptation 0,80→0,1 sur 7 positions, longueur moyenne acceptée 3,75.
  26. CPU seul : VM 128–200 Go RAM + ~20 cœurs = 10–15 t/s en MoE — OK pour de la synthèse batch nocturne, pas du chat interactif [t42196]. Mobile (llama.cpp sur Android) reste marginal : ~3,6 t/s, surchauffe [t50415].
  27. Workflows agentiques
  28. Hybride local/cloud : dev en local (Qwen3.8 Flash Next Q4 + pi.dev), phases de validation longues envoyées au cloud pas cher — le débat « cloud à 15 €/mois vs local » n'a pas tranché, consensus = l'hybride [t47720].
  29. Sécurisation : scan ClamAV toutes les 5 min + log des appels d'outils suspects (curl/wget/npm/apt/nc) vers Wazuh — l'agent local est une nouvelle surface d'attaque [t48117].
  30. Infra maison : gateway pi.dev ↔ Nextcloud Talk (webhook → session par thread, pièces jointes en WebDAV) [t53495], salons familiaux avec agents dédiés. NVIDIA PAIR (router multi-machines RTX/DGX/Mac) signalé comme à suivre [t53603].
  31. Assistant vocal temps réel (yohaskan, 5090) : TTFA < 4 s en moyenne après optimisation (vs ~45 s il y a 3 ans), thinking adaptatif OFF/MEDIUM/HIGH selon la complexité [t45962].
  32. CAD local : FreeCAD piloté via MCP par Qwen 3.6 35B — cube perçé OK, boulon fileté échec ; pas viable en l'état [t52547].
  33. Débats de fond
  34. Chinois vs Américains : les modèles ouverts chinois gagnent du terrain, Nvidia parie sur le datacenter et délaisse le grand public [t48948] ; JEV (nouvelle technique d'inférence) = « rien de nouveau, c'est du parallélisme », reproduit avec un petit modèle + orchestration [t50395].
  35. La confidentialité reste l'argument local massue pour le home lab, mais le rapport qualité/prix cloud est très dur à battre sur les gros modèles [t43920].
  36. Posts à relire en priorité
  37. Post
  38. Contenu
  39. t48781 Config référence Strix Halo, 262k ctx
  40. t49217 P2P dual 3090 sans NVLink + vLLM
  41. t50801 Qwen3.8-27B sur carte unique 16 Go
  42. t53099 GLM-5.3-Flash sur matos grand public (Maya)
  43. t52205 Dual Arc B60 Pro fiable sous XPU
  44. t45837 Rapport long « montage IA local improbable »
  45. t44262 Rack + réseau complet de neo world en photos
  46. Note : la lecture couvre les 182 posts substantiels (≥700 caractères) des 3 429 du thread ; les petites réactions et salutations ont été filtrées. Les fichiers bruts sont dans


aucune mention du scotch ni du charcutage de boitier  [:mayonaise]  
 
merci pour le partage :jap:

n°53875
neo world
Posté le 17-10-2026 à 14:20:56  profilanswer
 

aster a écrit :


Merci ! :jap:
Oui je pourrais monter à 64Go de RAM, j'ai quelques kits que je réservais à la spéculation :p


go 64GO pour être large alors :jap:

n°53876
neo world
Posté le 17-10-2026 à 14:23:38  profilanswer
 

Intel qui arrive dans les DC avec des cartes 160GB / 480 (LPDDR5x avec du de 1000 tflops + en matrices 4bits / 1,5TB/s de bande passante)
https://www.techpowerup.com/gpu-specs/d270.c4452
https://www.techpowerup.com/gpu-spe [...] -gb.b13357
 
pas vu de prix :D

n°53881
moyen_moin​s
chat réincarné
Posté le 17-10-2026 à 15:48:38  profilanswer
 

j'ai remarqué qu'avec strata et le modèle iq3_s gsq rco, il y avait quand même beaucoup de "tool calling" ratés. :/
je vois que le iq4_xs d'unsloth apporte pas forcément plus sur les métriques mais est peut être plus consistant sur les tool calls ? [:paysan]

n°53882
neo world
Posté le 17-10-2026 à 15:54:35  profilanswer
 

moyen_moins a écrit :

j'ai remarqué qu'avec strata et le modèle iq3_s gsq rco, il y avait quand même beaucoup de "tool calling" ratés. :/
je vois que le iq4_xs d'unsloth apporte pas forcément plus sur les métriques mais est peut être plus consistant sur les tool calls ? [:paysan]


The_feenec avait l’air content en iq2. Je suis en UD Q4 K XL. Ça ne l’empêche pas de faire des conneries chez moi mais il corrige facilement :D
 
Tu utilises quel harness ? Peut être que Claude code aiderait ?


Message édité par neo world le 17-10-2026 à 15:54:59
n°53883
moyen_moin​s
chat réincarné
Posté le 17-10-2026 à 15:59:31  profilanswer
 

je suis sur opencode v2
j'ai pris mes habitudes là dessus :)
 
bon, il a au moins réussi à faire marcher le monitor de strata qui ne fonctionne comme il faut que sous linux.  
à part la charge du bus pcie, j'ai tout maintenant sous windows :)

n°53896
alanou
Remembering M.P.
Posté le 17-10-2026 à 18:57:23  profilanswer
 

Bon voilà, ma machine avec le 3 x Radeon V620 est vendue et partie à son nouveau propriétaire.
 
J'ai mis mon autre Lenovo P620 avec ces 2 x RTX 3090 en annonce sur leboncoin et en moins de 5 minutes j'ai eu deux offres presque intéressantes... C'est pas tout à fait le même attrait.
 
Pour vous donner un ordre d'idée, sur la machine à 3xV620 j'avais tout de même une 60 aine de contacts, et entre 12 ou 15 offres (dont 10 "sérieuses" à plus de 3000€).
 
https://img3.super-h.fr/images/2026/10/17/snapshot_7984930972828373171.jpg
 
Si ça intéresse du monde ici, hésitez pas
 
Money shot HFR en bonus  
https://img3.super-h.fr/images/2026/10/17/snapshot_1728148754735045004.jpg


---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°53897
neo world
Posté le 17-10-2026 à 19:14:47  profilanswer
 

mais comment tu fais pour avoir autant de matos aussi varié ? :pt1cable:  
 
n'empêche ça semble être très compétitif niveau rapport qualité/prix. Si j'avais pas un bosgamepc je me serai posé la question :jap:

n°53939
moyen_moin​s
chat réincarné
Posté le 18-10-2026 à 10:50:42  profilanswer
 

c'est quoi encore tous ces gpus :o
c'est sûr qu'à côté ma config... :whistle:

 Page :   1  2  3  4  5  ..  85  86  87  88  89  90

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)