Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
7903 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  79  80  81  82  83  84
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°53069
Pipould's
Posté le 11-10-2026 à 11:33:27  profilanswer
 

Reprise du message précédent :

ionik a écrit :

strata marche pas trop mal je trouve
 
https://rehost.diberie.com/Picture/Get/r/560942
 
Niveau retour d'information avec Qwen Next IQ2 sur du code, les résultat d'un audit de code avec claude code ne sont pas mauvais je trouve.


Une fois l'audit termine, demande lui un audit de l'audit... il va encore trouver des trucs...  :cry:

n°53072
moyen_moin​s
chat réincarné
Posté le 11-10-2026 à 11:50:47  profilanswer
 

the_fennec a écrit :


ça oui, c'est obligé :o
 
Entre Win10 EOL; Win11 tout pourris; la chute de vente des PC; SteamOS; et les Mac qui deviennent "bon marché"; les chiffres vont pas être bon cette année pour MS :lol:


win11 c'est no way de toute façon.
ce qui me fait chier, c'est que j'ai tout mes disques en ntfs, qu'il va falloir tout refaire... ou que j'en achète un autre pour faire du dual boot "au cas où" [:ideenoire]  
FLEMME mais c'est comme tout, faudra y passer.
 

Pipould's a écrit :


Tu peux regarder https://github.com/mw00/project-maya pour windows mais generallement TP=1 et windows c'est pas dingue dingue
 
De maniere generale windows c'est... complique ?


JE SAIS §§§§ :'(

Message cité 1 fois
Message édité par moyen_moins le 11-10-2026 à 11:51:36
n°53078
ionik
Posté le 11-10-2026 à 12:15:53  profilanswer
 

chris282 a écrit :


j'ai rien compris ? qui fait l'audit du code : strata+qwen ou bien claude ?


Je lui fait faire un audit avec Qwen via strata en utilisant claude claude
 

the_fennec a écrit :


Je suis en Q2 et je me tate a passer mon server a 128GB de RAM ... alors que je viens tout juste d'acheter 2x16GB :pt1cable:
 
Faudrait que je trouve 4x32GB de DDR4 ECC pas chère vu que mon Ryzen Pro supporte l'ECC.


Je suis sur ma machine local avec RTX 3090 + 128 Go de ram (384k de contexte + 16 Go de cache de contexte)
 

Pipould's a écrit :


Une fois l'audit termine, demande lui un audit de l'audit... il va encore trouver des trucs...  :cry:


Il trouve toujours des choses suivant comment tu l'orientes c'est le principe, mais comme je fais auditer par plusieurs LLM et que je les fait se challenger même si il remonte des choses l'autre peut le contredire et il trouve un consensus pour eviter de tourner en boucle etc ...
Seule grosse contrainte ça prend énormément de temps et de token (d'ou le test  que je fais sur l'audit des dernier commit pour voir si justement ça serait pertinent de faire l'audit dans mon flux actuel via aussi strata/Qwen)


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°53080
neo world
Posté le 11-10-2026 à 12:22:27  profilanswer
 

Pour les audits de code je vous conseille de le faire via OCR :  
https://github.com/alibaba/open-code-review
C’est carré :D

n°53082
ionik
Posté le 11-10-2026 à 12:35:00  profilanswer
 

neo world a écrit :

Pour les audits de code je vous conseille de le faire via OCR :  
https://github.com/alibaba/open-code-review
C’est carré :D


je vais regarde je ne connais pas


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°53088
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 16:12:00  profilanswer
 

moyen_moins a écrit :


win11 c'est no way de toute façon.
ce qui me fait chier, c'est que j'ai tout mes disques en ntfs, qu'il va falloir tout refaire... ou que j'en achète un autre pour faire du dual boot "au cas où" [:ideenoire]  
FLEMME mais c'est comme tout, faudra y passer.


Je suis en train de migrer tranquillou mes services Windows 2019 vers des VMs Linux. Mais je compte garder mes disques "NAS" en NTFS, même quand le passerais sous Linux. La raison est simple, je sais récupérer un FS en NTFS en vrac, mais les autres FS. Et pour ce qui est du RAID, au taf' j'ai passé deux semaines a récupérer un NAS Synology qui avait crashé, le support avait dit que c'était pas possible et disait de tout effacer...
 
J'ai mon HTPC de jeux/TV qui est sous Win10, j'attends un bon deal sur un GPU AMD pour remplacer ma 3070, c'est prévu en 2034 :o
Dernier Windows mon laptop gamer, sous Win11... je sais pas trop encore comment faire vu que je peux pas changer de GPU, pour le moment je vais subir Win11 encore un moment.


---------------
Faudra que je teste un jour :o
n°53089
moyen_moin​s
chat réincarné
Posté le 11-10-2026 à 16:36:35  profilanswer
 

j'ai pris un SSD d'1To je vais installer linux, j'ai un adaptateur nvme->pcie 16X, ça sera toujours utile si je veux jouer ou reboot su mon windows.
 
meilleure distro pour du matos AMD ? Cachy OS ? Ubuntu+kde ? :o

n°53090
alanou
Remembering M.P.
Posté le 11-10-2026 à 16:40:31  profilanswer
 

moyen_moins a écrit :

j'ai pris un SSD d'1To je vais installer linux, j'ai un adaptateur nvme->pcie 16X, ça sera toujours utile si je veux jouer ou reboot su mon windows.
 
meilleure distro pour du matos AMD ? Cachy OS ? Ubuntu+kde ? :o


Fedora 45 KDE beta  :jap:


---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°53091
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 16:55:53  profilanswer
 

moyen_moins a écrit :

j'ai pris un SSD d'1To je vais installer linux, j'ai un adaptateur nvme->pcie 16X, ça sera toujours utile si je veux jouer ou reboot su mon windows.
 
meilleure distro pour du matos AMD ? Cachy OS ? Ubuntu+kde ? :o


De mon coté je dirais:
- Cachy OS si tu veux des updates toutes les 2 minutes et un truc nouveau. (mais aussi des trucs pétés toutes les 5 minutes)
- Debian pour la stabilité.
 
L'avantage de Cachy c'est que pour jouer plus besoin de Windows avec le support de Steam, Epic, etc. sauf jeux avec anti-cheat.


Message édité par the_fennec le 11-10-2026 à 16:56:15

---------------
Faudra que je teste un jour :o
n°53092
neo world
Posté le 11-10-2026 à 17:02:15  profilanswer
 

J’aurais tendance à conseiller les nouveaux kernel avec l’option qui allait bien pour optimiser les performances. À vérifier si Fedora 45 le propose par défaut ? Sinon un Fedora 44 avec un kernel tout neuf :D

n°53094
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 11-10-2026 à 17:40:23  profilanswer
 

Si c'est pour jouer , bazzit ! Si c'est pour de l'inférence, team debian après avoir ragequit avec fedora :D


---------------
Victime de girafophobie, mais se soigne.
n°53095
moyen_moin​s
chat réincarné
Posté le 11-10-2026 à 18:04:51  profilanswer
 

j'ai fedora sur le bc-250, ça a l'air de fonctionner correctement :)
fedora ou debian donc. :jap:

n°53099
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 22:31:34  profilanswer
 

Strata pour GLM 5.3:
https://github.com/mw00/project-maya
 

Citation :


Maya runs GLM-5.3-Flash (zai-org, MIT license) on the hardware you already have: 321 B parameters, about 18 B active per token, and a context of up to 1 M tokens. Its engine is built for this one model.  
 
What you need
 
GPU  NVIDIA, compute capability 7.0 or newer (V100, RTX 20 and newer): one, or up to 16 that share the model. More VRAM is faster. AMD (experimental): RX 7900 XT / XTX, Radeon AI PRO R9700 / RX 9070, Strix Halo and Gorgon Halo (Radeon 8060S / 8065S), text only - docs/AMD_MAYA.md
RAM  32 GB runs it. More RAM keeps more experts close and is faster
Disk  A fast NVMe SSD with room for the model (~100 GB for Maya-S, ~160 GB for Maya-L) and its picture encoder (1.1 GB). Not a hard disk


 :pt1cable: :love: faut que je teste ça aussi :o


---------------
Faudra que je teste un jour :o
n°53100
tfpsly
Sly
Posté le 11-10-2026 à 22:43:54  profilanswer
 

Vraiment impressionnant le Strata  :ouch:
Mon NVMe est un peu trop plein (dual boot), j'en ai chié pour faire assez de place pour QW3.8-FN. Mais ça vaut largement le coup.


Le prefill qui dépasse les 1200 tk/s
La génération en général vers 50tk/s, avec des pointes à 100tk/s  :love:
https://i.ibb.co/sv8STg5b/image.png


J'utilise le model qwen3.8-flash-next-coder-iq1_m, avec cette ligne de commande :

Code :
  1. ./setup.sh  --context  65535 --vision no --backend cuda --vram-reserve-mib 500 --draft-vocab en


Message édité par tfpsly le 11-10-2026 à 22:59:12
n°53101
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 22:59:41  profilanswer
 

J'ai eu des pointes a 129 en génération :love: avec une 4060Ti c'est incroyable!
Ça va être difficile de revenir à autre chose!
 
Mon SSD c'est un SATA, mais il sert pas beaucoup.
 
Passer a 200k de contexte et Claude configuré a 150k, j'ai plus de soucis de thrashing.
 
La ça fait plus de 11h qu'il bosse pour me trouver une nouvelle chaise de bureau, on verra bien si c'est mieux que pour les GPUs. (il est arrivé aux même conclusions que le reste de la terre, ya pas de bon plans pour 16GB/32GB :()


---------------
Faudra que je teste un jour :o
n°53102
neo world
Posté le 11-10-2026 à 23:21:14  profilanswer
 

the_fennec a écrit :

J'ai eu des pointes a 129 en génération :love: avec une 4060Ti c'est incroyable!
Ça va être difficile de revenir à autre chose!
 
Mon SSD c'est un SATA, mais il sert pas beaucoup.
 
Passer a 200k de contexte et Claude configuré a 150k, j'ai plus de soucis de thrashing.
 
La ça fait plus de 11h qu'il bosse pour me trouver une nouvelle chaise de bureau, on verra bien si c'est mieux que pour les GPUs. (il est arrivé aux même conclusions que le reste de la terre, ya pas de bon plans pour 16GB/32GB :()


je note que le premier que tu fais avec un modèle performant c'est de remplacer les topics de l'elite HFR :o
 
en plus je suis certain que tu trouverais la bonne info en moins de 11h sur ces topics :o

n°53105
the_fennec
f3nn3cUs z3rd4
Posté le 12-10-2026 à 08:10:48  profilanswer
 

neo world a écrit :


je note que le premier que tu fais avec un modèle performant c'est de remplacer les topics de l'elite HFR :o
 
en plus je suis certain que tu trouverais la bonne info en moins de 11h sur ces topics :o


Pour les GPUs j'ai eu plein d'info compilés en un seul doc avec des prix a jours. Je suis toujours en train de baver devant des m10 ou des mi50 32GB, et la j'ai toutes les infos de ce qu'on peut faire avec. Le seul truc ou il est tombé dans le panneau ce sont les listing de v100 sur Aliexpress ou il a prix les prix des 16GB pour ceux de 32GB, mais il a noté clairement qu'il était pas sur du prix vu que les deux sont listés.
 
Pour les sièges, j'ai posté sur le topic et j'ai eu aucune réponse, le consensus étant d'acheter une chaise a 2k d'occase pour 300 euros sur leboncoin mais ça me plais pas, je préfère du neuf. Il m'a aussi compilé ce qui est dispo en local et cumulé les coupons. Ça m'a pris deux minutes de faire le prompt, et comme pour le code, je me fais la main ça sera beaucoup mieux bientôt.
 
En tout cas je suis satisfait du résultat, aucun lien bidon, les prix sont les bons et j'ai toutes les infos que j'ai demandé. C'est plus lent que Gemini, mais bien plus précis.


Message édité par the_fennec le 12-10-2026 à 08:11:25

---------------
Faudra que je teste un jour :o
n°53131
moyen_moin​s
chat réincarné
Posté le 12-10-2026 à 13:21:18  profilanswer
 

the_fennec a écrit :

Strata pour GLM 5.3:
https://github.com/mw00/project-maya
 

Citation :


Maya runs GLM-5.3-Flash (zai-org, MIT license) on the hardware you already have: 321 B parameters, about 18 B active per token, and a context of up to 1 M tokens. Its engine is built for this one model.  
 
What you need
 
GPU  NVIDIA, compute capability 7.0 or newer (V100, RTX 20 and newer): one, or up to 16 that share the model. More VRAM is faster. AMD (experimental): RX 7900 XT / XTX, Radeon AI PRO R9700 / RX 9070, Strix Halo and Gorgon Halo (Radeon 8060S / 8065S), text only - docs/AMD_MAYA.md
RAM  32 GB runs it. More RAM keeps more experts close and is faster
Disk  A fast NVMe SSD with room for the model (~100 GB for Maya-S, ~160 GB for Maya-L) and its picture encoder (1.1 GB). Not a hard disk


 :pt1cable: :love: faut que je teste ça aussi :o
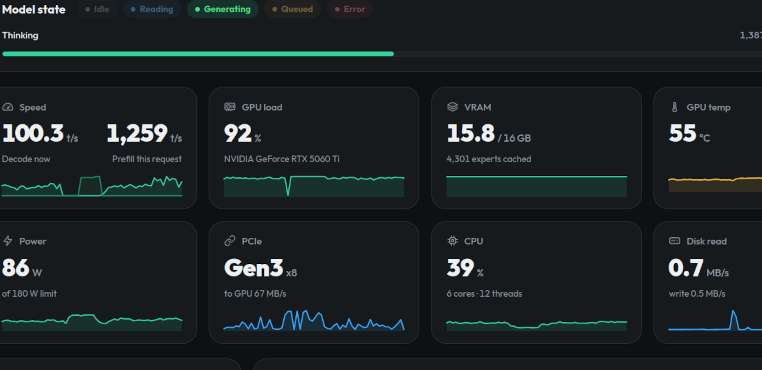

bordel :love:
un de mes modèles préférés :D
en plus, sous linux, je pourrais cumuler la 9070XT et la 9700 pro alors que sous windows, vaut clairement mieux éviter :o

n°53132
moyen_moin​s
chat réincarné
Posté le 12-10-2026 à 13:32:49  profilanswer
 

the_fennec a écrit :

J'ai eu des pointes a 129 en génération :love: avec une 4060Ti c'est incroyable!
Ça va être difficile de revenir à autre chose!


Mon SSD c'est un SATA, mais il sert pas beaucoup.


Passer a 200k de contexte et Claude configuré a 150k, j'ai plus de soucis de thrashing.


La ça fait plus de 11h qu'il bosse pour me trouver une nouvelle chaise de bureau, on verra bien si c'est mieux que pour les GPUs. (il est arrivé aux même conclusions que le reste de la terre, ya pas de bon plans pour 16GB/32GB :()


sur du iq2 ? ou plus gros ?
les pointes, je trouve ça étrange, ça peut monter à 80+ en iq3_s mais ça peut aussi descendre à 20, c'est beaucoup moins stable que llama.cpp.
au final avec 224K de contexte, ça donne 320-330 t/s pp et 40-50 t/s tg.
c'est utilisable, bien plus que 27B :)


edit: a priori mon pp est bas voire très bas.
lien pcie qui bride ? RAM ? [:paysan]


edit²: problème BP du bus pcie, faut que je trouve une cm X570 qui propose le split du 16X pcie 4.0

Message cité 1 fois
Message édité par moyen_moins le 12-10-2026 à 15:12:01
n°53144
the_fennec
f3nn3cUs z3rd4
Posté le 12-10-2026 à 16:09:04  profilanswer
 

moyen_moins a écrit :


bordel :love:
un de mes modèles préférés :D
en plus, sous linux, je pourrais cumuler la 9070XT et la 9700 pro alors que sous windows, vaut clairement mieux éviter :o


Bon, pas de miracle, ça charge pas chez moi, a un moment j'étais en "tuning" a 0.7 tg/s :lol:  
 

moyen_moins a écrit :


sur du iq2 ? ou plus gros ?
les pointes, je trouve ça étrange, ça peut monter à 80+ en iq3_s mais ça peut aussi descendre à 20, c'est beaucoup moins stable que llama.cpp.
au final avec 224K de contexte, ça donne 320-330 t/s pp et 40-50 t/s tg.
c'est utilisable, bien plus que 27B :)
 
edit: a priori mon pp est bas voire très bas.
lien pcie qui bride ? RAM ? [:paysan]
 
edit²: problème BP du bus pcie, faut que je trouve une cm X570 qui propose le split du 16X pcie 4.0


Je suis en Q2, le plus petit (après coders) et le plus rapide. Je suis en pcie 3 8x.


---------------
Faudra que je teste un jour :o
n°53146
moyen_moin​s
chat réincarné
Posté le 12-10-2026 à 17:41:57  profilanswer
 

the_fennec a écrit :


Je suis en Q2, le plus petit (après coders) et le plus rapide. Je suis en pcie 3 8x.


pcie 3.0 2x sur la 9700pro, ça limite le streaming (max 2GB/s vs ton 8GB/s), la carte doit se tourner les pouces [:tinostar]

n°53152
the_fennec
f3nn3cUs z3rd4
Posté le 12-10-2026 à 19:16:25  profilanswer
 

moyen_moins a écrit :


pcie 3.0 2x sur la 9700pro, ça limite le streaming (max 2GB/s vs ton 8GB/s), la carte doit se tourner les pouces [:tinostar]


Oui, enfin avec 32GB de VRAM ya moins besoin de streamer :D


---------------
Faudra que je teste un jour :o
n°53186
neo world
Posté le 13-10-2026 à 10:30:10  profilanswer
 

Violence en ce mardi matin :
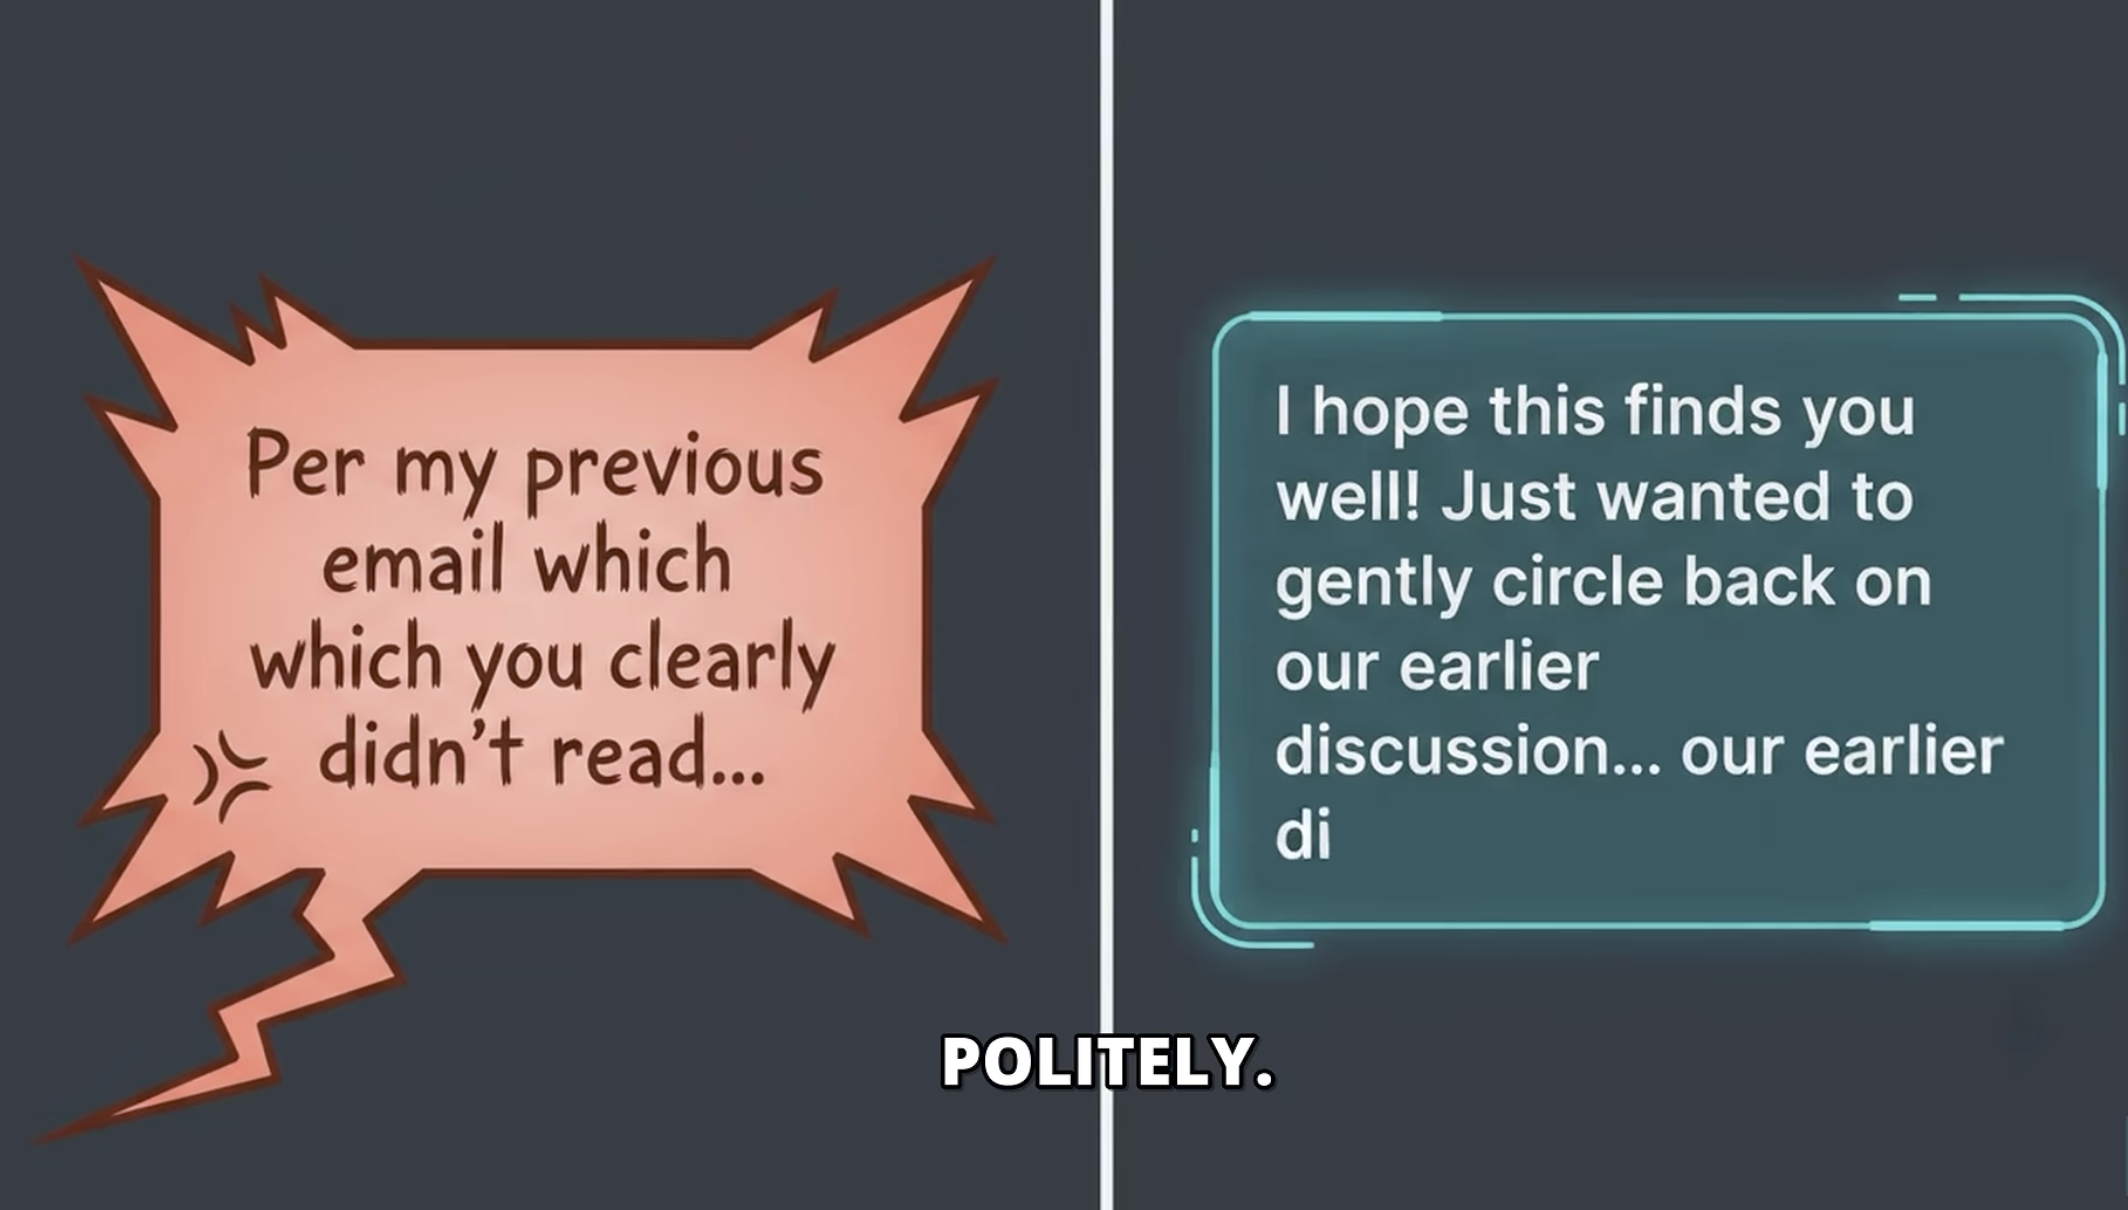
https://www.youtube.com/watch?v=se5fzkZoPZA
 
https://rehost.diberie.com/Picture/Get/f/561523
 
 
Je quote :
"borrowing memory from the storage which is the equivalent of fixing a small kitchen by cooking in the garage"  
"the first thing you read is never the reply but the speed in tokens / second"
"free is a dangerous price for someone with a fast connection"
 
La blague du screenshot m'en rappel une bonne aux débuts de la complétion de mail automatique au boulot : tu commençais ton mail avec " I hope this email finds you" et l'IA proposait à certains de compléter avec "before I do"  [:aka44]  :lol:


Message édité par neo world le 13-10-2026 à 10:31:43
n°53201
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 11:02:35  profilanswer
 

Haha pas mal :)


---------------
Faudra que je teste un jour :o
n°53202
moyen_moin​s
chat réincarné
Posté le 13-10-2026 à 11:10:42  profilanswer
 

the_fennec a écrit :


Oui, enfin avec 32GB de VRAM ya moins besoin de streamer :D


le PP sur une 9070XT c'est dans les ~1000t/s, je dépasse à peine les 300 [:tinostar]

n°53208
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 12:16:12  profilanswer
 

Post un screen!
 
Si tu veux je peux t'échanger ma 4060TI qui arrache contre ta 9700pro :o
 
https://i.imgur.com/lKtOdzp.png


Message édité par the_fennec le 13-10-2026 à 12:17:57

---------------
Faudra que je teste un jour :o
n°53209
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 12:25:09  profilanswer
 

Projet en cours: j'ai mis claude/strata/qwen a créer un truc un peu WTF :o
Je veux monter mes BC250 comme des GPUs locaux dans ma VM Linux. J'ai dis de faire un bridge Vulkan/UDP avec un shim local qui réplique tous les appels a l'API à distance.
Comme ça j'aurais mes 3 GPU vu comme des cartes locale par Vulkan et je pourrais utiliser Strata ou llama.cpp sans modifs.
 
Ça a peu de chances de bien marcher, mais OSEF ça tourne en local :D

Message cité 2 fois
Message édité par the_fennec le 13-10-2026 à 12:25:48

---------------
Faudra que je teste un jour :o
n°53210
neo world
Posté le 13-10-2026 à 12:31:03  profilanswer
 

the_fennec a écrit :

Projet en cours: j'ai mis claude/strata/qwen a créer un truc un peu WTF :o
Je veux monter mes BC250 comme des GPUs locaux dans ma VM Linux. J'ai dis de faire un bridge Vulkan/UDP avec un shim local qui réplique tous les appels a l'API à distance.
Comme ça j'aurais mes 3 GPU vu comme des cartes locale par Vulkan et je pourrais utiliser Strata ou llama.cpp sans modifs.
 
Ça a peu de chances de bien marcher, mais OSEF ça tourne en local :D


il te faut du RDMA :jap:
 
mais c'est gros projet  [:atom1ck] et idéalement tu veux tout connecter en 40gb/s au moins  [:catalonix:10] Y'a de l'USB 4 sur le bc250 ?  

n°53212
moyen_moin​s
chat réincarné
Posté le 13-10-2026 à 13:09:53  profilanswer
 

the_fennec a écrit :

Projet en cours: j'ai mis claude/strata/qwen a créer un truc un peu WTF :o
Je veux monter mes BC250 comme des GPUs locaux dans ma VM Linux. J'ai dis de faire un bridge Vulkan/UDP avec un shim local qui réplique tous les appels a l'API à distance.
Comme ça j'aurais mes 3 GPU vu comme des cartes locale par Vulkan et je pourrais utiliser Strata ou llama.cpp sans modifs.


Ça a peu de chances de bien marcher, mais OSEF ça tourne en local :D


c'est pas idiot même si ça fait un peu comme du llama.cpp en RPC non ?


edit: je pense que je vais mettre strata et qwen sur revanced et la refonte des patchs anti pub pour YT :o

 
neo world a écrit :


il te faut du RDMA :jap:


mais c'est gros projet  [:atom1ck] et idéalement tu veux tout connecter en 40gb/s au moins  [:catalonix:10] Y'a de l'USB 4 sur le bc250 ?  


déjà du 10gb/s ça doit être plus sympa que du gigabit :D

Message cité 2 fois
Message édité par moyen_moins le 13-10-2026 à 13:12:07
n°53216
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 14:02:17  profilanswer
 

neo world a écrit :


il te faut du RDMA :jap:
 
mais c'est gros projet  [:atom1ck] et idéalement tu veux tout connecter en 40gb/s au moins  [:catalonix:10] Y'a de l'USB 4 sur le bc250 ?  


Ça aiderait mais trop chère, j'essaye de me retenir de mettre plus de sous et de faire avec ce que j'ai.
Je voudrais 128GB de RAM, des GPUs en plus, etc.
 
Ya que de l'USB3 et un pcie 1x. Je me disait qu'on doit pouvoir faire du USB to USB ou pcie to pcie :o
Mais bon, je dois remettre le 2.5GB, mais pour ça il faut que je répare/change ma carte 10GB et aussi que j'adapte mon switch pour survivre au SPF+ Ethernet qui chauffe a mort.
 

moyen_moins a écrit :


c'est pas idiot même si ça fait un peu comme du llama.cpp en RPC non ?
 
edit: je pense que je vais mettre strata et qwen sur revanced et la refonte des patchs anti pub pour YT :o
 
déjà du 10gb/s ça doit être plus sympa que du gigabit :D


C'est comme le RPC mais plus bas niveau, pas besoin que l'app le supporte, et pas besoin de build/update les nœuds.
 
L'intérêt du RDMA c'est pas la BP, mais l'accès direct a la mémoire, en gros tu peux écrire/lire directement sur le réseau sans passer par le CPU et ça donne une bien meilleure latence.


---------------
Faudra que je teste un jour :o
n°53224
neo world
Posté le 13-10-2026 à 15:01:43  profilanswer
 

the_fennec a écrit :


Ça aiderait mais trop chère, j'essaye de me retenir de mettre plus de sous et de faire avec ce que j'ai.
Je voudrais 128GB de RAM, des GPUs en plus, etc.
 
Ya que de l'USB3 et un pcie 1x. Je me disait qu'on doit pouvoir faire du USB to USB ou pcie to pcie :o
Mais bon, je dois remettre le 2.5GB, mais pour ça il faut que je répare/change ma carte 10GB et aussi que j'adapte mon switch pour survivre au SPF+ Ethernet qui chauffe a mort.


On en est au même point. Je commençais à lorgner sur un second strix halo ou le gorgon alors j'ai vite réservé des vacances au bord de la mer avec la famille pour pas craquer  [:didier frogba:5] :D
 
Donc je pense que même 128GB de RAM tu continueras à lorgner plus haut en mode :
https://external-content.duckduckgo.com/iu/?u=https%3A%2F%2Ftse1.mm.bing.net%2Fth%2Fid%2FOIP.qBo0Zp_0stRdIRsEAcX3kgAAAA%3Fpid%3DApi&f=1&ipt=a4bb63828004dcce487017b6ec03621adc8cd548f1a8713d31908efbc35fdb90&ipo=images

n°53225
neo world
Posté le 13-10-2026 à 15:05:52  profilanswer


moyen_moins a écrit :


déjà du 10gb/s ça doit être plus sympa que du gigabit :D


la diff en bande passante est énorme c'est vrai mais par rapport au PCI express natif ça reste vraiment limite :jap:


Message édité par neo world le 13-10-2026 à 15:06:10
n°53226
speedboyz3​0
Guide Michelin :o
Posté le 13-10-2026 à 15:10:57  profilanswer
 

Ouais vouloir toujours plus c'est la plaie :o  
 
Bien vu d'avoir booké des vacances !
 
Ici je me dis qu'avec mon mac studio, dans 2/3 ans si je veux plus j'ai 2 solutions :
 
Soit je le refile chez la pomme et j'upgrade :o
Soit je lui chope un ptit frer à pas cher d'un mec qui upgradera :o

n°53227
moyen_moin​s
chat réincarné
Posté le 13-10-2026 à 15:12:05  profilanswer
 

on est sur de l'équivalent pcie 3.0 &x en 10gb/s non en terme de débit ?
c'est vrai que c'est pas ouf :D
 
je lorgne sur 64GB ou une 2ème 9700pro mais faut que je change de carte mère d'abord.

n°53230
neo world
Posté le 13-10-2026 à 15:20:10  profilanswer
 

moyen_moins a écrit :

on est sur de l'équivalent pcie 3.0 &x en 10gb/s non en terme de débit ?
c'est vrai que c'est pas ouf :D


je lorgne sur 64GB ou une 2ème 9700pro mais faut que je change de carte mère d'abord.


10gb/s (ethernet) c'est environ une ligne de pci express 3.0


c'est pas beaucoup beaucoup  [:sid sidious:1]


edit : je viens de traduire ton & avec mon clavier. Donc oui c'est bien ça :o


Message édité par neo world le 13-10-2026 à 15:24:28
n°53231
neo world
Posté le 13-10-2026 à 15:23:43  profilanswer
 

speedboyz30 a écrit :

Ouais vouloir toujours plus c'est la plaie :o  
 
Bien vu d'avoir booké des vacances !
 
Ici je me dis qu'avec mon mac studio, dans 2/3 ans si je veux plus j'ai 2 solutions :
 
Soit je le refile chez la pomme et j'upgrade :o
Soit je lui chope un ptit frer à pas cher d'un mec qui upgradera :o


Clairement le second sera intéressant entre le port thunderbolt à 120gb/s et globalement le fait que les clusters de mac sont bien balisés :D
 
Mais bon on verra d'ici là. Les modèles 26B ont fait des progrès juste démentiels en 10 mois. Ca se trouve t'auras ton claude opus 5.5 dans un an dans une taille similaire (redface ou pas ? j'hésite :D )

Message cité 2 fois
Message édité par neo world le 13-10-2026 à 16:07:52
n°53235
neo world
Posté le 13-10-2026 à 15:53:15  profilanswer
 

sinon je suis en train de télécharger https://huggingface.co/huihui-ai/Hu [...] ed-v2-GGUF en UD Q4 K XL pour l'héberger avec gufo. Je vous tiens au courant si ça semble être un bon modèle non censuré :jap:

Message cité 1 fois
Message édité par neo world le 13-10-2026 à 15:54:00
n°53241
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 16:48:53  profilanswer
 

neo world a écrit :

On en est au même point. Je commençais à lorgner sur un second strix halo ou le gorgon alors j'ai vite réservé des vacances au bord de la mer avec la famille pour pas craquer  [:didier frogba:5] :D
 
Donc je pense que même 128GB de RAM tu continueras à lorgner plus haut en mode :
https://external-content.duckduckgo [...] ipo=images


Après je fais ça pour m'amuser et apprendre, coté IA j'ai largement ce qu'il faut avec le taf' et en perso. Donc acheter du matos c'est tricher :o


---------------
Faudra que je teste un jour :o
n°53242
speedboyz3​0
Guide Michelin :o
Posté le 13-10-2026 à 17:00:04  profilanswer
 

neo world a écrit :

Mais bon on verra d'ici là. Les modèles 26B ont fait des progrès juste démentiels en 10 mois. Ca se trouve t'auras ton claude opus 5.5 dans un an dans une taille similaire (redface ou pas ? j'hésite :D )


J'ai hâte [:arrakys]

n°53244
the_fennec
f3nn3cUs z3rd4
Posté le 13-10-2026 à 17:23:06  profilanswer
 

neo world a écrit :

Clairement le second sera intéressant entre le port thunderbolt à 120gb/s et globalement le fait que les clusters de mac sont bien balisés :D


Mais au final est-ce qu'on a besoin de tant de BP que ça? Même en passant en mode tensor RPC le 27B la BP était pas haute que ça, mais la latence tue tout.
 
Quand j'avais testé en 2.5Gbps j'ai pas noté de différence de perf.
 

neo world a écrit :


Mais bon on verra d'ici là. Les modèles 26B ont fait des progrès juste démentiels en 10 mois. Ca se trouve t'auras ton claude opus 5.5 dans un an dans une taille similaire (redface ou pas ? j'hésite :D )


La prochain Qwen4 35BA3B (ou équivalent) va être un massacre je pense, surtout si on a un "Strata" like pour le servir. Même llama.cpp déboîte bien avec le 35B. Ya moyen d'avoir les même perfs que 35B avec la qualité du 27B :love: genre avec 8GB de VRAM et 16GB de RAM!.

Message cité 2 fois
Message édité par the_fennec le 13-10-2026 à 17:23:47

---------------
Faudra que je teste un jour :o
n°53246
neo world
Posté le 13-10-2026 à 17:32:43  profilanswer
 

the_fennec a écrit :


Mais au final est-ce qu'on a besoin de tant de BP que ça? Même en passant en mode tensor RPC le 27B la BP était pas haute que ça, mais la latence tue tout.
 
Quand j'avais testé en 2.5Gbps j'ai pas noté de différence de perf.


le problème est bien la latence : quand la bande passante sature elle explose. Diminuer la vitesse des échanges revient à augmenter la latence des échanges. Les deux sont importants et interdépendants :jap:

 Page :   1  2  3  4  5  ..  79  80  81  82  83  84

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)