Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5389 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  72  73  74  75  76  77
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°50518
Pipould's
Posté le 24-09-2026 à 08:15:44  profilanswer
 

Reprise du message précédent :

tfpsly a écrit :

Un Qwen 3.8 27B en 11,8gb https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
Je le teste depuis plusieurs heures : il a l'air de fonctionner aussi bien que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW (ressenti, pas une mesure scientifique) - mais en libérant presque 1gb, ce qui permet de bien augmenter la taille du contexte. Utile pour du développement assez poussé.


Tu as combien de context dispo sur 16GB ?  :jap:

n°50536
tfpsly
Sly
Posté le 24-09-2026 à 09:34:38  profilanswer
 

Contexte 100k, mais il reste de la VRAM dispo. J'ai pu re activer l'accélération hardware de Firefox.
 
Dans l'onglet Community (47 commentaires), qq1 propose une ligne de commande avec MTP 3 et contexte 128k.


Message édité par tfpsly le 24-09-2026 à 09:40:06
n°50538
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 09:46:57  profilanswer
 

tfpsly a écrit :

Un Qwen 3.8 27B en 11,8gb https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
Je le teste depuis plusieurs heures : il a l'air de fonctionner aussi bien que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW (ressenti, pas une mesure scientifique) - mais en libérant presque 1gb, ce qui permet de bien augmenter la taille du contexte. Utile pour du développement assez poussé.


J'ai testé ya un moment, mais au bout d'un moment j'avais une boucle et il générait plus que des ///////////
J'ai eu le même soucis avec sa version de Qwen Flash Next.


---------------
Faudra que je teste un jour :o
n°50540
neo world
Posté le 24-09-2026 à 09:55:18  profilanswer
 

y'a un modèle "chouchou" sur une carte avec 8GB de VRAM ?  
 
j'ai mon laptop de gaming qui fou rien (enfants en bas âge tout ça  :pt1cable: ) avec un 12700 / 32GB ddr5 et une 3070ti (de laptop) qui pourrait peut être faire tourner du tooling ou une sous routine si y'a un p'tit modèle qui peut fonctionner dessus :D
 
usages en tête :
=> chat avec l'utilisateur quand le Strix Halo chauffe sur une autre tâche (avec des droits de lecture des fichiers des sessions en cours). Il faut que tout tienne en vram
=> résumé d'articles de sites web pour un morning briefing (osef de la vitesse la qualité prime un peu)
=> soyons fous : revue de code avec OCR histoire de mettre le bordel au strix halo avec un modele inférieur qui hallucine pleine balle ou avec gros modèle lent en dépannage ?

n°50543
tfpsly
Sly
Posté le 24-09-2026 à 10:03:14  profilanswer
 

the_fennec a écrit :


J'ai testé ya un moment, mais au bout d'un moment j'avais une boucle et il générait plus que des ///////////
J'ai eu le même soucis avec sa version de Qwen Flash Next.


Pas eu ce pb. Je fais tourner pi avec deux plug-ins empêchant les boucles (installé quand un précédent modèle Qwen tournait en rond à lire un fichier puis un autre puis.. puis re le premier...).


EDIT - les plugins que j'utilise dans pi :

Code :
  1. # Prevents tool-call loops and handles context runaway automatically
  2. pi install npm:@capdiem/pi-repetition-guard
  3. # Breaks thinking loops and sanitizes repetitive context turns
  4. pi install npm:pi-loop-police
  5. # Auto continue after error or failed context compaction
  6. pi install npm:pi-vigilant

Message cité 2 fois
Message édité par tfpsly le 24-09-2026 à 10:28:50
n°50545
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-09-2026 à 10:06:22  profilanswer
 

neo world a écrit :

y'a un modèle "chouchou" sur une carte avec 8GB de VRAM ?


j'ai mon laptop de gaming qui fou rien (enfants en bas âge tout ça  :pt1cable: ) avec un 12700 / 32GB ddr5 et une 3070ti (de laptop) qui pourrait peut être faire tourner du tooling ou une sous routine si y'a un p'tit modèle qui peut fonctionner dessus :D


usages en tête :
=> chat avec l'utilisateur quand le Strix Halo chauffe sur une autre tâche (avec des droits de lecture des fichiers des sessions en cours). Il faut que tout tienne en vram
=> résumé d'articles de sites web pour un morning briefing (osef de la vitesse la qualité prime un peu)
=> soyons fous : revue de code avec OCR histoire de mettre le bordel au strix halo avec un modele inférieur qui hallucine pleine balle ou avec gros modèle lent en dépannage ?


Une petite machine qui sert que pour l'ocr c'est pas mal.
Quand j'ai des gros batch j'ai une des bc250 qui sert que a ça dans le workflow.
Sinon le dernier qwen image 2.1 j'ai vus des models en 4gb passer


---------------
Victime de girafophobie, mais se soigne.
n°50556
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 10:48:32  profilanswer
 

neo world a écrit :

y'a un modèle "chouchou" sur une carte avec 8GB de VRAM ?  
 
j'ai mon laptop de gaming qui fou rien (enfants en bas âge tout ça  :pt1cable: ) avec un 12700 / 32GB ddr5 et une 3070ti (de laptop) qui pourrait peut être faire tourner du tooling ou une sous routine si y'a un p'tit modèle qui peut fonctionner dessus :D
 
usages en tête :
=> chat avec l'utilisateur quand le Strix Halo chauffe sur une autre tâche (avec des droits de lecture des fichiers des sessions en cours). Il faut que tout tienne en vram
=> résumé d'articles de sites web pour un morning briefing (osef de la vitesse la qualité prime un peu)
=> soyons fous : revue de code avec OCR histoire de mettre le bordel au strix halo avec un modele inférieur qui hallucine pleine balle ou avec gros modèle lent en dépannage ?


Un Qwen 35B?  
 

tfpsly a écrit :


Pas eu ce pb. Je fais tourner pi avec deux plug-ins empêchant les boucles (installé quand un précédent modèle Qwen tournait en rond à lire un fichier puis un autre puis.. puis re le premier...).
 
EDIT - les plugins que j'utilise dans pi :

Code :
  1. # Prevents tool-call loops and handles context runaway automatically
  2. pi install npm:@capdiem/pi-repetition-guard
  3. # Breaks thinking loops and sanitizes repetitive context turns
  4. pi install npm:pi-loop-police
  5. # Auto continue after error or failed context compaction
  6. pi install npm:pi-vigilant


J'avais ça avec little-coder, mais au final quand ton modèle part en couille, ça sert a rien ce genre de trucs, c'est que ton contexte est pourris et il reviendra pas dans la bonne direction.
 
Après j'ai ce soucis quand le prompt tourne longtemps, genre 20h+. Mais je trouve que c'est une bonne indication qu'il y a un soucis a long terme.


---------------
Faudra que je teste un jour :o
n°50587
moyen_moin​s
chat réincarné
Posté le 24-09-2026 à 13:41:31  profilanswer
 

the_fennec a écrit :


J'avais ça avec little-coder, mais au final quand ton modèle part en couille, ça sert a rien ce genre de trucs, c'est que ton contexte est pourris et il reviendra pas dans la bonne direction.


Après j'ai ce soucis quand le prompt tourne longtemps, genre 20h+. Mais je trouve que c'est une bonne indication qu'il y a un soucis a long terme.


j'ai eu 10h+ de génération avec le gsq rco 27B et à la limite, ce que je peux lui reprocher, c'est plus la qualité du raisonnement (enfin, ça, je l'ai vu dans le doc de sortie...) [:transparency]
j'avais laissé le thinking "ON" mais j'étais passé en température 0.7, en temp = 1 je trouve qu'il tourne trop facilement en rond.


edit: j'ai retesté rapido hier soir un UD3 d'unsloth avec un llama.cpp récent (dernière ou avant dernière release) mais j'ai du me chier la config, il charge mais au 1er message, le modèle crash et se vide de la VRAM.

Message cité 1 fois
Message édité par moyen_moins le 24-09-2026 à 13:43:34
n°50592
lapin
Posté le 24-09-2026 à 14:28:23  profilanswer
 

the_fennec a écrit :


encore LMstudio :( ils doivent avoir une version de llama.cpp qui a 1000 ans qui supporte pas un des quants d'un layer K_L de Swift.
Tu perds vraiment ton temps (et celui de ton CPU) avec ce soft moisi...


Version du moteur de LLama.cpp de LMSTUDIO est actuellement:
 

Vulkan llama.cpp (Windows): v2.44.0
 
Vulkan accelerated llama.cpp engine
 
- llama.cpp release b11139 (commit 42916d83f)


Citation :


{
  "extension_type": "engine",
  "domains": [
    "llm",
    "embedding"
  ],
  "engine": "llama.cpp",
  "target_libraries": [
    {
      "name": "llm_engine_vulkan.node",
      "type": "llm_engine",
      "version": "0.1.2"
    },
    {
      "name": "liblmstudio_bindings_vulkan.node",
      "type": "liblmstudio",
      "version": "0.2.26"
    }
  ],
  "supported_model_formats": [
    "gguf"
  ],
  "engine_protocol_server": {
    "runtime_kind": "llama-server",
    "executable_relative_path": "llama-server.exe"
  },
  "name": "llama.cpp-win-x86_64-vulkan-avx2",
  "version": "2.44.0",
  "platform": "win",
  "cpu": {
    "architecture": "x86_64",
    "instruction_set_extensions": [
      "AVX2"
    ]
  },
  "gpu": {
    "framework": "Vulkan"
  },
  "manifest_version": "4",
  "minimum_lmstudio_version": "0.4.0+15",
  "minimum_llmster_version": "0.0.1+9",
  "vendor_lib_package_names": [
    "win-llama-vulkan-vendor-v2"
  ]
}


b11139 ça doit correspondre à celle-ci: https://github.com/ggml-org/llama.c [...] ase-b11139
github-actions released this 20 hours ago
 
Donc 20 heures c'est antédiluvien, d'accord !!!!

n°50593
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 24-09-2026 à 14:34:01  profilanswer
 

Les vrais tournent avec un fork personnalisé


---------------
Victime de girafophobie, mais se soigne.
n°50597
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 15:19:19  profilanswer
 

moyen_moins a écrit :


j'ai eu 10h+ de génération avec le gsq rco 27B et à la limite, ce que je peux lui reprocher, c'est plus la qualité du raisonnement (enfin, ça, je l'ai vu dans le doc de sortie...) [:transparency]  
j'avais laissé le thinking "ON" mais j'étais passé en température 0.7, en temp = 1 je trouve qu'il tourne trop facilement en rond.
 
edit: j'ai retesté rapido hier soir un UD3 d'unsloth avec un llama.cpp récent (dernière ou avant dernière release) mais j'ai du me chier la config, il charge mais au 1er message, le modèle crash et se vide de la VRAM.


Ya des flags qui ont changés, t'as quoi comme erreur?
 

lapin a écrit :


Version du moteur de LLama.cpp de LMSTUDIO est actuellement:
 

Vulkan llama.cpp (Windows): v2.44.0
 
Vulkan accelerated llama.cpp engine
 
- llama.cpp release b11139 (commit 42916d83f)


Citation :


{
...
  "name": "llama.cpp-win-x86_64-vulkan-avx2",
  "version": "2.44.0",
...
}


b11139 ça doit correspondre à celle-ci: https://github.com/ggml-org/llama.c [...] ase-b11139
github-actions released this 20 hours ago
 
Donc 20 heures c'est antédiluvien, d'accord !!!!


Il n'y a pas de build "llama.cpp-win-x86_64-vulkan-avx2" et LMSTUDIO est closed source (pas tout, mais le UI/moteur n'est pas dispo). LMSTUDIO a son propre build de llama.cpp et il ne correspond pas aux sources officielles. UD3 a été ajouté il y a plus d'un mois, ça devrait marcher depuis le temps.
 
moyen_moins n'est pas le premier a avoir des soucis avec LMSTUDIO, en tout cas chez moi ça marche :o


---------------
Faudra que je teste un jour :o
n°50598
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 15:20:04  profilanswer
 

Tronklou a écrit :

Les vrais tournent avec un fork personnalisé


Je suis en train de bosser la dessus :o


---------------
Faudra que je teste un jour :o
n°50601
SynE
Agri du dessert
Posté le 24-09-2026 à 15:48:15  profilanswer
 

Donc sinon quel modele MoE je dois utiliser sur du cpu avec 192Go et 384Go ? Parce que l'ia me sort des trucs qui ne passent pas ou chargent plus de ram que "prévu"
 
avec llama.cpp bien sur, je ne vois pas l'intérêt de mettre autre chose pour ce que ça va faire :o

n°50605
moyen_moin​s
chat réincarné
Posté le 24-09-2026 à 16:23:39  profilanswer
 

the_fennec a écrit :


Ya des flags qui ont changés, t'as quoi comme erreur?


je regarderai ça demain, je passe par un gui pour config tout ça [:cupra]

the_fennec a écrit :


Il n'y a pas de build "llama.cpp-win-x86_64-vulkan-avx2" et LMSTUDIO est closed source (pas tout, mais le UI/moteur n'est pas dispo). LMSTUDIO a son propre build de llama.cpp et il ne correspond pas aux sources officielles. UD3 a été ajouté il y a plus d'un mois, ça devrait marcher depuis le temps.
 
moyen_moins n'est pas le premier a avoir des soucis avec LMSTUDIO, en tout cas chez moi ça marche :o


j'avoue ça commence un peu à me souler mais en 1er pas en local, ça reste très pratique :)
et faut que je vérifie si llamaserver fonctionne en local sur mon poc : d'une pierre 2 coups.

n°50607
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 16:39:57  profilanswer
 

SynE a écrit :

Donc sinon quel modele MoE je dois utiliser sur du cpu avec 192Go et 384Go ? Parce que l'ia me sort des trucs qui ne passent pas ou chargent plus de ram que "prévu"
 
avec llama.cpp bien sur, je ne vois pas l'intérêt de mettre autre chose pour ce que ça va faire :o


Utilise ik_llama.cpp, pas llama.cpp.
 
Un 35B devrait passer, mais peut être un DS4 ou Qwen 3.8 Next pour le fun :o


---------------
Faudra que je teste un jour :o
n°50608
moyen_moin​s
chat réincarné
Posté le 24-09-2026 à 16:42:15  profilanswer
 

the_fennec a écrit :


Je suis en train de bosser la dessus :o


j'avais fait ça sur le bc-250 (enfin, pas moi, l'ia l'avait fait pour moi) :o

n°50609
moyen_moin​s
chat réincarné
Posté le 24-09-2026 à 16:47:28  profilanswer
 

the_fennec a écrit :


Utilise ik_llama.cpp, pas llama.cpp.
 
Un 35B devrait passer, mais peut être un DS4 ou Qwen 3.8 Next pour le fun :o


les performances avec ce ik_llama sont réellement supérieures ? [:transparency]

n°50610
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 16:47:30  profilanswer
 

moyen_moins a écrit :


j'avais fait ça sur le bc-250 (enfin, pas moi, l'ia l'avait fait pour moi) :o


Moi je veux ça:
RPC: add -sm tensor
https://github.com/ggml-org/llama.cpp/pull/26610


---------------
Faudra que je teste un jour :o
n°50611
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 16:54:23  profilanswer
 

moyen_moins a écrit :


les performances avec ce ik_llama sont réellement supérieures ? [:transparency]


Je sais pas, mais en tout cas c'est écris dans le titre!
Le fait que le fork ait plus de 2 ans et soit toujours actif me fait penser que c'est pas juste un vibeslop :o
 
Sinon ya aussi https://github.com/JustVugg/colibri a regarder :D


---------------
Faudra que je teste un jour :o
n°50613
moyen_moin​s
chat réincarné
Posté le 24-09-2026 à 17:17:17  profilanswer


pas sûr de tout comprendre [:cupra]
c'est pour remplacer le split ? pour que ça tourne en // et pas en série (ou un truc comme ça) ?

n°50619
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 18:10:53  profilanswer
 

moyen_moins a écrit :


pas sûr de tout comprendre [:cupra]
c'est pour remplacer le split ? pour que ça tourne en // et pas en série (ou un truc comme ça) ?


Oui c'est ça. Le mode RPC envoie un nombre de layers au premier nœud RPC, un autre au second, ... et a la fin le reste au server avec l'attention et les MoE. Tout se fait séquentiellement par batch (le ubatch). A un moment T il n'y a qu'nœud qui bosse (en PP) le TG est en parallèle il me semble.
 
Avec le mode tensor les layers sont slicés "verticalement" et tout peut se faire en parallèle. Le problème c'est qu'au d'envoyer une requête avec un seul batch, tu en envoie des tonnes et la latence est importante, il est conseillé d'utiliser RDMA.
 
Mais je me demande si dans mon cas, je gagnerais pas en vitesse de PP, je suis autour de 70/s avec Qwen4 :o. Je me demande aussi si la répartition serait pas plus facile, avec certains split j'ai que 10GB sur une carte et l'autre se bouffe 15GB.


Message édité par the_fennec le 24-09-2026 à 18:12:23

---------------
Faudra que je teste un jour :o
n°50620
neo world
Posté le 24-09-2026 à 18:11:56  profilanswer
 

Qwen4 et tu partages pas avec le tôlier ? :o

n°50621
the_fennec
f3nn3cUs z3rd4
Posté le 24-09-2026 à 18:15:00  profilanswer
 

neo world a écrit :

Qwen4 et tu partages pas avec le tôlier ? :o


OK mais tu le gardes pour toi:
https://tinyurl.com/bdfmwxdx
 

Spoiler :

Qwen 3.8 Next Flash, c'est qwen4exp.  :o


---------------
Faudra que je teste un jour :o
n°50642
tfpsly
Sly
Posté le 24-09-2026 à 21:41:19  profilanswer
 

the_fennec a écrit :


OK mais tu le gardes pour toi:
https://tinyurl.com/bdfmwxdx
 

Spoiler :

Qwen 3.8 Next Flash, c'est qwen4exp.  :o


Ou alors https://huggingface.co/unsloth/Qwen [...] /tree/main

n°50664
Pipould's
Posté le 25-09-2026 à 01:07:52  profilanswer
 

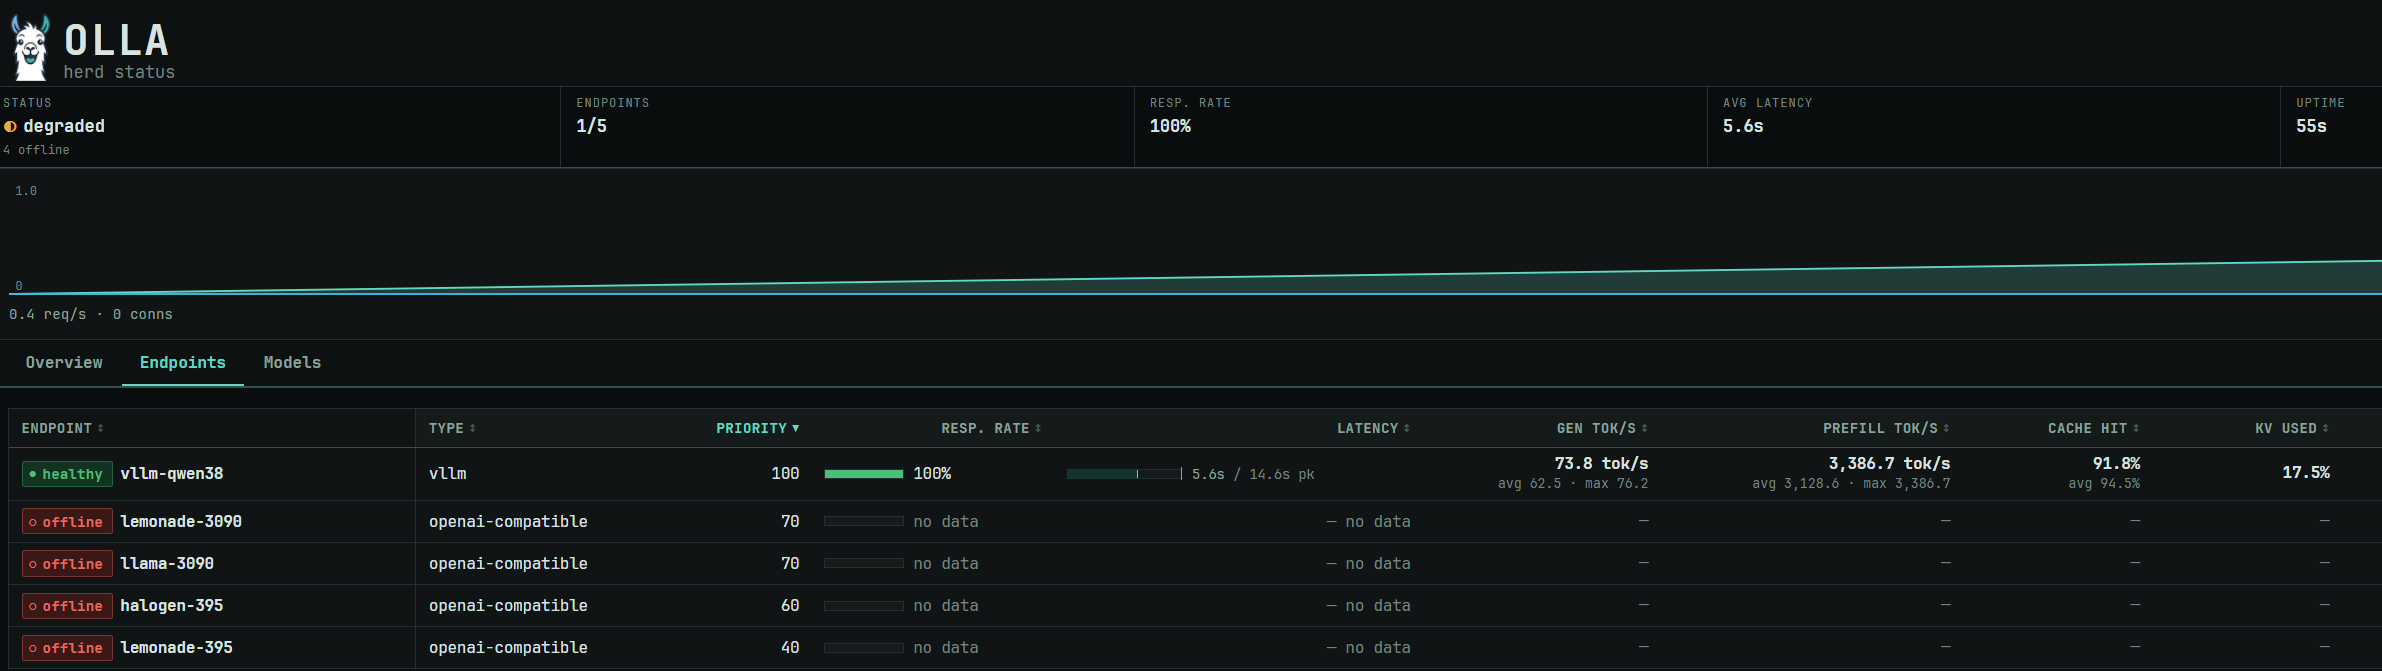
https://i.ibb.co/3m6jKStd/image.png


pi qui vibecode tout seul la visu des metrics des endpoints....  [:topac de canard]


Message édité par Pipould's le 25-09-2026 à 01:08:11
n°50687
tfpsly
Sly
Posté le 25-09-2026 à 08:33:31  profilanswer
 

tfpsly a écrit :


Pas eu ce pb. Je fais tourner pi avec deux plug-ins empêchant les boucles (installé quand un précédent modèle Qwen tournait en rond à lire un fichier puis un autre puis.. puis re le premier...).


EDIT - les plugins que j'utilise dans pi :

Code :
  1. # Prevents tool-call loops and handles context runaway automatically
  2. pi install npm:@capdiem/pi-repetition-guard
  3. # Breaks thinking loops and sanitizes repetitive context turns
  4. pi install npm:pi-loop-police
  5. # Auto continue after error or failed context compaction
  6. pi install npm:pi-vigilant


Bon finalement :

  • Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp a en effet des pbs; même si mon modèle ne se bloque pas dans une boucle infinie; mais les compaction de contexte finissent par toujours foirer, impossible de le faire travailler longtemps
  • Qwen3.8-27B-Uncensored-IQ4_XS_4BPW est une valeur sure; par contre contexte de 50k seulement, certains appels d'outils nécessitent plus et vont foirer.
  • Qwen3.8-27B-4.2BPW-16GB est mon préféré pour l'instant : ses couches de connaissance sont plus compressées, mais ses couches de logique restent similaires à Uncensored-IQ4_XS. Ce qui permet d'avoir un contexte de 120k.


Par contre si je pousse trop le contexte, ne gardant que quelques centaines de mb de VRAM libre, l'affichage de mon PC refuse parfois de sortir de veille - VRAM libre probablement trop fragmentée. Le LLM continue de bosser, mais sans affichage.

Message cité 2 fois
Message édité par tfpsly le 25-09-2026 à 08:35:14
n°50689
neo world
Posté le 25-09-2026 à 08:39:31  profilanswer
 

tfpsly a écrit :


Bon finalement :

  • Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp a en effet des pbs; même si mon modèle ne se bloque pas dans une boucle infinie; mais les compaction de contexte finissent par toujours foirer, impossible de le faire travailler longtemps
  • Qwen3.8-27B-Uncensored-IQ4_XS_4BPW est une valeur sure; par contre contexte de 50k seulement, certains appels d'outils nécessitent plus et vont foirer.
  • Qwen3.8-27B-4.2BPW-16GB est mon préféré pour l'instant : ses couches de connaissance sont plus compressées, mais ses couches de logique restent similaires à Uncensored-IQ4_XS. Ce qui permet d'avoir un contexte de 120k.


Par contre si je pousse trop le contexte, ne gardant que quelques centaines de mb de VRAM libre, l'affichage de mon PC refuse parfois de sortir de veille - VRAM libre probablement trop fragmentée. Le LLM continue de bosser, mais sans affichage.


Tu n’as pas un chipset vidéo basique sur la carte mère ou tu pourrais en ajouter un pour libérer totalement ta vram ? Je suis pas certain que ça vaille la peine d’aller chercher 50 mo mais si tu veux maximiser ta VRAM …

n°50702
tfpsly
Sly
Posté le 25-09-2026 à 09:53:27  profilanswer
 

Non. Et je préfère n'utiliser que mon GPU - pour le jeu, la VR, le dév de mon moteur 3D; et juste plus simple. Je baisserai le contexte size à 110k.
Mon contexte est déjà limité à 100k dans ma config pi.dev - je lui laisse une marge car parfois il dépasse sa limite en lançant d'autres outils (ça évite de les relancer après le compactage).


Message édité par tfpsly le 25-09-2026 à 10:00:14
n°50706
moyen_moin​s
chat réincarné
Posté le 25-09-2026 à 10:56:25  profilanswer
 

tfpsly a écrit :


Bon finalement :

  • Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp a en effet des pbs; même si mon modèle ne se bloque pas dans une boucle infinie; mais les compaction de contexte finissent par toujours foirer, impossible de le faire travailler longtemps
  • Qwen3.8-27B-Uncensored-IQ4_XS_4BPW est une valeur sure; par contre contexte de 50k seulement, certains appels d'outils nécessitent plus et vont foirer.
  • Qwen3.8-27B-4.2BPW-16GB est mon préféré pour l'instant : ses couches de connaissance sont plus compressées, mais ses couches de logique restent similaires à Uncensored-IQ4_XS. Ce qui permet d'avoir un contexte de 120k.


Par contre si je pousse trop le contexte, ne gardant que quelques centaines de mb de VRAM libre, l'affichage de mon PC refuse parfois de sortir de veille - VRAM libre probablement trop fragmentée. Le LLM continue de bosser, mais sans affichage.


c'est là qu'on voit qu'il faut mini 24Go de VRAM.
à moins, ça devient compliquer de faire des trucs "ambitieux" :(


Message édité par moyen_moins le 25-09-2026 à 10:56:37
n°50707
tfpsly
Sly
Posté le 25-09-2026 à 11:22:13  profilanswer
 

Bah je viens de dire que Qwen3.8-27B-4.2BPW-16GB passe très bien sur 16gb.
Par contre 3.8-Next / 4.0, ça va être plus que chaud...

Message cité 3 fois
Message édité par tfpsly le 25-09-2026 à 11:23:22
n°50712
the_fennec
f3nn3cUs z3rd4
Posté le 25-09-2026 à 11:58:08  profilanswer
 

tfpsly a écrit :

Bah je viens de dire que Qwen3.8-27B-4.2BPW-16GB passe très bien sur 16gb.
Par contre 3.8-Next / 4.0, ça va être plus que chaud...


En fait il a juste renommé l'ancien IQ3_M d'Unsloth, il s'en même pas fait chié a changer les metadata:
 
https://huggingface.co/hitsfmdj/Qwe [...] -16GB.gguf
https://i.imgur.com/s6AStVO.png
 
Et c'est pas 4.2BPW:
https://huggingface.co/hitsfmdj/Qwe [...] ation.json

Code :
  1. "label": "GGUF imatrix mix \u00b7 3.77 bpw (memory-lean)",


---------------
Faudra que je teste un jour :o
n°50713
tfpsly
Sly
Posté le 25-09-2026 à 12:06:06  profilanswer
 

Oooh bien vu.

n°50718
moyen_moin​s
chat réincarné
Posté le 25-09-2026 à 13:37:27  profilanswer
 

tfpsly a écrit :

Bah je viens de dire que Qwen3.8-27B-4.2BPW-16GB passe très bien sur 16gb.
Par contre 3.8-Next / 4.0, ça va être plus que chaud...


100k de contexte, ça peut être vite explosé et les compactions... :spamafote:

n°50723
the_fennec
f3nn3cUs z3rd4
Posté le 25-09-2026 à 15:48:30  profilanswer
 

Ya un truc que je comprenais pas avec llama.cpp. Je me fais chier a faire une config aux petit oignons, pour charger Qwen3.8-Flash-Next en UD-IQ3_XXS avec RPC, ça passe au poil de cul, j'ai des layers en CPU, OK.
 
Je fais la même avec juste -fit on, et pouf il me dit qu'il mets tout en GPU. J'avais des OOM avec UD-IQ4_XS jamais réussi a le charger, la pareil, avec -fit on ça passe...
 [:poogz:5]  
 

Code :
  1. ./llama-server --tools all -lv 4 --load-mode none --lazy-mode on --metrics --host 0.0.0.0 --port 8080 -m /mnt/glados/dev/models/Qwen3.8-Flash-Next-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf --alias default --rpc lain:50000,arisu:50000 --ctx-size 110000 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 -np 1 -t 6 --threads-batch 6 --jinja --chat-template-file /mnt/glados/dev/models/__qwen_template_froggeric.jinja --reasoning-format deepseek --reasoning-effort xhigh --kv-unified -ctk q8_0 -ctv q8_0 -fit on -b 2018 -ub 512


Et il donne ça:

Code :
  1. 0.10.716.052 I add: tensor per_layer_token_embd.weight (size = 27465 MiB) lazy read enabled
  2. 0.19.682.669 I load_tensors: offloading output layer to GPU
  3. 0.19.682.680 I load_tensors: offloading 47 repeating layers to GPU
  4. 0.19.682.681 I load_tensors: offloaded 49/49 layers to GPU
  5. 0.19.682.685 I load_tensors: RPC0[arisu:50000] model buffer size = 12884.97 MiB
  6. 0.19.682.687 I load_tensors: RPC0[lain:50000] model buffer size = 13264.25 MiB
  7. 0.19.682.688 I load_tensors:      Vulkan0 model buffer size = 12250.36 MiB
  8. 0.19.682.689 I load_tensors:  Vulkan_Host model buffer size = 23466.63 MiB
  9. 0.19.682.689 I load_tensors:   CPU_Mapped model buffer size = 27465.95 MiB


Mais en réalité on a la vrai répartition des layers avant:

Code :
  1. 0.10.307.142 I common_memory_breakdown_print: | memory breakdown [MiB]    | total    free     self   model   context   compute    unaccounted |
  2. 0.10.307.148 I common_memory_breakdown_print: |   - RPC0 (lain:50000)     | 15512 = 15465 + (14355 = 13264 +     285 +     806) +      -14309 |
  3. 0.10.307.149 I common_memory_breakdown_print: |   - RPC1 (arisu:50000)    | 15512 = 15472 + (14106 = 12884 +     407 +     813) +      -14066 |
  4. 0.10.307.149 I common_memory_breakdown_print: |   - Vulkan0 (RTX 4060 Ti) | 16626 = 16054 + (14999 = 12250 +     961 +    1787) +      -14427 |
  5. 0.10.307.149 I common_memory_breakdown_print: |   - Host                  |                  51110 = 50932 +       0 +     177                |
  6. 0.10.354.729 I common_params_fit_impl: memory for test allocation by device:
  7. 0.10.354.752 I common_params_fit_impl: id=0, n_layer=11, n_part= 1, overflow_type=1, mem= 14355 MiB
  8. 0.10.354.752 I common_params_fit_impl: id=1, n_layer=10, n_part= 1, overflow_type=3, mem= 14106 MiB
  9. 0.10.354.753 I common_params_fit_impl: id=2, n_layer=28, n_part=20, overflow_type=1, mem= 14999 MiB
  10. 0.10.354.756 I common_params_fit_impl: set ngl_per_device[2].(n_layer, n_part, overflow_type)=(28, 20, ATTN), id_dense_start=2
  11. 0.10.354.757 I common_params_fit_impl:   - Vulkan0 (NVIDIA GeForce RTX 4060 Ti): 28 layers (20 overflowing),  14999 MiB used,   1130 MiB free


Donc 11 sur RPC0, 10 sur RPC1, 8 sur Vulkan0 et 20 en CPU! La j'ai 24GB de RAM pris sur 32GB.
 
Je lui ai demandé de faire un clone de Celeste pour changer, je suis un peu au dessus de 5/s en TG:

Code :
  1. 65.25.346.106 I slot print_timing: id  0 | task 0 | n_gen =   8798, tg =   5.60 t/s, tg_3s =   5.74 t/s


Bref c'était l'info inutile du dredi :o


---------------
Faudra que je teste un jour :o
n°50725
the_fennec
f3nn3cUs z3rd4
Posté le 25-09-2026 à 17:32:09  profilanswer
 

Bordel :fou:  
 
Qwen Next s'est mis a faire des /////////
 
J'ai oublié de pin la version de Mesa sur ma nouvelle VM Linux. Donc si ça se trouve les quants RCO marchaient bien, c'était peut être le bug Mesa :/
 
Pour info Mesa 26.1.5-1 marche bien, et j'avais des soucis avec 26.2.
 
edit: encore pire, j'ai des /// tout de suite, étrange, peut être un soucis avec llama.cpp :(


Message édité par the_fennec le 25-09-2026 à 17:38:36

---------------
Faudra que je teste un jour :o
n°50732
SynE
Agri du dessert
Posté le 25-09-2026 à 18:04:03  profilanswer
 

Fichier corrompu :o

n°50738
the_fennec
f3nn3cUs z3rd4
Posté le 25-09-2026 à 18:45:17  profilanswer
 

J'ai DL avec le cli HF, il est censé vérifier les hashs. Mais je vais tester un autre quant pour voir.


---------------
Faudra que je teste un jour :o
n°50761
tfpsly
Sly
Posté le 25-09-2026 à 21:26:44  profilanswer
 

tfpsly a écrit :

Bah je viens de dire que Qwen3.8-27B-4.2BPW-16GB passe très bien sur 16gb.
Par contre 3.8-Next / 4.0, ça va être plus que chaud...


the_fennec a écrit :


En fait il a juste renommé l'ancien IQ3_M d'Unsloth, il s'en même pas fait chié a changer les metadata:


https://huggingface.co/hitsfmdj/Qwe [...] -16GB.gguf
https://i.imgur.com/s6AStVO.png


Et c'est pas 4.2BPW:
https://huggingface.co/hitsfmdj/Qwe [...] ation.json

Code :
  1. "label": "GGUF imatrix mix \u00b7 3.77 bpw (memory-lean)",


tfpsly a écrit :

Oooh bien vu.


En tout cas, Qwen3.8-27B-4.2BPW-16GB reste mon favori parmi ceux que j'ai testé : il vient de me créer, puis implémenté, un gros refactoring en 17 étapes sur plusieurs heures. Et ça fonctionne. Content de la qualité et de la vitesse d'exécution sur 5060 Ti 16gb.
Si je suis bien, un Q3 par Unsloth (ou Q3++ si 4.2BPW-16GB est amélioré depuis IQ3_M) donnerait environ 96% de "l'intelligence" du modèle de base, vs 98% pour un Q4 ?

Code :
  1. # 120k context 35 à 40 tk/s (prompt jusque 760 tk/s)
  2. llama-server -m ~/models/Qwen3.8-27B-4.2BPW-16GB.gguf -c 110000 --parallel 1 --no-mmproj-offload -b 512 -ub 512 -ngl 99 --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --spec-type draft-mtp --spec-draft-n-max 2 --fit off --reasoning off --reasoning-budget 0 --chat-template-kwargs '{"reasoning_effort":"none"}' --port 8080

Message cité 1 fois
Message édité par tfpsly le 25-09-2026 à 21:35:02
n°50770
moyen_moin​s
chat réincarné
Posté le 25-09-2026 à 21:56:25  profilanswer
 

J'ai reçu l'adaptateur occulink.
Je reteste le bc-250 ce weekend.

n°50783
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 26-09-2026 à 00:12:29  profilanswer
 

Allez on est tous derrière toi  [:phrygide:2]


---------------
Victime de girafophobie, mais se soigne.
n°50784
neo world
Posté le 26-09-2026 à 00:14:23  profilanswer
 

[:babaji]

 Page :   1  2  3  4  5  ..  72  73  74  75  76  77

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)