Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
6231 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  71  72  73  74  75  76
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°50074
neo world
Posté le 22-09-2026 à 08:23:41  profilanswer
 

Reprise du message précédent :
Ça a l’air plus qu’utilisable même pour une petite équipe :D

n°50078
Pipould's
Posté le 22-09-2026 à 08:52:31  profilanswer
 

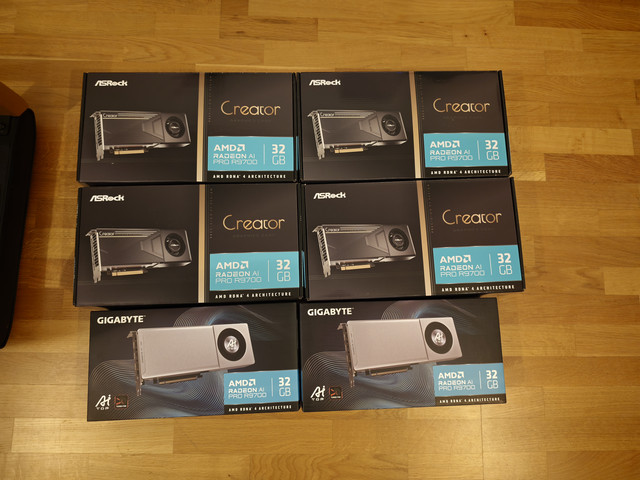
https://i.ibb.co/wFTCJf69/IMG-20260921-192247.jpg
 
J'ai la team au complet qui n'attend qu'a etre branchee  :lol:

n°50079
Pipould's
Posté le 22-09-2026 à 08:53:14  profilanswer
 

neo world a écrit :

Ça a l’air plus qu’utilisable même pour une petite équipe :D


L'enorme avantage c'est que tu as 3000+ de prefill sur tout ton contexte... donc jusqu'a 262k...

n°50088
neo world
Posté le 22-09-2026 à 09:45:10  profilanswer
 

Tu en as eu pour combien ? :D
 
Tu as avais un modèle en tête pour les 196GB

n°50090
Pipould's
Posté le 22-09-2026 à 09:47:47  profilanswer
 

neo world a écrit :

Tu en as eu pour combien ? :D
 
Tu as avais un modèle en tête pour les 196GB


1550 la carte.
 
Je vais en monter 4 pour sur. Faire un rig avec 6 cartes commence a poser pas mal de challenges niveau PSU et cooling... Donc 4 + 2 me semble le split a faire.

n°50097
neo world
Posté le 22-09-2026 à 10:15:42  profilanswer
 

Pipould's a écrit :


1550 la carte.
 
Je vais en monter 4 pour sur. Faire un rig avec 6 cartes commence a poser pas mal de challenges niveau PSU et cooling... Donc 4 + 2 me semble le split a faire.


joli budget mais le resultat est à la hauteur :D

n°50098
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 10:18:45  profilanswer
 

the_fennec a écrit :

@neo, bon courage pour le test de Jev, ça n'a pas l'air évident!
 
@Tronklou
Ya aussi le cas tout le monde en parle mais c'est quand même de la merde, genre les tunings de DavidAU :o


T'es dur avec DavidAU non ? :o
Au moins il met à jour lui pas comme Atomic chat :whistle:

n°50100
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 10:21:32  profilanswer
 

Pipould's a écrit :

https://i.ibb.co/wFTCJf69/IMG-20260921-192247.jpg
 
J'ai la team au complet qui n'attend qu'a etre branchee  :lol:


bordel :love:
par contre, faut la cm qui suit non (même pour 4) ?

n°50101
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 10:23:50  profilanswer
 

moyen_moins a écrit :


T'es dur avec DavidAU non ? :o
Au moins il met à jour lui pas comme Atomic chat :whistle:


J'ai du tester 2 modèles DavidAU, pas convaincu.
Atomic chat, assez déçu par le résultat au final.


---------------
Faudra que je teste un jour :o
n°50107
Pipould's
Posté le 22-09-2026 à 10:31:12  profilanswer
 

moyen_moins a écrit :


bordel :love:
par contre, faut la cm qui suit non (même pour 4) ?


J'ai un B850 proart, je vais tester
 
PCIE5 8x | 2 ports
 
M2.PCIE5 4x -> adapter | 2 ports
 
Si jamais ca merde, j'aviserais, peut etre gonfler la ram et rester sur 2.

n°50113
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 10:37:28  profilanswer
 

Pipould's a écrit :


J'ai un B850 proart, je vais tester


PCIE5 8x | 2 ports


M2.PCIE5 4x -> adapter | 2 ports


Si jamais ca merde, j'aviserais, peut etre gonfler la ram et rester sur 2.


:jap:


j'attends les 1er résultats avec impatience du coup :D


edit: en tout cas les gigabyte sur amazon, y'en a plus "bon marché" :o


Message édité par moyen_moins le 22-09-2026 à 10:47:46
n°50120
Pipould's
Posté le 22-09-2026 à 10:50:09  profilanswer
 

Vous avez vu : https://huggingface.co/XiaomiMiMo/M [...] ll-Qwen-9B ?  
 
Ca a l'air de vraiment bump up le niveau de qwen 9B !

n°50128
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 11:12:15  profilanswer
 

Oui, c'est surprenant une boite qui fait un distil de son propre modèle avec celui d'un concurrent!


---------------
Faudra que je teste un jour :o
n°50134
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 11:27:02  profilanswer
 

Xiaomi a aussi sorti MiMO V2.6 flash/pro :o

n°50140
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 11:39:37  profilanswer
 

GGUF or didn't happen :o


---------------
Faudra que je teste un jour :o
n°50154
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 13:05:59  profilanswer
 

the_fennec a écrit :

GGUF or didn't happen :o


des gguf pour Mimo V2.6 flash, il y en a plein :)


edit: par exemple => https://huggingface.co/AesSedai/MiMo-V2.6-Flash-GGUF


Message édité par moyen_moins le 22-09-2026 à 13:06:24
n°50161
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 14:02:48  profilanswer
 

Hier il n'y avait que le 9B, mais bon de toute manière c'est trop gros pour moi :o


---------------
Faudra que je teste un jour :o
n°50165
Pipould's
Posté le 22-09-2026 à 14:26:29  profilanswer
 

the_fennec a écrit :

Hier il n'y avait que le 9B, mais bon de toute manière c'est trop gros pour moi :o


9B trop gros !?

n°50168
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 14:55:13  profilanswer
 

Pipould's a écrit :


9B trop gros !?


Non, flash/pro.


---------------
Faudra que je teste un jour :o
n°50169
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 15:46:16  profilanswer
 

J'ai pas fait gaffe mais le flash, ça passe sur un strix halo ?
ou bien il est trop amputé pour que ce soit "rentable" ?

n°50170
neo world
Posté le 22-09-2026 à 15:51:28  profilanswer
 

En règle générale tu veux rester sur un dérivé de Q4 ou supérieur pour maintenir la qualité / cohérence des réponses. J’ai déjà un peu joué en dessous mais c’est un coup à rapidement se brûler les ailes ///////////// :jap:

n°50171
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 16:01:32  profilanswer
 

ok :jap:
donc ça sera forcément pas évident même sur les nouveaux strix halo 192Go de RAM de faire tenir ce genre de truc avec une précision suffisante :/

n°50172
Pipould's
Posté le 22-09-2026 à 16:08:19  profilanswer
 

moyen_moins a écrit :

J'ai pas fait gaffe mais le flash, ça passe sur un strix halo ?
ou bien il est trop amputé pour que ce soit "rentable" ?


Qwen 3.8 flash next ? Biensur. J'utilise halogen dessus, je posterai des benchs ce soir.

n°50173
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 16:13:02  profilanswer
 

Pipould's a écrit :


Qwen 3.8 flash next ? Biensur. J'utilise halogen dessus, je posterai des benchs ce soir.


Mimo V2.6 Flash ;)
Mais je pense pas [:transparency]

n°50176
b-tzu
Geek a toute heure...
Posté le 22-09-2026 à 16:26:00  profilanswer
 

entre un MBP M1 Max avec 64Go ou un MBP M3 Pro ou M4 Pro et 32Go ?


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50177
Pipould's
Posté le 22-09-2026 à 16:33:11  profilanswer
 

moyen_moins a écrit :


Mimo V2.6 Flash ;)
Mais je pense pas [:transparency]


Ha, celui la non je pense pas.

n°50178
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 16:42:25  profilanswer
 

b-tzu a écrit :

entre un MBP M1 Max avec 64Go ou un MBP M3 Pro ou M4 Pro et 32Go ?


C'est juste pour faire de l'IA ou ça va servir a d'autres trucs en plus?
 
En gardant 8GB pour l'OS et le reste, ce qui n'est pas beaucoup, ça fait 24 vs 56, pas du tout le même genre de modèles. Avec 56GB tu peux charger des gros modèles mais ils seront lent, mais c'est mieux que rien. Après si c'est pour s'en servir en plus, un m1 c'est quand même un vieux truc, et un m4 Pro c'est mieux :o
 
J'ai un un m4 pro 48GB pour le taf, et en ce moment j'ai 16GB de pris en "Active" et 16GB en "Inactive", bon j'ai du merdier Docker, Zoom, IntelliJ, Claude, Firefox, Outlook ...

Message cité 1 fois
Message édité par the_fennec le 22-09-2026 à 16:43:07

---------------
Faudra que je teste un jour :o
n°50182
SynE
Agri du dessert
Posté le 22-09-2026 à 16:47:56  profilanswer
 

J'ai demandé à chatgpt de me faire un benchmark sur llama.cpp, il rigole pas [:petrus75]  
 
Protocole
 
1. Verification de toutes les parties par SHA-256 contre les empreintes du manifeste Hugging Face.
 
2. Test court par variante : 20 threads, pp32 et tg8, une repetition avec echauffement.
 
3. Premiere passe : AVX2 puis AVX-512, 10/20/30/40 threads, pp512 et tg128, cinq repetitions avec echauffement.
 
4. Deuxieme passe : AVX-512 puis AVX2, memes parametres.
 
5. Validation des sorties JSON, puis synthese des dix repetitions par configuration : moyenne, ecart-type et gain AVX-512.
 
Ordre de traitement
 
Qwen3.5-122B-A10B Q4_K_M
Mistral Large Instruct 2411 123B Q4_K_M
Qwen3.5-397B-A17B Q4_K_M
Llama 3.1 405B Instruct Q4_K_M
 
 
C'est EDF qui vont être content :o

n°50183
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 16:59:22  profilanswer
 

ça va être long pour les modèles denses :sweat:

n°50184
SynE
Agri du dessert
Posté le 22-09-2026 à 17:01:18  profilanswer
 

C'est clair.

n°50186
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 17:18:26  profilanswer
 

C'est quoi le but? Pourquoi utiliser des modèle obsolètes?


---------------
Faudra que je teste un jour :o
n°50187
SynE
Agri du dessert
Posté le 22-09-2026 à 17:21:49  profilanswer
 

Non, voir si utiliser avx512 apporte quelque chose.
 
Pour les modèles n'ayant pas les ref, je lui laisse le choix de ce qu'il veut tester, ça ne changera rien au delta avx2/512 je pense.

n°50190
speedboyz3​0
Guide Michelin :o
Posté le 22-09-2026 à 17:44:30  profilanswer
 

b-tzu a écrit :

entre un MBP M1 Max avec 64Go ou un MBP M3 Pro ou M4 Pro et 32Go ?


Un Bosgame 128Go

n°50193
moyen_moin​s
chat réincarné
Posté le 22-09-2026 à 17:52:49  profilanswer
 

Mimo V2.6 pro plus "intelligent" que Qwen 3.8 max :o

n°50197
b-tzu
Geek a toute heure...
Posté le 22-09-2026 à 18:08:53  profilanswer
 

the_fennec a écrit :


C'est juste pour faire de l'IA ou ça va servir a d'autres trucs en plus?
 
En gardant 8GB pour l'OS et le reste, ce qui n'est pas beaucoup, ça fait 24 vs 56, pas du tout le même genre de modèles. Avec 56GB tu peux charger des gros modèles mais ils seront lent, mais c'est mieux que rien. Après si c'est pour s'en servir en plus, un m1 c'est quand même un vieux truc, et un m4 Pro c'est mieux :o
 
J'ai un un m4 pro 48GB pour le taf, et en ce moment j'ai 16GB de pris en "Active" et 16GB en "Inactive", bon j'ai du merdier Docker, Zoom, IntelliJ, Claude, Firefox, Outlook ...


C’est pour de lia principalement. Et même pour bosser le max doit être cool quand même non ?
Modèles plus gros mais lents ? À cause du cpu ?


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50241
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 20:10:13  profilanswer
 

SynE a écrit :

Non, voir si utiliser avx512 apporte quelque chose.
 
Pour les modèles n'ayant pas les ref, je lui laisse le choix de ce qu'il veut tester, ça ne changera rien au delta avx2/512 je pense.


Déjà je pense qu'avec llama.cpp de base il n'y aura pas une différence énorme, tu devrais essayer ik_llama a la place.
Pour les modèles a 400B de paramètres tu vas être a des vitesses très basses, ça te prendre des années de bench. Déjà, essaye Qwen 3.6 35B, ça sera plus utile. Je suis curieux de combien de minutes tu vas mettre pour générer un token avec Llama 3.1 405B :o


---------------
Faudra que je teste un jour :o
n°50250
speedboyz3​0
Guide Michelin :o
Posté le 22-09-2026 à 20:16:18  profilanswer
 

Ca veut dire quoi pour de l'IA ?
T'as des attentes précises ?  
 
Dans tous les cas, M1 Max clairement.
Bande passante ram ++ (400GB/s vs 273GB/s sur le M4 Pro).
Et 64Go vs 32Go bah y a pas photo quoi :o
Tu pourras faire tourner des 70B ou de gros MoE.  
Mais ça sera lent quoi :o
 
C'est quel budget tout ça ?
 

n°50252
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 20:17:45  profilanswer
 

b-tzu a écrit :


C’est pour de lia principalement. Et même pour bosser le max doit être cool quand même non ?
Modèles plus gros mais lents ? À cause du cpu ?


Le max doit être pas mal du tout, bien meilleur que le m4 pro probablement. C'est juste qu'il faut voir le prix que tu vas payer et surtout combien de temps Apple va encore le supporter?
 
Avec le m1 max 64GB tu pourrais peut être charger Qwen 3.8 Next Flash, chose complètement impossible avec 32GB. Il sera sûrement plus lent qu'un 35B sur m4 pro. En fait c'est un peu ma situation, 35B tourne bien sur mon merdier, mais je préfère essayer de bidouiller Qwen 3.8 Next Flash a 5 tg/s qu'avoir 35B a 50/s :o. Je sais pas si j'ai été très clair sur ce que je voulais dire :jap:.

Message cité 1 fois
Message édité par the_fennec le 22-09-2026 à 20:20:51

---------------
Faudra que je teste un jour :o
n°50257
b-tzu
Geek a toute heure...
Posté le 22-09-2026 à 20:22:03  profilanswer
 

speedboyz30 a écrit :

Ca veut dire quoi pour de l'IA ?
T'as des attentes précises ?  
 
Dans tous les cas, M1 Max clairement.
Bande passante ram ++ (400GB/s vs 273GB/s sur le M4 Pro).
Et 64Go vs 32Go bah y a pas photo quoi :o
Tu pourras faire tourner des 70B ou de gros MoE.  
Mais ça sera lent quoi :o
 
C'est quel budget tout ça ?


mais pourquoi ce sera lent ?  
ca se trouve sur leboncoin autour des 1500, il faut guetter.


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50269
b-tzu
Geek a toute heure...
Posté le 22-09-2026 à 20:26:53  profilanswer
 

the_fennec a écrit :


Le max doit être pas mal du tout, bien meilleur que le m4 pro probablement. C'est juste qu'il faut voir le prix que tu vas payer et surtout combien de temps Apple va encore le supporter?
 
Avec le m1 max 64GB tu pourrais peut être charger Qwen 3.8 Next Flash, chose complètement impossible avec 32GB. Il sera sûrement plus lent qu'un 35B sur m4 pro. En fait c'est un peu ma situation, 35B tourne bien sur mon merdier, mais je préfère essayer de bidouiller Qwen 3.8 Next Flash a 5 tg/s qu'avoir 35B a 50/s :o. Je sais pas si j'ai été très clair sur ce que je voulais dire :jap:.


Qwen 35B tourne aussi sur le 64 en théorie non ? Aussi vite que sur le M4 Pro ?


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50294
Pipould's
Posté le 22-09-2026 à 21:07:11  profilanswer
 

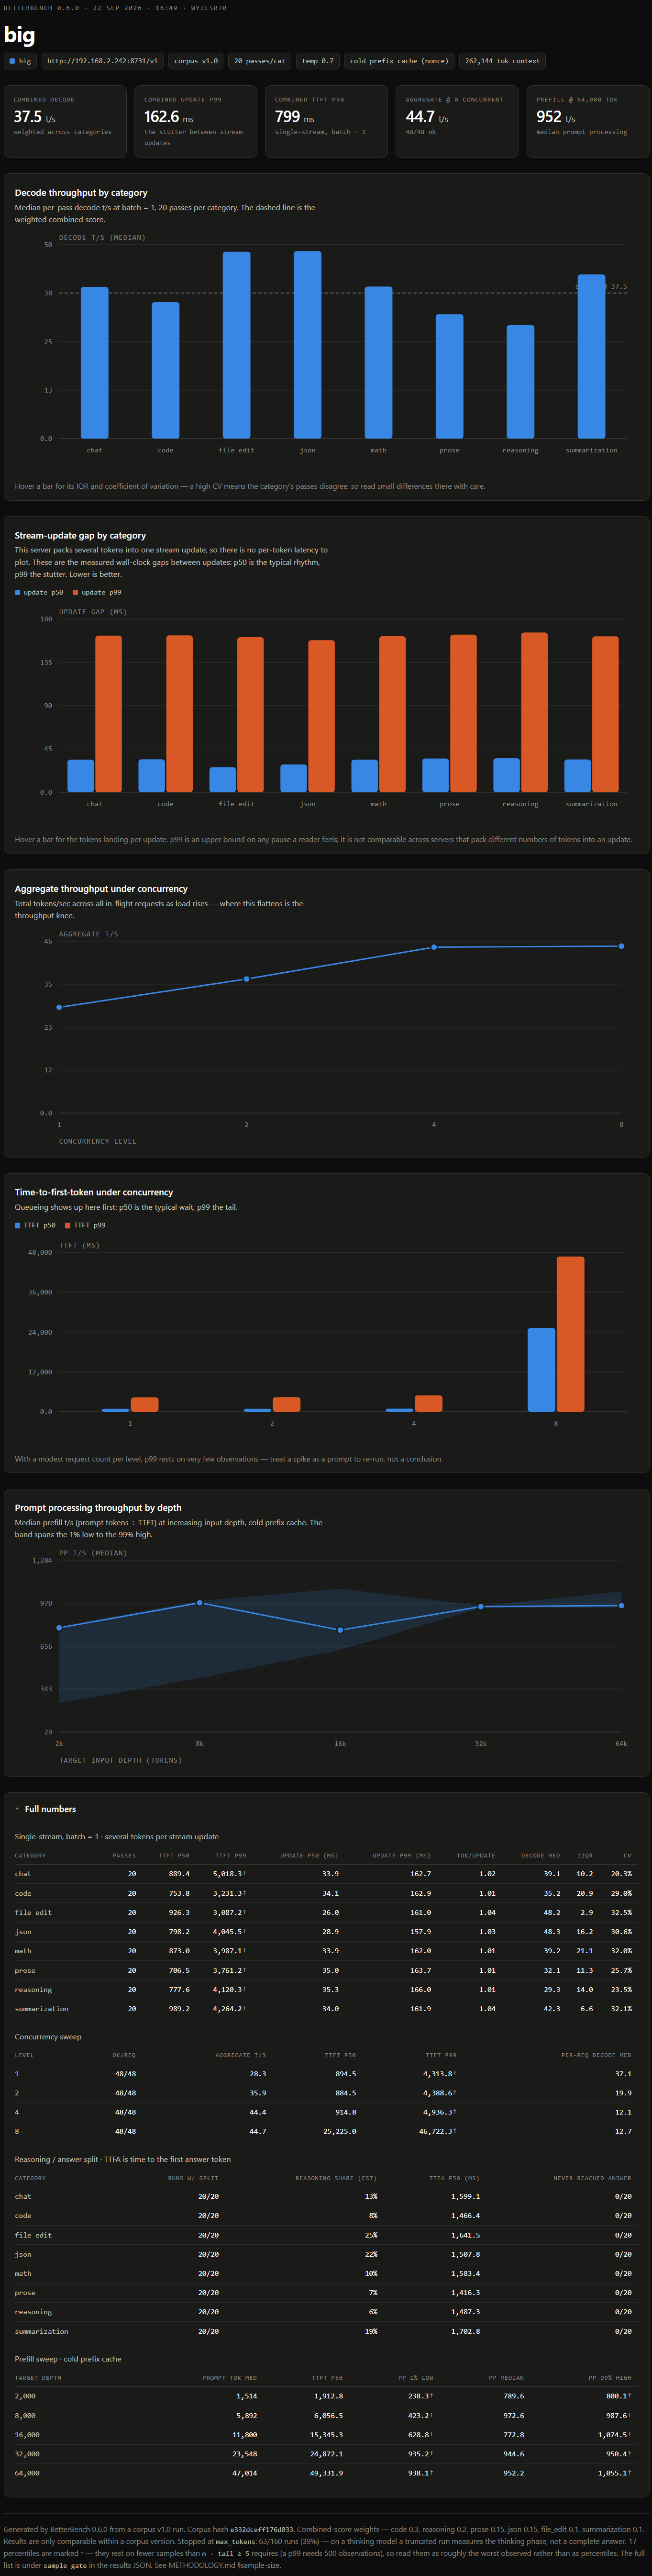
https://i.ibb.co/KcMcf1Qs/image.png


q38fn sur Strix 128GB via halogen

Message cité 1 fois
Message édité par Pipould's le 22-09-2026 à 21:07:53
 Page :   1  2  3  4  5  ..  71  72  73  74  75  76

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)