Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5418 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  68  69  70  71  72  73
Page Suivante
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°50294
Pipould's
Posté le 22-09-2026 à 21:07:11  profilanswer
 

Reprise du message précédent :
https://i.ibb.co/KcMcf1Qs/image.png


q38fn sur Strix 128GB via halogen

Message cité 1 fois
Message édité par Pipould's le 22-09-2026 à 21:07:53
n°50335
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 00:16:17  profilanswer
 

b-tzu a écrit :


Qwen 35B tourne aussi sur le 64 en théorie non ? Aussi vite que sur le M4 Pro ?


Qwen tournera mieux sur le m1, surtout qu'avec plus de RAM tu auras un meilleur quant et plus de contexte.
 
Le seul défaut du m1 c'est qu'il est sortis 3 ans avant le m4.


---------------
Faudra que je teste un jour :o
n°50346
neo world
Posté le 23-09-2026 à 08:37:04  profilanswer


Si en plus ça arrive à scaler (plus de perfs) jusqu’à 4 appels concurrents… :D
 
Je vais peut être passer dessus cette semaine

n°50371
b-tzu
Geek a toute heure...
Posté le 23-09-2026 à 10:39:18  profilanswer
 

the_fennec a écrit :


Qwen tournera mieux sur le m1, surtout qu'avec plus de RAM tu auras un meilleur quant et plus de contexte.
 
Le seul défaut du m1 c'est qu'il est sortis 3 ans avant le m4.


Ok merci pour toutes les réponses.  
je sais que le M1 est vieux, mais sa puissance est tres suffisant pour la plupart des usages, meme aujourdhui. surtout en version max jimagine. et hors IA locale, mon taf c'est de l'ia avec claude, donc M1 ou M12 je crois pas que ca fera une vraie diff, ca se passe en cloud


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50374
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 10:50:13  profilanswer
 

b-tzu a écrit :


Ok merci pour toutes les réponses.  
je sais que le M1 est vieux, mais sa puissance est tres suffisant pour la plupart des usages, meme aujourdhui. surtout en version max jimagine. et hors IA locale, mon taf c'est de l'ia avec claude, donc M1 ou M12 je crois pas que ca fera une vraie diff, ca se passe en cloud


Le gros avantage des MB c'est qu'en plus d'être fiable, on trouve très facilement des batteries neuves si besoin si jamais elle est rincée.


---------------
Faudra que je teste un jour :o
n°50377
b-tzu
Geek a toute heure...
Posté le 23-09-2026 à 10:54:35  profilanswer
 

la batterie de base est deja enorme sur les pro (plus que sur les air ou elle est deja bien grasse)
mais oui ca peut etre pratique
jai trouvé un M1 Pro 32Go a ecran HS, petit prix, qui peut servir de mac mini en fixe sur mon ecran... jhesite.  
Et j'ai enfin recu ma 3090, j'ai 24Go de dispo sur mon fixe pour tester des IA locales (contre 10 avant avec ma 3080)


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°50383
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 11:43:17  profilanswer
 

Bon personne ne parle des perfs du M5 ultra ? :o
Ou du M6 ? :o

n°50384
Amonchakai
Posté le 23-09-2026 à 11:50:23  profilanswer
 

Personne ne l’a acheté  :o

n°50387
neo world
Posté le 23-09-2026 à 12:18:28  profilanswer
 
n°50388
epsiloncen​taury
Posté le 23-09-2026 à 12:25:35  profilanswer
 

neo world a écrit :


J'ai obtenu un ticket pour tester JEV. Ce sera dans le pipe pour les prochaines semaines par curiosité (une second avis pour un pouillème de ce que coute un modèle chinois pas cher :D)
 
pour le truc bonsai je vis pas comment ça aurait pu finir autrement : soit tout le monde faisait de la grosse de merde depuis trois ans et ils faisaient un cadeau à l'humanité soit les poids servaient en fait à quelque chose  :whistle:  
 
merci pour le partage :jap:


J'ai vu la dernière vidéo de Codacus. Il m'a étonné sur son point de vue de JEV. Pas gentil Codicus    :)  
 
Bref pour lui JEV n'a rien de nouveau, ce n'est que du parallélisme (en gros). Il a même ajouté à son fork de Llama.cpp, un mode d'inférence a la "JEV", que chacun peut tester en téléchargeant son fork  https://github.com/thecodacus/llama [...] l-decision
 
Il met en avant la démonstration de Harsha Gondala qui démontre seulement deux heures après la sortir de JEV(développé en 2 ans apparemment)  qu'on peut obtenir un comportement similaire avec  Qwen 2.5 1.5B standard + une autre méthode d'inférence, sans nouveau modèle, sans nouveaux poids et sans réentraînement.
 
C'est ça qui a fait tilt chez Codacus.   :D

n°50390
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 12:34:04  profilanswer
 

c'est bien beau de mettre à dispo ces forks mais il y a rien qui décrit clairement ce que ça apporte de plus.
c'est dommage :o

n°50392
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 12:45:06  profilanswer


J'ai vu que celle du M6 mini, c'était cool.
Hâte de voir celle du Ultra !
 
Sinon bonne revue ici :
 
https://www.macstories.net/stories/ [...] ai-agents/

n°50393
epsiloncen​taury
Posté le 23-09-2026 à 12:54:10  profilanswer
 

moyen_moins a écrit :

c'est bien beau de mettre à dispo ces forks mais il y a rien qui décrit clairement ce que ça apporte de plus.
c'est dommage :o


Il décrit tout dans sa vidéo ..


https://www.youtube.com/watch?v=bcGO7xre46o


Message édité par epsiloncentaury le 23-09-2026 à 12:55:46
n°50395
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 13:07:10  profilanswer
 

epsiloncentaury a écrit :


J'ai vu la dernière vidéo de Codacus. Il m'a étonné sur son point de vue de JEV. Pas gentil Codicus    :)  
 
Bref pour lui JEV n'a rien de nouveau, ce n'est que du parallélisme (en gros). Il a même ajouté à son fork de Llama.cpp, un mode d'inférence a la "JEV", que chacun peut tester en téléchargeant son fork  https://github.com/thecodacus/llama [...] l-decision
 
Il met en avant la démonstration de Harsha Gondala qui démontre seulement deux heures après la sortir de JEV(développé en 2 ans apparemment)  qu'on peut obtenir un comportement similaire avec  Qwen 2.5 1.5B standard + une autre méthode d'inférence, sans nouveau modèle, sans nouveaux poids et sans réentraînement.
 
C'est ça qui a fait tilt chez Codacus.   :D


J'ai trouvé sa vidéo bien, justement il calme un peu la hype. Jev c'est très bien dans certains cas, mais ça n'aide pas plus que ça en inférence générale.
 

moyen_moins a écrit :

c'est bien beau de mettre à dispo ces forks mais il y a rien qui décrit clairement ce que ça apporte de plus.
c'est dommage :o


C'est pas un fork, mais une branche, donc travail toujours en cours.
Il a fait toute une vidéo dessus. TL;DR: il a ajouté un endpoint /v1/decision pour faire du Jev sur llama.cpp.


---------------
Faudra que je teste un jour :o
n°50404
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 14:27:05  profilanswer
 

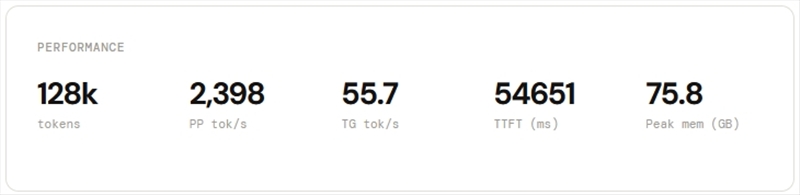
C'est pas dégueux :


M5 Ultra (64c) · 96 GB · 4bit · 2026-09-23
Qwen3.8-Flash-Next-oQ4e-mtp


https://rehost.diberie.com/Picture/Get/r/546406


https://omlx.ai/benchmarks/performance/2i2vngpd


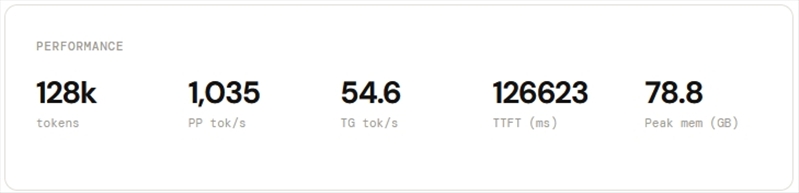
M5 Max (40c) · 128 GB · 4bit · 2026-09-22
Qwen3.8-Flash-Next-oQ4e-mtp


https://rehost.diberie.com/Picture/Get/r/546408


https://omlx.ai/benchmarks/performance/qgaq59xo


Message édité par speedboyz30 le 23-09-2026 à 14:30:46
n°50405
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 14:33:01  profilanswer
 

oui, c'est pas dégueux du tout.
96Go/128Go par contre...

n°50406
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 14:33:11  profilanswer
 

Ça on le savait déjà :o le prix par contre, lui il est dégueux :(


---------------
Faudra que je teste un jour :o
n°50407
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 14:38:59  profilanswer
 

moyen_moins a écrit :

96Go/128Go par contre...


J'arrive toujours pas à m'y faire.


Plus de rapidité vs plus de capacité  [:lapattefolle:1]


J'ai eu le feu vert de la directrice financière et le cash est prêt :o


Je continue à poncer les bench.

Message cité 1 fois
Message édité par speedboyz30 le 23-09-2026 à 14:42:25
n°50408
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 14:39:25  profilanswer
 

the_fennec a écrit :

Ça on le savait déjà :o le prix par contre, lui il est dégueux :(


C'est toujours moins cher aujourd'hui que dans 6 mois  [:so-saugrenu2:2]

n°50413
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 15:13:25  profilanswer
 

speedboyz30 a écrit :


J'arrive toujours pas à m'y faire.
 
Plus de rapidité vs plus de capacité  [:lapattefolle:1]  
 
J'ai eu le feu vert de la directrice financière et le cash est prêt :o
 
Je continue à poncer les bench.  


Je pense que capacité > rapidité
 
Sachant que le bench montre un TG identique, il n'y que le PP qui gagne


---------------
Faudra que je teste un jour :o
n°50415
lapin
Posté le 23-09-2026 à 15:18:19  profilanswer
 

Presse-citron : J’ai installé une IA surpuissante directement chez moi
https://www.youtube.com/watch?v=mcRDIdIfHqE
 
Plus de 10 000€ Euros boulles le bouzin tout de même !!!!
 
 
Je teste Llama.cpp sous Android, https://play.google.com/store/apps/ [...] klab.llama
https://play.google.com/store/apps/ [...] =web_share
 
Le haut de ma OnePlus PAD 2 de 12 pouces est brûlant, il est d'une lenteur affligeante, c'est presque pire que ma RADEON RX-VEGA56 8 GO de VRAM avec c'est 3,61 Tokens par seconde sur mon ordinateur de bureau.
Et ça bouffe max de batterie.
 
Ce con d'IA sur android est très con, il dit qui ne peux par lire l'image, mais décrit très bien la forme géométrique et les lettres de chaque points et génère bien le script SVG en conséquence.
 
Bon je confimre, il est encore plus débile que sur ordinateur de bureau.
 

Citation :


<svg width="500" height="595" viewBox="0 0 500 595" xmlns="http://www.w3.org/2000/svg">
  <!-- Fond blanc -->
  <rect width="500" height="595" fill="white" />
 
  <!--  
    Définition des coordonnées approximatives basée sur la description :
    Le quadrilatère semble être incliné.
    A est en haut à gauche, B en haut à droite (mais plus bas que A),  
    C est en bas à droite, D est en bas à gauche.
    Les points intermédiaires E, H, F et G semblent définir les bords ou des segments internes.
  -->
 
  <!-- Tracé de la forme principale (le contour extérieur) -->
  <polygon points="50,100 450,250 450,500 50,550" fill="none" stroke="black" stroke-width="2" />
 
  <!-- Tracé des segments internes/liens selon la structure décrite -->
  <line x1="50" y1="100" x2="250" y2="180" stroke="black" stroke-width="2" /> <!-- A à E -->
  <line x1="250" y1="180" x2="450" y2="250" stroke="black" stroke-width="2" /> <!-- E à B -->
  <line x1="450" y1="250" x2="450" y2="500" stroke="black" stroke-width="2" /> <!-- B à C -->
  <line x1="450" y2="500" x2="50" y2="550" stroke="black" stroke-width="2" /> <!-- C à F/G -->
  <line x1="50" y1="550" x2="50" y2="100" stroke="black" stroke-width="2" /> <!-- G/F à A -->
   
  <!-- Lignes de structure interne (H, D) -->
  <line x1="250" y1="180" x2="250" y2="450" stroke="black" stroke-width="2" /> <!-- E à H -->
  <line x1="50" y1="450" x2="250" y2="450" stroke="black" stroke-width="2" /> <!-- D à H -->
  <line x1="50" y1="450" x2="50" y2="550" stroke="black" stroke-width="2" /> <!-- D à G -->
 
  <!-- Étiquettes des points (Texte) -->
  <text x="40" y="95" font-family="Arial" font-size="20">A</text>
  <text x="250" y="175" font-family="Arial" font-size="20">E</text>
  <text x="460" y="255" font-family="Arial" font-size="20">B</text>
  <text x="460" y="510" font-family="Arial" font-size="20">C</text>
  <text x="40" y="455" font-family="Arial" font-size="20">D</text>
  <text x="260" y="455" font-family="Arial" font-size="20">H</text>
  <text x="40" y="570" font-family="Arial" font-size="20">G</text>
  <text x="260" y="570" font-family="Arial" font-size="20">F</text>
 
</svg>


Et sous google chrome pour PC, le script SVG comporte des graves erreurs, bien que décrit dans le Script SVG les lettres ne s'affichent pas.
 
 
Edit: voici l'image générée par Llama.cpp Google/Gemma-4-26B-A4B-it-qat-q4_0.gguf et mmproj: gemma-4-26B-it-mmproj.gguf
 
https://www.dropbox.com/scl/fi/2u020usti9eofud0cu9dy/2026-09-23-15.18.42.jpg?rlkey=oxk93ya2j7hpa9pfjzw261rrz&st=tpizcn9d&dl=1
 
Y a pas à dire hein c'est un vrai p'ti génie !!!

Message cité 1 fois
Message édité par lapin le 23-09-2026 à 15:23:11
n°50417
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 15:22:24  profilanswer
 

the_fennec a écrit :


Je pense que capacité > rapidité
 
Sachant que le bench montre un TG identique, il n'y que le PP qui gagne


Mais le PP sur de l'agentique multi-user c'est important :o
 
Et la rapidité est utile tout le temps, la capacité elle n'est utile "que" si tu dépasses 96GB de ram quoi :o
Et sur les modèles actuels, le sweet spot semble être bien plus bas.
 
Pas si facile non ? Après mon raisonnement est peut-être faux, à force de le tourner dans tous les sens c'est possible  [:speedboyz30:5]

n°50418
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 15:29:57  profilanswer
 

lapin a écrit :

Presse-citron : J’ai installé une IA surpuissante directement chez moi
https://www.youtube.com/watch?v=mcRDIdIfHqE
 
Plus de 10 000€ Euros boulles le bouzin tout de même !!!!


10k HT s'il te plait  [:la chancla:1]  
 
Tout ça pour 32Go VRAM  [:cmshadow]

n°50419
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 15:30:43  profilanswer
 

speedboyz30 a écrit :


Mais le PP sur de l'agentique multi-user c'est important :o
 
Et la rapidité est utile tout le temps, la capacité elle n'est utile "que" si tu dépasses 96GB de ram quoi :o
Et sur les modèles actuels, le sweet spot semble être bien plus bas.
 
Pas si facile non ? Après mon raisonnement est peut-être faux, à force de le tourner dans tous les sens c'est possible  [:speedboyz30:5]


Si c'est multi-user en effet ça change la donne, je pensais que c'était juste pour toi. Après plus de VRAM, ça faire plus de contexte :D
 
Mais si c'est du multi-user, peut être que vLLM serait plus indiqué?


---------------
Faudra que je teste un jour :o
n°50420
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 15:31:14  profilanswer
 

speedboyz30 a écrit :


10k HT s'il te plait  [:la chancla:1]  
 
Tout ça pour 32Go VRAM  [:cmshadow]


Sponsorisé par AMD et LDLC :lol:


---------------
Faudra que je teste un jour :o
n°50434
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 16:25:42  profilanswer
 

je teste pas mal de qwen 3.8 27B depuis quelques jours et je rencontre souvent un souci avec les version K_L sur ma conf (je suis pas le seul a priori).
bien que le modèle fit sur les 2 cartes, j'ai un repli partiel sur le CPU : je passe du coup de 20t/s+ (non K_L) à à peine 10-11t/s (K_L).
j'ai jamais trop compris ce qu'il se passait, me semble avoir lu que c'était un souci avec le F16/BF16 ou je sais pas trop quoi mais c'est un peu relou de découvrir le souci une fois le modèle téléchargé.
edit: petite obvious-rie mais les qwen 3.8 qui se vantent de moins réfléchir pour produire un résultat quasi identique qu'un modèle "stock"... :sarcastic:

Message cité 1 fois
Message édité par moyen_moins le 23-09-2026 à 16:28:46
n°50435
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 16:29:19  profilanswer
 

the_fennec a écrit :


Si c'est multi-user en effet ça change la donne, je pensais que c'était juste pour toi. Après plus de VRAM, ça faire plus de contexte :D
 
Mais si c'est du multi-user, peut être que vLLM serait plus indiqué?


Je sais :o
 
J'ai aussi un GB10 dans la balance. Mais la facilité / stabilité du mac gagnera au final je pense.
Et l'usage occasionnel d'outils d'éditions photo / vidéo aussi.
 
Je sur-estime sûrement l'importance du multi-user.
On n'est que deux hein, mais je pense vraiment qu'on se dirige vers une ère agentique avec plusieurs agents chacun qui tourneront souvent :o

n°50437
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 16:39:40  profilanswer
 

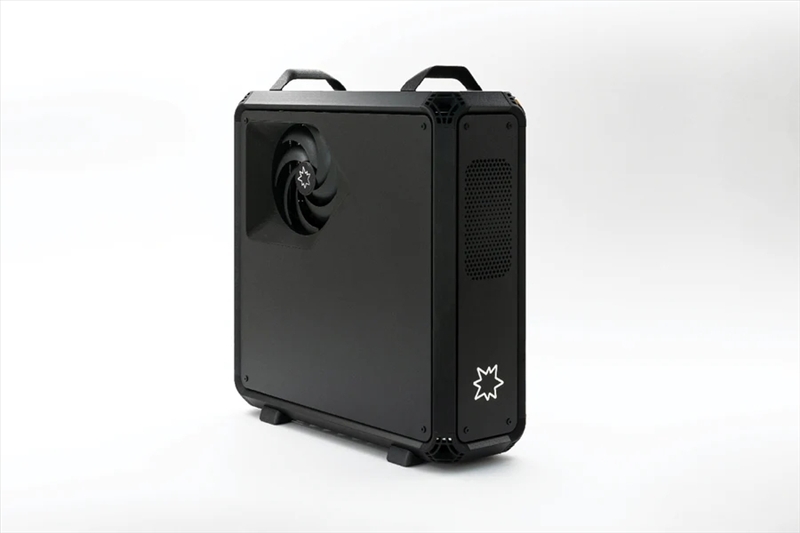
On en découvre tous les jours :
 
https://rehost.diberie.com/Picture/Get/r/546444
https://shop.lucebox.com/?country=FR
 

Citation :

128 GB unified memory, AMD Ryzen AI MAX+ 395, 256 GB/s
32 GB AMD Radeon AI PRO R9700, 640 GB/s, PCIe 4.0 x4 link
2 TB NVMe, up to 7,400 MB/s
1,000 W SFX power supply, 80 PLUS Platinum, ~500 W under load, ~40 W idle
Extruded aluminium chassis, 340 × 110 × 320 mm, 11.97 L, 6 kg
2× USB4, 2× USB-A, HDMI 2.1, 2× DP 2.1, plus 4 display outputs on the GPU
5 GbE Ethernet, Wi-Fi 7, Bluetooth
Ubuntu Server, Lucebox Engine and models preinstalled
OpenAI and Anthropic compatible API, root over SSH


Ça ne me semble même pas si cher  [:moonbloood:2]  
 

n°50441
Pipould's
Posté le 23-09-2026 à 16:51:06  profilanswer
 

speedboyz30 a écrit :

On en découvre tous les jours :
 
https://rehost.diberie.com/Picture/Get/r/546444
https://shop.lucebox.com/?country=FR
 

Citation :

128 GB unified memory, AMD Ryzen AI MAX+ 395, 256 GB/s
32 GB AMD Radeon AI PRO R9700, 640 GB/s, PCIe 4.0 x4 link
2 TB NVMe, up to 7,400 MB/s
1,000 W SFX power supply, 80 PLUS Platinum, ~500 W under load, ~40 W idle
Extruded aluminium chassis, 340 × 110 × 320 mm, 11.97 L, 6 kg
2× USB4, 2× USB-A, HDMI 2.1, 2× DP 2.1, plus 4 display outputs on the GPU
5 GbE Ethernet, Wi-Fi 7, Bluetooth
Ubuntu Server, Lucebox Engine and models preinstalled
OpenAI and Anthropic compatible API, root over SSH


Ça ne me semble même pas si cher  [:moonbloood:2]  


Tu es a 1200 euros plus cher qu'une solution DIY... Ca se vaut.
 
Le probleme c'est que ce n'est pas forcement le setup le plus smart a faire...  
 
Une 9700 + Strix sur llamacpp ca equivaut a halogen sur le strix seul
 
Tu vas pas rajouter 3 9700 pour avoir tout en vram...  

n°50443
neo world
Posté le 23-09-2026 à 17:06:32  profilanswer
 

speedboyz30 a écrit :


Mais le PP sur de l'agentique multi-user c'est important :o
 
Et la rapidité est utile tout le temps, la capacité elle n'est utile "que" si tu dépasses 96GB de ram quoi :o
Et sur les modèles actuels, le sweet spot semble être bien plus bas.
 
Pas si facile non ? Après mon raisonnement est peut-être faux, à force de le tourner dans tous les sens c'est possible  [:speedboyz30:5]


t'as oublié le principal : c'est aussi ta machine de travail  [:douceurs:2] : tu retires 7GO de base à l'OS pour qu'il vive, tu charges un gros modèle avec du contexte ... il te faut l'ultra avec 128GB de RAM avant que tu n'ait lancé ton IDE et ton navigateur avec 1M+ de tabs :o

n°50444
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 17:10:42  profilanswer
 

moyen_moins a écrit :

je teste pas mal de qwen 3.8 27B depuis quelques jours et je rencontre souvent un souci avec les version K_L sur ma conf (je suis pas le seul a priori).
bien que le modèle fit sur les 2 cartes, j'ai un repli partiel sur le CPU : je passe du coup de 20t/s+ (non K_L) à à peine 10-11t/s (K_L).
j'ai jamais trop compris ce qu'il se passait, me semble avoir lu que c'était un souci avec le F16/BF16 ou je sais pas trop quoi mais c'est un peu relou de découvrir le souci une fois le modèle téléchargé.
edit: petite obvious-rie mais les qwen 3.8 qui se vantent de moins réfléchir pour produire un résultat quasi identique qu'un modèle "stock"... :sarcastic:


Quel modèle? Quel paramètres?
J'ai jamais eu ce genre de soucis avec Unsloth, sauf Qwen Flash Next qui a un drop en TG au bout d'un moment, mais j'ai vu pas mal de retours dans ce sens et l'archi est encore expérimentale.


---------------
Faudra que je teste un jour :o
n°50445
neo world
Posté le 23-09-2026 à 17:28:47  profilanswer
 

speedboyz30 a écrit :

On en découvre tous les jours :
 
https://rehost.diberie.com/Picture/Get/r/546444
https://shop.lucebox.com/?country=FR
 

Citation :

128 GB unified memory, AMD Ryzen AI MAX+ 395, 256 GB/s
32 GB AMD Radeon AI PRO R9700, 640 GB/s, PCIe 4.0 x4 link
2 TB NVMe, up to 7,400 MB/s
1,000 W SFX power supply, 80 PLUS Platinum, ~500 W under load, ~40 W idle
Extruded aluminium chassis, 340 × 110 × 320 mm, 11.97 L, 6 kg
2× USB4, 2× USB-A, HDMI 2.1, 2× DP 2.1, plus 4 display outputs on the GPU
5 GbE Ethernet, Wi-Fi 7, Bluetooth
Ubuntu Server, Lucebox Engine and models preinstalled
OpenAI and Anthropic compatible API, root over SSH


Ça ne me semble même pas si cher  [:moonbloood:2]  


Pour 6000 balles je choisi à tous les coups un DGX10 ou un mac studio M5 ultra pour à peine 600 balles de plus

n°50456
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 18:30:19  profilanswer
 

the_fennec a écrit :


Quel modèle? Quel paramètres?
J'ai jamais eu ce genre de soucis avec Unsloth, sauf Qwen Flash Next qui a un drop en TG au bout d'un moment, mais j'ai vu pas mal de retours dans ce sens et l'archi est encore expérimentale.


Swift-Qwen3.8-27B-Q6_K_L.gguf : celui par exemple.
repli sur le CPU (je garde une petite charge GPU)
Swift-Qwen3.8-27B-Q6_K.gguf ou Swift-Qwen3.8-27B-Q6_K_S.gguf : pas de souci, ça tourne sur les GPU.
paramètres par défaut de qwen 3.8 pour le "thinking ON"  
pour le reste, réglage de la taille du contexte pour que ça fit à 28Go sur les cartes en q8/q8, VULKAN, MTP : ON (rien de ouf dans la la config du modèle)
 
J'avais la même chose sur les modèles de davidAU aussi (il y a des versions AMD de mémoire qui marchaient pas et les versions LOW fonctionnaient chez moi)
 
pour les UD3 d'unsloth, toujours pas OK sous LMstudio (feignant inside), je vais/il faut tester avec llama.cpp :o

n°50459
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 19:07:39  profilanswer
 

neo world a écrit :


t'as oublié le principal : c'est aussi ta machine de travail  [:douceurs:2] : tu retires 7GO de base à l'OS pour qu'il vive, tu charges un gros modèle avec du contexte ... il te faut l'ultra avec 128GB de RAM avant que tu n'ait lancé ton IDE et ton navigateur avec 1M+ de tabs :o


Si seulement l’ultra 128 existait ça serait le graal absolu  :miam:  
 
Mais oui, you’ve got a point comme on dit.

n°50460
speedboyz3​0
Guide Michelin :o
Posté le 23-09-2026 à 19:08:19  profilanswer
 

neo world a écrit :


Pour 6000 balles je choisi à tous les coups un DGX10 ou un mac studio M5 ultra pour à peine 600 balles de plus


Tu me conseillais le max faudrait savoir  [:zyzz:2]  
 
:o

n°50461
neo world
Posté le 23-09-2026 à 19:15:29  profilanswer
 

speedboyz30 a écrit :


Tu me conseillais le max faudrait savoir  [:zyzz:2]  
 
:o


Ouais non je pensais à une machine mono utilisateur pas que tu arroserais en IA tout le plateau du bâtiment :o

n°50473
the_fennec
f3nn3cUs z3rd4
Posté le 23-09-2026 à 20:05:46  profilanswer
 

moyen_moins a écrit :


Swift-Qwen3.8-27B-Q6_K_L.gguf : celui par exemple.
repli sur le CPU (je garde une petite charge GPU)
Swift-Qwen3.8-27B-Q6_K.gguf ou Swift-Qwen3.8-27B-Q6_K_S.gguf : pas de souci, ça tourne sur les GPU.
paramètres par défaut de qwen 3.8 pour le "thinking ON"  
pour le reste, réglage de la taille du contexte pour que ça fit à 28Go sur les cartes en q8/q8, VULKAN, MTP : ON (rien de ouf dans la la config du modèle)
 
J'avais la même chose sur les modèles de davidAU aussi (il y a des versions AMD de mémoire qui marchaient pas et les versions LOW fonctionnaient chez moi)
 
pour les UD3 d'unsloth, toujours pas OK sous LMstudio (feignant inside), je vais/il faut tester avec llama.cpp :o


encore LMstudio :( ils doivent avoir une version de llama.cpp qui a 1000 ans qui supporte pas un des quants d'un layer K_L de Swift.
Tu perds vraiment ton temps (et celui de ton CPU) avec ce soft moisi...


---------------
Faudra que je teste un jour :o
n°50480
Pipould's
Posté le 23-09-2026 à 20:43:17  profilanswer
 

the_fennec a écrit :


encore LMstudio :( ils doivent avoir une version de llama.cpp qui a 1000 ans qui supporte pas un des quants d'un layer K_L de Swift.
Tu perds vraiment ton temps (et celui de ton CPU) avec ce soft moisi...


Il faut passer par la...
 
Perso j'ai fait:
Ollama sous win  
Lemonade sous linux
et maintenant VLLM / Halogen FTW.
 
Une fois que t'as compris la notion de session context et kv-cache reuse, t'as un enorme step up a utiliser vllm.


Message édité par Pipould's le 23-09-2026 à 20:43:51
n°50485
tfpsly
Sly
Posté le 23-09-2026 à 21:31:26  profilanswer
 

Un Qwen 3.8 27B en 11,8gb https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
Je le teste depuis plusieurs heures : il a l'air de fonctionner aussi bien que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW (ressenti, pas une mesure scientifique) - mais en libérant presque 1gb, ce qui permet de bien augmenter la taille du contexte. Utile pour du développement assez poussé.

n°50509
moyen_moin​s
chat réincarné
Posté le 23-09-2026 à 23:56:21  profilanswer
 

the_fennec a écrit :


encore LMstudio :( ils doivent avoir une version de llama.cpp qui a 1000 ans qui supporte pas un des quants d'un layer K_L de Swift.
Tu perds vraiment ton temps (et celui de ton CPU) avec ce soft moisi...


Je sais faut que je me bouge  :D

 Page :   1  2  3  4  5  ..  68  69  70  71  72  73
Page Suivante

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)