Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4488 connectés 


Je génère ...


8.3 %
 2 votes
1.  moins de 100k tokens par jour
 
 
4.2 %
 1 vote
2.  entre 100k et 500k tokens par jour
 
 
8.3 %
 2 votes
3.  Entre 500 et 1M de tokens par jour
 
 
8.3 %
 2 votes
4.  Entre 1M et 5M de tokens par jour
 
 
4.2 %
 1 vote
5.  5M+
 
 
12.5 %
 3 votes
6.  10M+
 
 
20.8 %
 5 votes
7.  La quantité c'est dans la tête, tout est dans la qualité du jeton
 
 
20.8 %
 5 votes
8.  Quand on aime on ne compte pas (j'en ait aucune idée :o )
 
 
4.2 %
 1 vote
9.  C'est quoi ce token maxing de merde ? je dedrap le topic !
 
 
8.3 %
 2 votes
10.  zero, je lurke et je produis mon token seulement biologiquement
 

Total : 25 votes (1 vote blanc)
Sondage à 3 choix possibles.
Ce sondage est clos, vous ne pouvez plus voter
 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  68  69  70  71  72  73
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°49823
epsiloncen​taury
Posté le 20-09-2026 à 15:22:33  profilanswer
 

Reprise du message précédent :
Certains utilisent ici kolboldCpp ?  
 
Parce que je trouve étonnant qu'il n'ait pas plus de succès vu tout ce qu'il peut faire en local.  
Je suis tombé dessus un peu par hasard au départ, parce que je cherchais surtout une solution qui fonctionne avec ma première config assez particulière. J’avais essayé pas mal de trucs avant, avec des résultats plus ou moins convaincants. C'est le seul à pourvoir exploiter CUDA/VULCAN de manière très simple et efficacement pour un débutant comme moi.   :D  
 
C'est qu'au fil des semaines que j'ai découvert toutes ses fonctionnalités. Son interface web est aussi bourrée de fonctionnalité,  mais le design est très moche, je trouve..  
 
https://img3.super-h.fr/images/2026 [...] 065076.png
 
C'est bien simple, il peut tout faire. Petit à petit, j’ai découvert le côté vision, images, audio, Whisper, TTS, puis les embeddings, les outils, MCP, etc. Certaines choses restent encore assez mystérieuses pour moi...  
 
Je me suis également rendu compte que j’étais complètement passé à côté de la Wiki, qui m’aurait probablement permis de comprendre beaucoup plus simplement et surtout rapidement le fonctionnement de l’ensemble.
 
Et maintenant je découvre même les deux packs tout-en-un qui permettent de réunir plusieurs de ces fonctions avec des modèles déjà préparés.  
PackV2:
https://img3.super-h.fr/images/2026 [...] ot_711.png
 
Tout passe par des fichiers de modèles que KoboldCpp sait gérer, principalement des .GGUF ou des .bin. Pas besoin d’installer Whisper à part, de monter un serveur TTS séparé ou de faire communiquer une multitude de logiciels entre eux.  Je peux même faire des recherches Web une fois configurer le MCP.  
Et franchement, je trouve ça assez incroyable de pouvoir générer des images, parler avec l’IA, lui faire écouter de l’audio, utiliser la vision, le tout au même endroit, avec une configuration qui est loin d’être puissante. :)  
 
https://img3.super-h.fr/images/2026 [...] 710.th.pnghttps://img3.super-h.fr/images/2026 [...] 709.th.pnghttps://img3.super-h.fr/images/2026 [...] 708.th.pnghttps://img3.super-h.fr/images/2026 [...] 707.th.png
 

n°49827
SynE
Agri du dessert
Posté le 20-09-2026 à 16:21:01  profilanswer
 

Bon lm studio sur cpu, avec deux xeon silver 4114 en avx2 et 96Gb de DDR4 2400
 
Qwen3.8-27b@q6_k_m
 
C'est lent, moins de 2T/s :o

n°49832
the_fennec
f3nn3cUs z3rd4
Posté le 20-09-2026 à 17:02:38  profilanswer
 

epsiloncentaury a écrit :

Certains utilisent ici kolboldCpp ?  
 
Parce que je trouve étonnant qu'il n'ait pas plus de succès vu tout ce qu'il peut faire en local.  
Je suis tombé dessus un peu par hasard au départ, parce que je cherchais surtout une solution qui fonctionne avec ma première config assez particulière. J’avais essayé pas mal de trucs avant, avec des résultats plus ou moins convaincants. C'est le seul à pourvoir exploiter CUDA/VULCAN de manière très simple et efficacement pour un débutant comme moi.   :D  
 
C'est qu'au fil des semaines que j'ai découvert toutes ses fonctionnalités. Son interface web est aussi bourrée de fonctionnalité,  mais le design est très moche, je trouve..  
 
https://img3.super-h.fr/images/2026 [...] 065076.png
 
C'est bien simple, il peut tout faire. Petit à petit, j’ai découvert le côté vision, images, audio, Whisper, TTS, puis les embeddings, les outils, MCP, etc. Certaines choses restent encore assez mystérieuses pour moi...  
 
Je me suis également rendu compte que j’étais complètement passé à côté de la Wiki, qui m’aurait probablement permis de comprendre beaucoup plus simplement et surtout rapidement le fonctionnement de l’ensemble.
 
Et maintenant je découvre même les deux packs tout-en-un qui permettent de réunir plusieurs de ces fonctions avec des modèles déjà préparés.  
PackV2:
https://img3.super-h.fr/images/2026 [...] ot_711.png
 
Tout passe par des fichiers de modèles que KoboldCpp sait gérer, principalement des .GGUF ou des .bin. Pas besoin d’installer Whisper à part, de monter un serveur TTS séparé ou de faire communiquer une multitude de logiciels entre eux.  Je peux même faire des recherches Web une fois configurer le MCP.  
Et franchement, je trouve ça assez incroyable de pouvoir générer des images, parler avec l’IA, lui faire écouter de l’audio, utiliser la vision, le tout au même endroit, avec une configuration qui est loin d’être puissante. :)  
 
https://img3.super-h.fr/images/2026 [...] 710.th.pnghttps://img3.super-h.fr/images/2026 [...] 709.th.pnghttps://img3.super-h.fr/images/2026 [...] 708.th.pnghttps://img3.super-h.fr/images/2026 [...] 707.th.png


Perso je reste sur llama.cpp car j'ai les updates bien plus vite et ya pas de bidouilles spéciales a faire en plus. Si un nouveau modèle ou une nouvelle fonctionnalité sort, je me pose pas de questions, il marchera d'abord sur llama.cpp. De plus ça me permet d'utiliser le max de mémoire, rien de gâché avec des UI ou fonctionnalités que j'utilise pas. Dernier point, j'ai 3 machines, donc support RPC obligatoire.
 

SynE a écrit :

Bon lm studio sur cpu, avec deux xeon silver 4114 en avx2 et 96Gb de DDR4 2400
 
Qwen3.8-27b@q6_k_m
 
C'est lent, moins de 2T/s :o


C'est pas mal pour du CPU!
essaye ik_llama.cpp il a des tunings CPU


---------------
Faudra que je teste un jour :o
n°49833
SynE
Agri du dessert
Posté le 20-09-2026 à 17:06:41  profilanswer
 

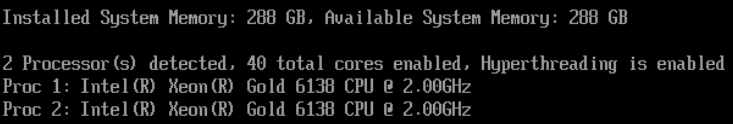
Je vais chercher le carton avec la paire de xeon gold 6138 que j'avais pris pour l'upgrade, et lui coller 192Go de ram de plus voir.

n°49834
the_fennec
f3nn3cUs z3rd4
Posté le 20-09-2026 à 17:12:12  profilanswer
 

SynE a écrit :

lui coller 192Go de ram de plus voir.


 :love:  [:thana54:4]


---------------
Faudra que je teste un jour :o
n°49835
the_fennec
f3nn3cUs z3rd4
Posté le 20-09-2026 à 17:18:18  profilanswer
 

Bon j'ai passé mon WE a tester Qwen3.8-Flash-Next-GSQ-RCO-GGUF:
https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
 
J'ai testé Q2_0 et IQ3_XXS.
Après pas mal de tuning j'arrive a mettre l'un et l'autre a 100% en VRAM,  
 
Q2_0 => 90/s en PP et 16/s en TG
IQ3_XXS => 80/s et 9/s
 
Mais après plusieurs heures de processing le IQ3_XXS s'est mis a boucler et juste générer des ////
 
Donc retour aux valeurs sure et Unsloth :jap:


---------------
Faudra que je teste un jour :o
n°49838
SynE
Agri du dessert
Posté le 20-09-2026 à 18:22:10  profilanswer


Manque plus que des GPU :o
 
https://rehost.diberie.com/Picture/Get/f/545640

Message cité 2 fois
Message édité par SynE le 20-09-2026 à 18:25:07
n°49839
the_fennec
f3nn3cUs z3rd4
Posté le 20-09-2026 à 18:24:44  profilanswer
 

SynE a écrit :


Manque plus que des GPU :o  


J'ai une 1650 Super 4GB si tu veux :o


---------------
Faudra que je teste un jour :o
n°49840
SynE
Agri du dessert
Posté le 20-09-2026 à 18:25:31  profilanswer
 

Na c'est juste pour des tests, au pire j'ai une 2080 dans mon pc et les bc250

n°49866
M300A
Posté le 20-09-2026 à 21:43:44  profilanswer


Vieux proliant ?


---------------
:wq
n°49882
SynE
Agri du dessert
Posté le 20-09-2026 à 22:50:11  profilanswer
 

M300A a écrit :


Vieux proliant ?


ML350 gen10 :jap:
 
Il me manque 3 stick de 16Go pour avoir 2x196Go, c'est beaucoup mais ça permet de tester avec plus de ram sur un seul noeud numa.
 
J'attends aussi une carte pcie vers nvme x4 pour mettre les modèles sur du ssd rapide en raid 0 software (j'ai des 256...), actuellement je suis sur un raid de disques sas 10k.
 
En tous cas je trouve que les réponses avec des gros modèles sont sympa, en restant cohérentes sur des réponses longues, c'est juste très lent  :lol:  

n°49891
tfpsly
Sly
Posté le 21-09-2026 à 00:10:26  profilanswer
 

Un autre Qwen 3.8 en Q4 qui tient en 12.9gb - ce qui permet avec 16gb de VRAM d'avoir un context bien plus large - je teste avec context_size=120000. Plus lent (27 à 40 tk/s) que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW.gguf (45 à 60 tk/s), mais beaucoup moins de phase de compression du contexte. A voir si ce n'est pas plus efficace au final...
 
https://huggingface.co/hitsfmdj/Qwe [...] .2BPW-16GB

Code :
  1. llama-server -m ~/models/Qwen3.8-27B-4.2BPW-16GB.gguf -c 120000 --parallel 1 -b 512 -ub 512 -ngl 99 --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --spec-type draft-mtp --spec-draft-n-max 2 --fit off --reasoning off --reasoning-budget 0 --chat-template-kwargs '{"reasoning_effort":"none"}' --port 8080

n°49893
neo world
Posté le 21-09-2026 à 01:55:58  profilanswer
 

tfpsly a écrit :

Un autre Qwen 3.8 en Q4 qui tient en 12.9gb - ce qui permet avec 16gb de VRAM d'avoir un context bien plus large - je teste avec context_size=120000. Plus lent (27 à 40 tk/s) que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW.gguf (45 à 60 tk/s), mais beaucoup moins de phase de compression du contexte. A voir si ce n'est pas plus efficace au final...
 
https://huggingface.co/hitsfmdj/Qwe [...] .2BPW-16GB

Code :
  1. llama-server -m ~/models/Qwen3.8-27B-4.2BPW-16GB.gguf -c 120000 --parallel 1 -b 512 -ub 512 -ngl 99 --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --spec-type draft-mtp --spec-draft-n-max 2 --fit off --reasoning off --reasoning-budget 0 --chat-template-kwargs '{"reasoning_effort":"none"}' --port 8080


Si tu as besoin de ce contexte c’est très bien mais note que la compression sera moins fréquente mais plus longue avec un gros contexte et sur le pre processing sera plus long à chaque fois que ça ne tombe pas en cache :jap:

n°49898
tfpsly
Sly
Posté le 21-09-2026 à 07:39:53  profilanswer
 

Après l'avoir testé rapidement, je le trouve plus con que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW, partant dans des modifications non nécessaires et n'ayant rien à voir avec le problème. Il a imaginé un bug et est parti s'entêter dans un coin de ma code base qui n'avait rien à voir.
Je reste sur Qwen3.8-27B-Uncensored-IQ4_XS_4BPW avec un contexte de 62k.


Message édité par tfpsly le 21-09-2026 à 09:18:59
n°49917
lapin
Posté le 21-09-2026 à 10:25:09  profilanswer
 

Pour ceux que ça intéresse, voici le lien vers le Diagramme de Llama.cpp: https://gitdiagram.com/ggml-org/llama.cpp

n°49920
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 10:50:17  profilanswer
 

tfpsly a écrit :

Un autre Qwen 3.8 en Q4 qui tient en 12.9gb - ce qui permet avec 16gb de VRAM d'avoir un context bien plus large - je teste avec context_size=120000. Plus lent (27 à 40 tk/s) que Qwen3.8-27B-Uncensored-IQ4_XS_4BPW.gguf (45 à 60 tk/s), mais beaucoup moins de phase de compression du contexte. A voir si ce n'est pas plus efficace au final...
 
https://huggingface.co/hitsfmdj/Qwe [...] .2BPW-16GB

Code :
  1. llama-server -m ~/models/Qwen3.8-27B-4.2BPW-16GB.gguf -c 120000 --parallel 1 -b 512 -ub 512 -ngl 99 --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --spec-type draft-mtp --spec-draft-n-max 2 --fit off --reasoning off --reasoning-budget 0 --chat-template-kwargs '{"reasoning_effort":"none"}' --port 8080


Si tu veux tu peux tester --no-kv-offload qui mets le KV cache en RAM au lieu de VRAM. Chez moi ça je perds un bin tier en PP (90->60) sur Qwen Next, mais ça peut le faire si tu as de la RAM rapide. Tu peux peut être rattraper en augmentant le -ub et si t'as plein de RAM essayer le KV non compressé.


---------------
Faudra que je teste un jour :o
n°49922
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 11:03:02  profilanswer
 

bon, finalement, qwen 3.8 27B gsq rco m'a fait des trucs assez moyens avec le mode de réflexion en LOW
faudrait que je recommence en mettant peut être MEDIUM mais flemme (déjà 10h+ de génération de tokens en LOW à 25t/s de moyenne et du pp à 300t/s) :(
faudrait vraiment qu'une boite propose une carte dédiée inférence avec 48Go de mémoire et une BP pas ridicule (entre une 4090 et une 5090 pour "limiter" l'envolée des prix) :o

n°49924
Pipould's
Posté le 21-09-2026 à 11:14:16  profilanswer
 

Bon, halogen pour strix a sauve mon espoir dans cette machine ! Ca marche vraiment bien :-)

n°49926
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 11:31:27  profilanswer
 

moyen_moins a écrit :

bon, finalement, qwen 3.8 27B gsq rco m'a fait des trucs assez moyens avec le mode de réflexion en LOW
faudrait que je recommence en mettant peut être MEDIUM mais flemme (déjà 10h+ de génération de tokens en LOW à 25t/s de moyenne et du pp à 300t/s) :(
faudrait vraiment qu'une boite propose une carte dédiée inférence avec 48Go de mémoire et une BP pas ridicule (entre une 4090 et une 5090 pour "limiter" l'envolée des prix) :o


Pas mal de gens se sont plains sur HF de ça et le gars a répondu que le tuning n'est fait que en xhigh. J'ai eu des soucis avec son Qwen Next, je repasse sur Unsloth. Au final pas de miracle, il vaut mieux rester sur des providers fiables pour pas perdre son temps.


---------------
Faudra que je teste un jour :o
n°49927
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 11:36:11  profilanswer
 

Pipould's a écrit :

Bon, halogen pour strix a sauve mon espoir dans cette machine ! Ca marche vraiment bien :-)


oui, fallait que la communauté fasse encore des miracles mais c'est vraiment une super nouvelle [:xp1700]

the_fennec a écrit :


Pas mal de gens se sont plains sur HF de ça et le gars a répondu que le tuning n'est fait que en xhigh. J'ai eu des soucis avec son Qwen Next, je repasse sur Unsloth. Au final pas de miracle, il vaut mieux rester sur des providers fiables pour pas perdre son temps.


Faudrait que je tente un iq4xs (j'ai besoin de contexte mais pas envie que le truc soit brain dead sur les "connaissances" ) mais les dernières releases unsloth marchaient pas chez moi, je les avais un peu laissé de côté. le Q4+ d'atomic chat semblait pas mal mais lent. :/

n°49929
lapin
Posté le 21-09-2026 à 12:00:45  profilanswer


Il est un peux moins débile, mais lent:
 
Voir les options:

Citation :


llama-server.exe -hf google/gemma-4-31B-it-qat-q4_0-gguf -c 11996 -b 4096 -ub 2048 --numa isolate -kvo -ngl 8 -t 16 -fa on --host 127.0.0.1 --port 8080


L'image: https://www.dropbox.com/scl/fi/p3ln56omyht4z3xwrwgyg/Xct3mgs.png?rlkey=27wxhwxgjwjrkaqqbdi8xyj83&st=doolltvl&dl=1
 
Le prompte:

Citation :

À partir de l'image Xct3mgs.png, génère un script au format SVG, le fond de l'image du script SVG doit être blanc de définition 500 pixels de large par 595 pixels de hauteur


Résulat du SVG par l'IA:
 

Citation :


<svg width="500" height="595" viewBox="0 0 500 595" xmlns="http://www.w3.org/2000/svg">
  <!-- Fond blanc -->
  <rect width="500" height="595" fill="white" />
 
  <!-- Dessin du parallélogramme et des segments internes -->
  <!-- Points: A(50,50), B(450,200), C(450,450), G(50,300) -->
  <polyline points="50,50 450,200 450,450 50,300 50,50" fill="none" stroke="black" stroke-width="2" />
   
  <!-- Segment EF (Vertical) : E(250,125), F(250,375) -->
  <line x1="250" y1="125" x2="250" y2="375" stroke="black" stroke-width="2" />
   
  <!-- Segment DH : D(50,175), H(250,250) -->
  <line x1="50" y1="175" x2="250" y2="250" stroke="black" stroke-width="2" />
 
  <!-- Étiquettes des points -->
  <text x="40" y="45" font-family="Arial" font-size="20" text-anchor="end">A</text>
  <text x="460" y="205" font-family="Arial" font-size="20" text-anchor="start">B</text>
  <text x="460" y="455" font-family="Arial" font-size="20" text-anchor="start">C</text>
  <text x="40" y="305" font-family="Arial" font-size="20" text-anchor="end">G</text>
  <text x="260" y="125" font-family="Arial" font-size="20" text-anchor="start">E</text>
  <text x="260" y="385" font-family="Arial" font-size="20" text-anchor="start">F</text>
  <text x="40" y="180" font-family="Arial" font-size="20" text-anchor="end">D</text>
  <text x="260" y="255" font-family="Arial" font-size="20" text-anchor="start">H</text>
</svg>


https://www.dropbox.com/scl/fi/u618 [...] 5cxzg&dl=1
 
On y est presque.

n°49932
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 12:31:04  profilanswer
 

moyen_moins a écrit :


Faudrait que je tente un iq4xs (j'ai besoin de contexte mais pas envie que le truc soit brain dead sur les "connaissances" ) mais les dernières releases unsloth marchaient pas chez moi, je les avais un peu laissé de côté. le Q4+ d'atomic chat semblait pas mal mais lent. :/


Atomic chat, pareil que GSQ RCO en pire, au final pour arriver a un Q4 qui fait la taille d'un Q2, tout est en Q2 dedans sauf deux tensors. Au bout d'un moment j'avais des boucles de //// dans le thinking.
 
C'est quoi qui n'allait pas avec Unsloth? T'est sur llama.cpp?


---------------
Faudra que je teste un jour :o
n°49935
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 13:16:58  profilanswer
 

the_fennec a écrit :


Atomic chat, pareil que GSQ RCO en pire, au final pour arriver a un Q4 qui fait la taille d'un Q2, tout est en Q2 dedans sauf deux tensors. Au bout d'un moment j'avais des boucles de //// dans le thinking.


C'est quoi qui n'allait pas avec Unsloth? T'est sur llama.cpp?


j'avais des "the model has nothing to say" bien que le modèle se chargeait comme il fallait.
j'ai pas testé avec llama.cpp directement mais avec lmstudio (flemme :o) ça merdait.
et leur truc d'inférence à unsloth là, j'aimais pas :/


edit: on tombe sur de ces trucs sur hugginface => https://huggingface.co/Atomic-Germ/ [...] 17.8B-GGUF [:paysan]

Message cité 1 fois
Message édité par moyen_moins le 21-09-2026 à 13:20:13
n°49936
speedboyz3​0
Guide Michelin :o
Posté le 21-09-2026 à 13:18:28  profilanswer
 

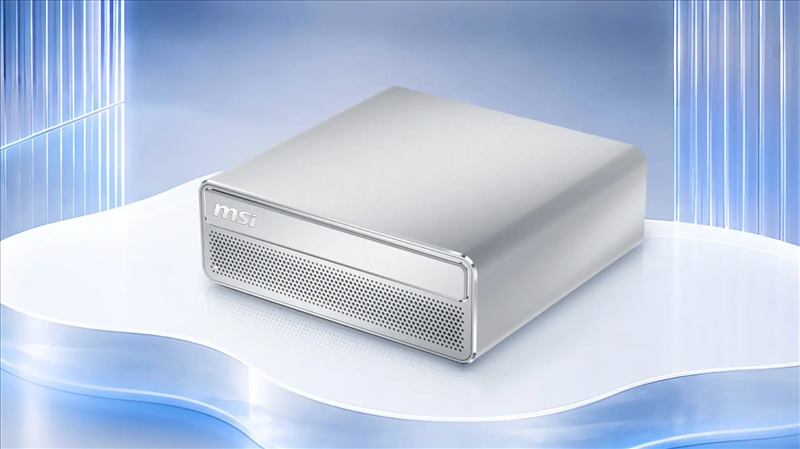
Nouveau Mini-PC MSI sous NVIDIA RTX Spark : le EdgeMesa N AI+
 
Plutôt mignon :
 
https://rehost.diberie.com/Picture/Get/r/545830
 
Toujours pas de prix...
 
https://videocardz.com/newz/msi-ann [...] gb-lpddr5x
 
Quelle est la proba que les prix soient dingues, et que ça fasse encore augmenter tout ce qui est déjà sur le marché ? Ça semble se dessiner...
 
Le DGX Spark voit son tarif exploser avant l'arrivée des RTX Spark:
 
https://videocardz.com/newz/dgx-spa [...] pcs-launch
 
J'attends vraiment les perfs du M5M et M5U pour me décider  [:la chancla:1]

n°49944
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 14:31:44  profilanswer
 

moyen_moins a écrit :


j'avais des "the model has nothing to say" bien que le modèle se chargeait comme il fallait.
j'ai pas testé avec llama.cpp directement mais avec lmstudio (flemme :o) ça merdait.  
et leur truc d'inférence à unsloth là, j'aimais pas :/
 
edit: on tombe sur de ces trucs sur hugginface => https://huggingface.co/Atomic-Germ/ [...] 17.8B-GGUF [:paysan]


Tu as du prendre un UD3 que LMStudio supporte pas, pas besoin D'Unsloth Studio, tout est dans llama.cpp, mis a par le MTP pour Qwen Next il me semble.


---------------
Faudra que je teste un jour :o
n°49946
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 14:32:59  profilanswer
 

speedboyz30 a écrit :

Nouveau Mini-PC MSI sous NVIDIA RTX Spark : le EdgeMesa N AI+
 
Plutôt mignon :
 
https://rehost.diberie.com/Picture/Get/r/545830
 
Toujours pas de prix...
 
https://videocardz.com/newz/msi-ann [...] gb-lpddr5x
 
Quelle est la proba que les prix soient dingues, et que ça fasse encore augmenter tout ce qui est déjà sur le marché ? Ça semble se dessiner...


Ça va être hors de prix et se vendre comme des petits pains :o


---------------
Faudra que je teste un jour :o
n°49949
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 14:50:34  profilanswer
 

the_fennec a écrit :


Tu as du prendre un UD3 que LMStudio supporte pas, pas besoin D'Unsloth Studio, tout est dans llama.cpp, mis a par le MTP pour Qwen Next il me semble.


bon, faut que je tente, de toute façon, ça fait partie des points qu'il fallait que je valide pour le truc sur lequel je planche.
donc direct llama.cpp. :jap:

n°49950
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 15:00:43  profilanswer
 

moyen_moins a écrit :


bon, faut que je tente, de toute façon, ça fait partie des points qu'il fallait que je valide pour le truc sur lequel je planche.
donc direct llama.cpp. :jap:


Bien, un de plus dans le droit chemin :o


---------------
Faudra que je teste un jour :o
n°49951
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 15:10:48  profilanswer
 

the_fennec a écrit :


Bien, un de plus dans le droit chemin :o


De toute façon, pas le choix, ça fait partie des choses à valider (le choix du "moteur" : local (via llamaserver ou lmstudio) ou "cloud" ) :ange:

n°49955
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 21-09-2026 à 15:39:41  profilanswer
 

Toi aussi par la sainte lumière tu as été touchée, mais n'oublie pas ton fidèle allié le scotch pour allez encore plus loin [:xtech93:1]


---------------
Victime de girafophobie, mais se soigne.
n°49957
moyen_moin​s
chat réincarné
Posté le 21-09-2026 à 15:42:21  profilanswer
 

Tronklou a écrit :

Toi aussi par la sainte lumière tu as été touchée, mais n'oublie pas ton fidèle allié le scotch pour allez encore plus loin [:xtech93:1]


je vais faire plus sale encore :o
mon adaptateur nvme pcie arrive (via câble occulink), je vais relancer le bc-250 à base de ventilateurs qui tiennent avec des rilsan et compagnie :o

n°49958
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 21-09-2026 à 15:42:47  profilanswer
 

Le riselan, tout de suite le gout du luxe :O


---------------
Victime de girafophobie, mais se soigne.
n°49961
lapin
Posté le 21-09-2026 à 15:56:28  profilanswer
 

Version b11070 du moteur Llama.cpp:


Configuration:

Citation :

llama-server.exe -hf google/gemma-4-31B-it-qat-q4_0-gguf -c 4396 -b 9896 -ub 2336 --numa isolate -kvo -ngl 8 -t 16 -fa on --host 127.0.0.1 --port 8080


Prompte:
 
image à copier : https://www.dropbox.com/scl/fi/p3ln56omyht4z3xwrwgyg/Xct3mgs.png?rlkey=27wxhwxgjwjrkaqqbdi8xyj83&st=vpj6v2tg&dl=1

Citation :


À partir de l'image Xct3mgs.png, génère un script au format SVG, le fond de l'image du script SVG doit être blanc de définition 500 pixels de large par 595 pixels de hauteur


Résultat généré par Llama.cpp version b11070:

Citation :


<svg width="500" height="595" viewBox="0 0 500 595" xmlns="http://www.w3.org/2000/svg">
   
  <rect width="500" height="595" fill="white"></rect>


  <polyline points="50,50 450,200 450,500 50,450 50,50" fill="none" stroke="black" stroke-width="2"></polyline>
 
   
  <line x1="250" y1="125" x2="250" y2="475" stroke="black" stroke-width="2"></line>  
  <line x1="50" y1="250" x2="450" y2="500" stroke="black" stroke-width="2"></line>  
 
   
  <text x="40" y="45" font-family="Arial" font-size="16" text-anchor="end">A</text>
  <text x="460" y="210" font-family="Arial" font-size="16" text-anchor="start">B</text>
  <text x="460" y="510" font-family="Arial" font-size="16" text-anchor="start">C</text>
  <text x="40" y="460" font-family="Arial" font-size="16" text-anchor="end">G</text>
  <text x="40" y="260" font-family="Arial" font-size="16" text-anchor="end">D</text>
  <text x="260" y="130" font-family="Arial" font-size="16" text-anchor="start">E</text>
  <text x="260" y="490" font-family="Arial" font-size="16" text-anchor="start">F</text>
  </svg>


Résultat au format PNG:
 
 
https://www.dropbox.com/scl/fi/320viwlawyot2ieirmib1/r-sultats-test-iteration-55.png?rlkey=obl07ztn6qlfm6zz2f4gje2wk&st=2ztfu35c&dl=1
 
Bon le point C est légèrement trop bas, il n'aurait pas du créer de ligne entre F et C, le point F aurait dû être sensiblement plus bas que le point C.
Mais c'est un bon début.
En fait on revient à la case départ
 
le tout réalisé en: 4 367 tokens; 26min 38s; 2.73 t/s
 
Across all turns
Prompt tokens evaluated           241 tok
Tokens generated                   4 367 tok
This turn · KV cache
Prompt                                    241 tok
Generated                             4 367 tok
KV cache total                       4 608 tok
Avg speed                                  2.7t/s


Ça commence lentement à prendre forme, de quoi je n'en sais rien, mais ça prend forme !!!
 
 
Marrant avant y a genre 14 jours, j'avais vers 20 Tokens par seconde.


Message édité par lapin le 21-09-2026 à 15:57:37
n°50044
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 22:42:19  profilanswer
 

Vidéos du jour.
 
Can You Run Any LLM in Jev Mode Using llama.cpp?
Codacus
https://www.youtube.com/watch?v=bcGO7xre46o
 
TL;DR: Intéressant d'en savoir plus sur la hype Jev ... ça me sera pas utile :o
 
Bonsai 2 27B tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=ZzLHGHMXkEw
 
TL;DR: [:ramucho]

Message cité 1 fois
Message édité par the_fennec le 21-09-2026 à 22:43:05

---------------
Faudra que je teste un jour :o
n°50046
Fredouye
Shivers !
Posté le 21-09-2026 à 23:00:31  profilanswer
 

Petite mise à jour d'Open WebUI : https://github.com/open-webui/open- [...] ag/v0.11.4
 

Citation :

Far smaller slim image. A slim build now comes down at around 175 MB, near enough 89% smaller than the last release, the local models, the packages around them and the tools that installed them all gone from it; what that changes about the way an instance behaves is set out under Changed below and in the documentation.
 
Smaller standard image. The image no longer carries a second copy of Python, two sets of fonts nothing ever loaded, packages nothing imports, or the tool that installed them, taking about 170 MB off a standard build.


Effectivement :o
 

REPOSITORY                                       TAG                            CREATED             SIZE
ghcr.io/open-webui/open-webui                    0.11.4-slim                    About an hour ago   795MB
ghcr.io/open-webui/open-webui                    0.11.3-slim                    2 weeks ago         6.49GB


Message édité par Fredouye le 21-09-2026 à 23:05:00

---------------
Le dernier arrivé est fan de Phil Collins
n°50047
neo world
Posté le 21-09-2026 à 23:02:56  profilanswer
 

the_fennec a écrit :

Vidéos du jour.
 
Can You Run Any LLM in Jev Mode Using llama.cpp?
Codacus
https://www.youtube.com/watch?v=bcGO7xre46o
 
TL;DR: Intéressant d'en savoir plus sur la hype Jev ... ça me sera pas utile :o
 
Bonsai 2 27B tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=ZzLHGHMXkEw
 
TL;DR: [:ramucho]


J'ai obtenu un ticket pour tester JEV. Ce sera dans le pipe pour les prochaines semaines par curiosité (une second avis pour un pouillème de ce que coute un modèle chinois pas cher :D)
 
pour le truc bonsai je vis pas comment ça aurait pu finir autrement : soit tout le monde faisait de la grosse de merde depuis trois ans et ils faisaient un cadeau à l'humanité soit les poids servaient en fait à quelque chose  :whistle:  
 
merci pour le partage :jap:

n°50048
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 21-09-2026 à 23:06:50  profilanswer
 

Globalement j'ai jamais eu de "pépite cachée" dans les models : soit c'est génial et tout le monde en parle, soit c'est de la merde et tu vois que des bench sortis par les auteurs :D


---------------
Victime de girafophobie, mais se soigne.
n°50052
the_fennec
f3nn3cUs z3rd4
Posté le 21-09-2026 à 23:30:42  profilanswer
 

@neo, bon courage pour le test de Jev, ça n'a pas l'air évident!
 
@Tronklou
Ya aussi le cas tout le monde en parle mais c'est quand même de la merde, genre les tunings de DavidAU :o


---------------
Faudra que je teste un jour :o
n°50058
Pipould's
Posté le 22-09-2026 à 00:30:03  profilanswer
 

Swift-Qwen3.8-27B-PARO-int5


2× Radeon AI PRO R9700
TP2
8 sequences
8192-token chunk
262,144 maximum context
DFlash speculative decoding


https://i.ibb.co/YB4TTYPd/image.png


Message édité par Pipould's le 22-09-2026 à 00:31:00
n°50069
the_fennec
f3nn3cUs z3rd4
Posté le 22-09-2026 à 07:43:58  profilanswer
 

et c'est bien ou c'est pas bien?
:o


---------------
Faudra que je teste un jour :o
n°50074
neo world
Posté le 22-09-2026 à 08:23:41  profilanswer
 

Ça a l’air plus qu’utilisable même pour une petite équipe :D

 Page :   1  2  3  4  5  ..  68  69  70  71  72  73

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)