Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5216 connectés 


Avez-vous basculé sur ChatGPT Plus ?


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  510  511  512  ..  555  556  557  558  559  560
Auteur Sujet :

[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co

n°49744
XaTriX
Posté le 19-09-2026 à 16:30:51  profilanswer
 

Reprise du message précédent :
3x le cache input, genius :o


---------------
[:dawa]
n°49746
ezzz
23
Posté le 19-09-2026 à 16:42:27  profilanswer
 

Y a quand même des moments où je comprends plus rien à ce que vous racontez  :o


---------------
mon flick r - 23 - https://youtu.be/LAr6oAKieHk
n°49747
Olivie
SUUUUUUUUUUUUUU
Posté le 19-09-2026 à 16:45:26  profilanswer
 

ezzz a écrit :

Y a quand même des moments où je comprends plus rien à ce que vous racontez  :o


utiliser jev pour qu'il décide vers quel LLM rooter une demande.
Après ca pose d'autres soucis tel que le cache :o


---------------

n°49748
ezzz
23
Posté le 19-09-2026 à 16:46:33  profilanswer
 

Merci pour la traduction  :o


---------------
mon flick r - 23 - https://youtu.be/LAr6oAKieHk
n°49749
kaloskagat​os
Posté le 19-09-2026 à 16:49:52  profilanswer
 

XaTriX a écrit :

3x le cache input, genius :o


Ca veut dire quoi ? Que ça consomme plus parce que switch de modèle en cours de conversation ? Si c'est ça c'est con en effet.


---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°49750
loulou le ​marlou
Posté le 19-09-2026 à 16:52:18  profilanswer
 

Si je le comprends bien, le Le Cun, il dit que Gemini, Claude, Kimi, Mistral, ChatGPT, enfin les LLM, le deep learning, c'est de la daube parce que ça ne comprend pas le monde physique et que donc, il lui faut l'apprendre, en gros c'est ça ?

n°49751
Olivie
SUUUUUUUUUUUUUU
Posté le 19-09-2026 à 17:06:47  profilanswer
 

kaloskagatos a écrit :


Ca veut dire quoi ? Que ça consomme plus parce que switch de modèle en cours de conversation ? Si c'est ça c'est con en effet.


Oui tu consommes plus en changeant de modèle.  
Après si ca permet d'utiliser plus souvent un modèle qui coute 10x mois, t'es pas perdant au change  [:michel_cymerde:7]


---------------

n°49753
kaloskagat​os
Posté le 19-09-2026 à 17:59:20  profilanswer
 

loulou le marlou a écrit :

Si je le comprends bien, le Le Cun, il dit que Gemini, Claude, Kimi, Mistral, ChatGPT, enfin les LLM, le deep learning, c'est de la daube parce que ça ne comprend pas le monde physique et que donc, il lui faut l'apprendre, en gros c'est ça ?


Il dit qu'il faut l'entraîner sur autre chose que du texte, à raisonner sur des concepts abstraits plutôt que mot à mot, l'entraîner à planifier et gérer l'incertitude. Il donne comme exemple la tâche de se rendre à New-York en avion, ça veut dire commander un taxi, sortir de la maison en ouvrant la porte, descendre les marches, attendre le taxi, aller à l'aéroport, etc. Un LLM aura du mal à planifier et décomposer tout ça en une série d'actions atomiques.

Message cité 1 fois
Message édité par kaloskagatos le 19-09-2026 à 17:59:57

---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°49755
AllenMadis​on
Oracle du Keb's
Posté le 19-09-2026 à 18:44:17  profilanswer
 

ezzz a écrit :

Y a quand même des moments où je comprends plus rien à ce que vous racontez  :o


Ce monde va trop vite c'est fou :o


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°49757
AllenMadis​on
Oracle du Keb's
Posté le 19-09-2026 à 18:52:45  profilanswer
 

loulou le marlou a écrit :

Si je le comprends bien, le Le Cun, il dit que Gemini, Claude, Kimi, Mistral, ChatGPT, enfin les LLM, le deep learning, c'est de la daube parce que ça ne comprend pas le monde physique et que donc, il lui faut l'apprendre, en gros c'est ça ?

 
kaloskagatos a écrit :


Il dit qu'il faut l'entraîner sur autre chose que du texte, à raisonner sur des concepts abstraits plutôt que mot à mot, l'entraîner à planifier et gérer l'incertitude. Il donne comme exemple la tâche de se rendre à New-York en avion, ça veut dire commander un taxi, sortir de la maison en ouvrant la porte, descendre les marches, attendre le taxi, aller à l'aéroport, etc. Un LLM aura du mal à planifier et décomposer tout ça en une série d'actions atomiques.


Oui. En gros, il dit que ce qu'on a c'est du texte, pour tout ce qui est maths, programmation, analyse de texte, c'est génial, mais qu'en gros la prochaine étape c'est d'intégrer les paramètres de la physique et les interactions du monde. C'est pas idiot son propos, parce qu'on a une très grande capacité d'abstraction, de prédiction, anticipation, planification que les LLM n'ont pas. Un exemple simple, les LLM ne sont pas capable de faire de l'abstraction mathématique ou d'inventer des idées de maths, ou faire des conjectures mathématiques. Ca demande un degré d'abstraction qui n'existe pas dans un LLM basé sur le texte.


De fait, c'est effectivement une limite de ces modèles qu'il pointe justement. On va peut être pas dire "daubé", c'est même très bon pour ce que ça fait (traitement de texte/information) en revanche ça atteint vite ses limites dès que tu veux faire de l'abstraction/créer des idées nouvellles/appréhender l'environnement physique tout autour de nous... Ce sera probablement la prochaine génération d'IA, on passera des frontier models aux world models.


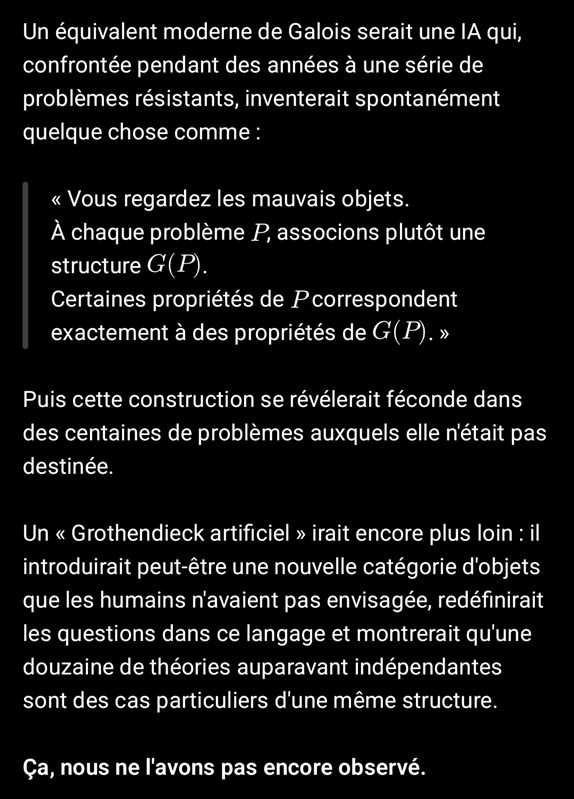
Un exemple simple, un LLM n'est pas actuellement capable d'inventer une théorie comme Galois l'avait fait, ou plus récemment Grothendiek. Ca illustre bien l'écart technologique que l'on a, entre les LLM actuels, et ce que sont capable de faire des humains. A l'inverse, les LLM ont une capacité d'apprendre qui est supérieure à celles des humains, donc ça a aussi ses avantages.


Mais ce qui est bien, c'est qu'il l'explique de manière très claire et très pédagogique, très accessible. Ca permet donc d'avoir un aperçu de vers quoi ça va évoluer ensuite !

Message cité 1 fois
Message édité par AllenMadison le 19-09-2026 à 18:56:50

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°49758
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 19-09-2026 à 19:13:04  profilanswer
 

Vous savez quoi faire :o
https://rehost.diberie.com/Picture/Get/f/545344


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°49761
XaTriX
Posté le 19-09-2026 à 20:08:43  profilanswer
 

kaloskagatos a écrit :


Ca veut dire quoi ? Que ça consomme plus parce que switch de modèle en cours de conversation ? Si c'est ça c'est con en effet.


Oui au changement de modèle tu recharges tout le contexte en cache et c'est ce qui coûte cher. Après ça se calcule et sinon tu peux aussi donner une tâche dans un sous agent sans tout le contexte.
Il me semble qu'Anthropic teste aussi le passage de cache chaud à d'autres modèles ou alors juste le changement d'effort ?


---------------
[:dawa]
n°49763
AllenMadis​on
Oracle du Keb's
Posté le 19-09-2026 à 20:45:53  profilanswer
 

crepator4 a écrit :

Citation :

Le gazier vient de lancer sa propre startup. Au bout d'une semaine d'existence, la levée de fonds est à 1 milliards de dollars :pt1cable:


Les formations d'oussama ça aide :o


je rigoleuh :o


Disons que développer un world model ou des IA type LLM ça coute cher, mais le jour ou ça marche et qu'il peut revendre l'utilisation de sa technologie aux entreprises, ça va lui rapporter encore plus (ainsi qu'aux investisseurs) ! Parce que la finalité de sa technologie, c'est l'application aux robots au final.


Message édité par AllenMadison le 19-09-2026 à 21:01:36

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°49774
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 19-09-2026 à 23:20:44  profilanswer
 

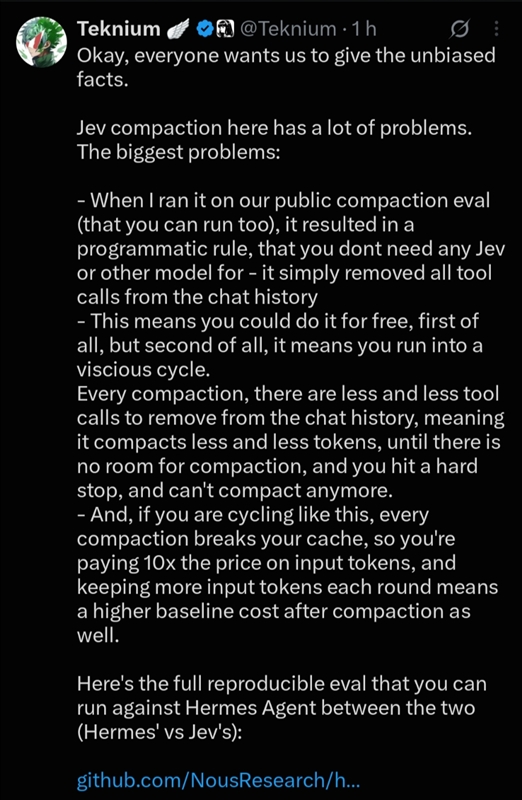
Je crois nous research après avoir le seum contre OpenClaw maintenant c'est contre jev
https://rehost.diberie.com/Picture/Get/r/545392
C'est un belge derrière? :O
https://x.com/Teknium/status/2101398453578555898


Message édité par bulldozer_fusion le 19-09-2026 à 23:21:34

---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°49778
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 19-09-2026 à 23:56:02  profilanswer
 

Olivie a écrit :


Y a $5 via leur site typesafe et y a de quoi tester vu le coût

 
kaloskagatos a écrit :


La révolution annoncée c'est que l'inférence se fait en parallèle pour toutes les questions qui sont posées dans le json qui fait partie du prompt et que les réponses sont justes numériques. Il peut bouffer énormément de texte en entrée et répondre à plusieurs question en quelques milli secondes. Ça change de l'approche des LLM qui mettent plusieurs secondes à répondre. Ça ouvre de nombreuses possibilités pour contrôler des systèmes en temps réel en langage naturel, ou faire des traitements intelligents à moindre coût.


Par contre le concept est une innovation, mais la réalisation ne doit pas être si difficile à reproduire. Donc on risque de retrouver rapidement ça en open source (y'a déjà des solutions sur github) ou dans l'assistant Google ou Siri.


J'ai pu regarder plus en détail, c'est très intéressant
Par contre c'est payant actuellement
J'attends les alternatives open source qui feront pareil pour m'y lancer  :jap:


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°49779
sinbadlema​rin
Posté le 20-09-2026 à 00:18:23  profilanswer
 

Cest moi ou Claude commence à prendre la confiance? Il me répond d'égal à égal et m'envoie chier quand je menace de me désabonner.  Du coup je retourne chez OpenAI :o

n°49781
kaloskagat​os
Posté le 20-09-2026 à 00:55:56  profilanswer
 

AllenMadison a écrit :


Oui. En gros, il dit que ce qu'on a c'est du texte, pour tout ce qui est maths, programmation, analyse de texte, c'est génial, mais qu'en gros la prochaine étape c'est d'intégrer les paramètres de la physique et les interactions du monde. C'est pas idiot son propos, parce qu'on a une très grande capacité d'abstraction, de prédiction, anticipation, planification que les LLM n'ont pas. Un exemple simple, les LLM ne sont pas capable de faire de l'abstraction mathématique ou d'inventer des idées de maths, ou faire des conjectures mathématiques. Ca demande un degré d'abstraction qui n'existe pas dans un LLM basé sur le texte.


De fait, c'est effectivement une limite de ces modèles qu'il pointe justement. On va peut être pas dire "daubé", c'est même très bon pour ce que ça fait (traitement de texte/information) en revanche ça atteint vite ses limites dès que tu veux faire de l'abstraction/créer des idées nouvellles/appréhender l'environnement physique tout autour de nous... Ce sera probablement la prochaine génération d'IA, on passera des frontier models aux world models.


Un exemple simple, un LLM n'est pas actuellement capable d'inventer une théorie comme Galois l'avait fait, ou plus récemment Grothendiek. Ca illustre bien l'écart technologique que l'on a, entre les LLM actuels, et ce que sont capable de faire des humains. A l'inverse, les LLM ont une capacité d'apprendre qui est supérieure à celles des humains, donc ça a aussi ses avantages.


Mais ce qui est bien, c'est qu'il l'explique de manière très claire et très pédagogique, très accessible. Ca permet donc d'avoir un aperçu de vers quoi ça va évoluer ensuite !


Ton post avec ce prompt donnent un résultat intéressant :o

Citation :

Quelles ruptures d'abstraction Galois et Grothendieck ont-ils introduites par rapport à l'état de l'art de leur époque, et en quoi ces sauts conceptuels illustrent-ils l'incapacité fondamentale des LLM (basés sur la prédiction textuelle) à générer de nouveaux cadres de pensée ?


---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°49782
kaloskagat​os
Posté le 20-09-2026 à 01:03:02  profilanswer
 

https://rehost.diberie.com/Picture/Get/r/545407


C'est vrai je suis con aussi :o
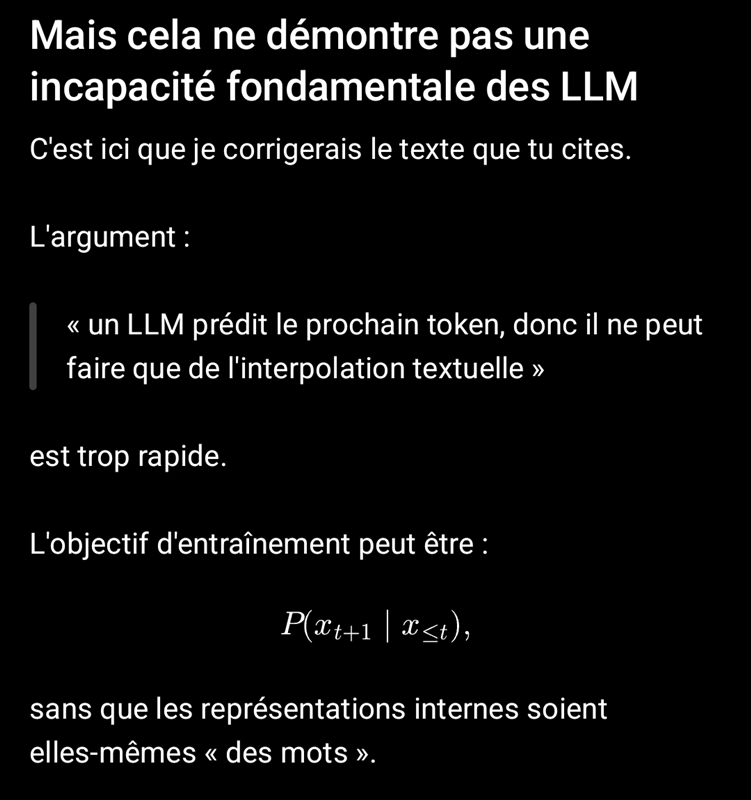
Bref il m'explique avec des sources que les LLM peuvent désormais découvrir des mathématiques nouvelles.
https://rehost.diberie.com/Picture/Get/r/545408

Message cité 1 fois
Message édité par kaloskagatos le 20-09-2026 à 01:09:31

---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°49783
AllenMadis​on
Oracle du Keb's
Posté le 20-09-2026 à 07:14:32  profilanswer
 

kaloskagatos a écrit :

https://rehost.diberie.com/Picture/Get/r/545407


C'est vrai je suis con aussi :o
Bref il m'explique avec des sources que les LLM peuvent désormais découvrir des mathématiques nouvelles.
https://rehost.diberie.com/Picture/Get/r/545408


Dououououououcement. Dis a chatgpt d'arrêter la drogue numérique, pour commencer :o Pour ce qui est de découvrir des maths nouvelles, on verra plus tard :o


Message édité par AllenMadison le 20-09-2026 à 07:15:14

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°49784
kaloskagat​os
Posté le 20-09-2026 à 08:03:55  profilanswer
 

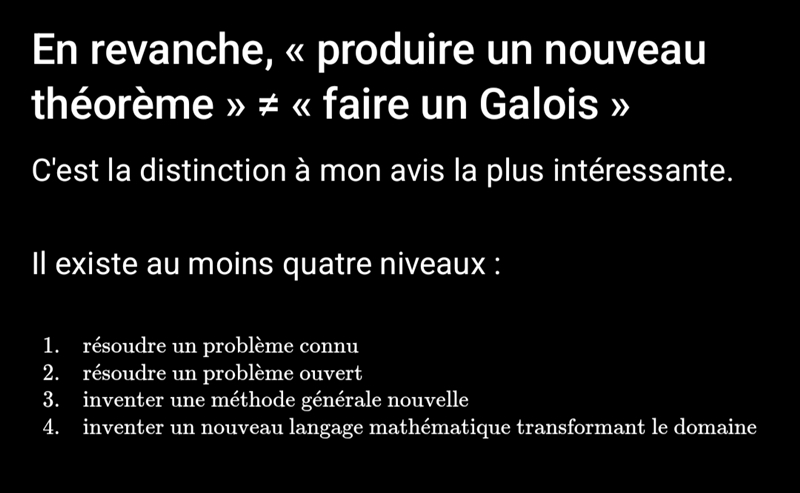
Non mais il est pas bourré hein, c'est juste que j'ai cité que des bouts.

 
Citation :

Les systèmes actuels ont clairement franchi 2, et commencent à montrer des éléments de 3.
Ce dont nous n'avons pas encore d'exemple convaincant est vraiment 4.


https://rehost.diberie.com/Picture/Get/r/545428


Bref, je connaissais pas les changement de paradigme introduits par ces mathématiciens, et la conclusion c'est que Lecun il dit pas que des conneries.


---------------
« Le hasard, c’est différent de la chance. Parce que la chance, je n'en ai jamais. »
n°49787
ionik
Posté le 20-09-2026 à 09:08:04  profilanswer
 

Dites sur Codex mon quota ne bouge pas (il reste a 100% restant) alors que je l'utilise depuis quelques jours.
 
Ou il balance des reset en chaine ce dont je doute :o
 
Quelqu'un a remarquer quelques chose de similaire ?


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°49788
Fredouye
Shivers !
Posté le 20-09-2026 à 09:12:21  profilanswer
 

Olivie a écrit :

utiliser jev pour qu'il décide vers quel LLM rooter une demande.
Après ca pose d'autres soucis tel que le cache :o

XaTriX a écrit :

Oui au changement de modèle tu recharges tout le contexte en cache et c'est ce qui coûte cher. Après ça se calcule et sinon tu peux aussi donner une tâche dans un sous agent sans tout le contexte.


J'ai joué un peu avec jev-router et Claude Code / Codex, il semble justement évaluer si un changement de modèle est "rentable" :

Citation :

• [Jev] routed this turn to gpt-reserve (downgrade-not-worth-cache-rebuild+unavailable, confidence 0.32).


---------------
Le dernier arrivé est fan de Phil Collins
n°49789
Olivie
SUUUUUUUUUUUUUU
Posté le 20-09-2026 à 09:15:23  profilanswer
 

ionik a écrit :

Dites sur Codex mon quota ne bouge pas (il reste a 100% restant) alors que je l'utilise depuis quelques jours.
 
Ou il balance des reset en chaine ce dont je doute :o
 
Quelqu'un a remarquer quelques chose de similaire ?


Tu utilises quel modèle ? Lance un gros prompt avec le modèle gpt-6 Astra et met le curseur tout à droite sur "Ultra" et donne nous des nouvelles


---------------

n°49791
Olivie
SUUUUUUUUUUUUUU
Posté le 20-09-2026 à 09:32:24  profilanswer
 

Citation :

@MelvinInvests
 
This is the real reasons Dario Amodei and OpenAI want tighter AI regulation because open models are rapidly taking over the market beneath them.
 
Vercel’s AI Gateway data shows that open weight models now account for 78.4% of token volume, compared with only 21.6% for closed models while Open models represented roughly 40% of token volume in June, meaning their share has nearly doubled in only three months.
 
DeepSeek V4.1 Flash alone generates 59.3% of the tokens moving through the gateway and by comparison, Claude Opus 4.8 and Claude Sonnet 5 each account for only 1.7% of token volume.
 
However, the spending data tells a very different story.
 
Closed models still capture a disproportionate amount of money because they charge much more per token.
 
Claude Opus 4.8 accounts for 13.7% of spending despite representing only 1.7% of token volume while Anthropic’s five listed Claude models collectively capture 36.9% of total spending.
 
DeepSeek V4.1 Flash has the opposite profile because it processes most of the tokens on the gateway but accounts for only 5.1% of spending, which shows how aggressively open models are competing on price.
 
This is the threat facing closed model companies.
 
Developers may still use expensive proprietary models for their hardest tasks but they are increasingly sending high volume workloads to cheaper open alternatives and as open models improve, developers could begin routing more premium workloads toward them as well.
 
Open weights also give companies more control over their infrastructure.
 
Developers can download these models, run them on different cloud providers, fine tune them for specific applications, and avoid depending entirely on one company’s API and this reduces the pricing power and customer lock in enjoyed by OpenAI and Anthropic.
 
If open models keep closing the performance gap, OpenAI and Anthropic could lose the one thing that matters most, pricing power.
 
https://pbs.twimg.com/media/HSmKseXaUAA3qpn?format=jpg&name=medium


---------------

n°49793
ionik
Posté le 20-09-2026 à 09:41:18  profilanswer
 

Olivie a écrit :


Tu utilises quel modèle ? Lance un gros prompt avec le modèle gpt-6 Astra et met le curseur tout à droite sur "Ultra" et donne nous des nouvelles


J'utilise quasi exclusivement en auditeur dans claude, avec GPT-6 sol High


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°49796
XaTriX
Posté le 20-09-2026 à 09:53:59  profilanswer
 

Fredouye a écrit :


J'ai joué un peu avec jev-router et Claude Code / Codex, il semble justement évaluer si un changement de modèle est "rentable" :

Citation :

• [Jev] routed this turn to gpt-reserve (downgrade-not-worth-cache-rebuild+unavailable, confidence 0.32).


 :love:


---------------
[:dawa]
n°49797
XaTriX
Posté le 20-09-2026 à 09:55:06  profilanswer
 

ionik a écrit :


J'utilise quasi exclusivement en auditeur dans claude, avec GPT-6 sol High


 :??:


---------------
[:dawa]
n°49798
Nr13
Posté le 20-09-2026 à 09:56:19  profilanswer
 

ChrisPc a écrit :


Le code du modèle ou ses fonctions maths qui lui permettent de répondre/ faire les choses.


c'est quoi le code du modèle? Ses milliards de paramètres? Il n'y a pas accès...

n°49799
AllenMadis​on
Oracle du Keb's
Posté le 20-09-2026 à 09:57:50  profilanswer
 

https://i.imgur.com/gRG60AY.png
 
September mirabilis


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°49800
Nr13
Posté le 20-09-2026 à 09:59:25  profilanswer
 

Fredouye a écrit :


On va vite avoir des trucs intéressants, comme https://github.com/gargpratyush/jev-router
 
https://github.com/gargpratyush/jev [...] picker.png
 

┌─────────────────────────────────┐
│ Jev Router                      │
│                                 │
│ Jev request                     │
│ Prompt: explain the router      │
│ Current tier: HAIKU             │
│ Context tokens: 6200            │
│                                 │
│ Jev response                    │
│ Task complexity     0.82        │
│ Reasoning required  0.91        │
│ Tool complexity     0.64        │
│ Context size        0.31        │
│                                 │
│ Recommended tier: SONNET        │
│ Selected model: SONNET          │
│                                 │
│ Confidence: 94%                 │
│ Decision: Jev recommendation    │
└─────────────────────────────────┘


Putain oui je pensais direct à ce concept là, ça marche bien?

n°49801
ionik
Posté le 20-09-2026 à 10:00:38  profilanswer


Sol High je sais pas pourquoi j'ai mis GPT 6 :o


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°49803
SuperSic
Posté le 20-09-2026 à 10:01:51  profilanswer
 

drap  [:drapal]


---------------
"Les soldats vivent. Et se demandent pourquoi." Toubib (La Compagnie noire) | [TU] Pronomoo
n°49804
Olivie
SUUUUUUUUUUUUUU
Posté le 20-09-2026 à 10:08:36  profilanswer
 

Nr13 a écrit :


Putain oui je pensais direct à ce concept là, ça marche bien?


Teste et dis nous, ca nous intéresse tous :o


---------------

n°49805
Nr13
Posté le 20-09-2026 à 10:12:40  profilanswer
 

Olivie a écrit :


Teste et dis nous, ca nous intéresse tous :o


Ben la grosse question c'est la qualité du corpus d'entrainement pour la classification des différents critères là.. et cette qualité inclue la proximité du corpus avec que toi ou moi on fait avec nos agents.. ça me parait tendu. Ca revient à peu à faire confiance aux benchmarks en tous genres qui existent déjà je trouve  :o

n°49825
Big Blue
Live/Psn/Nid legeantbleu
Posté le 20-09-2026 à 16:11:40  profilanswer
 

Fini la promo Deepseek V4.1 Flash chez command.ai :(


J’ai essayé V4 Flash chez eux qui offre autant de quotas que 4.1 mais pas aussi bien et le modèle est saturé ( 429 ).


Retour sur Luna… c’est lent et pas aussi autonome :( DsF4.1 est vraiment une merveille mais il me faut un quotas de 60-70$ par mois :o

Message cité 1 fois
Message édité par Big Blue le 20-09-2026 à 16:12:16
n°49826
sorg
trop sur HFR depuis 2001
Posté le 20-09-2026 à 16:16:45  profilanswer
 

Big Blue a écrit :

Fini la promo Deepseek V4.1 Flash chez command.ai :(
 
J’ai essayé V4 Flash chez eux qui offre autant de quotas que 4.1 mais pas aussi bien et le modèle est saturé ( 429 ).  
 
Retour sur Luna… c’est lent et pas aussi autonome :( DsF4.1 est vraiment une merveille mais il me faut un quotas de 60-70$ par mois :o


Chez ollama cloud, tu à 60$ de quota pour 20 $ par mois... Hors heures de pointes.

n°49830
Nr13
Posté le 20-09-2026 à 16:43:53  profilanswer
 

Il est toujours en promo chez opencode (60$ pour 10$)

n°49831
Big Blue
Live/Psn/Nid legeantbleu
Posté le 20-09-2026 à 16:52:53  profilanswer
 

Yep j’ai pris un peu d’avance, c’est ce soir la fin de promo.


Ollama … c’est cher :o 10$ juste pour 20$ de crédit en plus, autant prendre gpt a 23€ ou go et goat pour le même tarif :D


L’offre GOAT a 60$ était parfaite :o


Message édité par Big Blue le 20-09-2026 à 16:55:16
n°49844
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 20-09-2026 à 19:07:57  profilanswer
 

https://rehost.diberie.com/Picture/Get/f/545670
https://rehost.diberie.com/Picture/Get/f/545671
 :whistle: ambiance


Message édité par bulldozer_fusion le 20-09-2026 à 19:08:36

---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°49845
Olivie
SUUUUUUUUUUUUUU
Posté le 20-09-2026 à 19:14:17  profilanswer
 

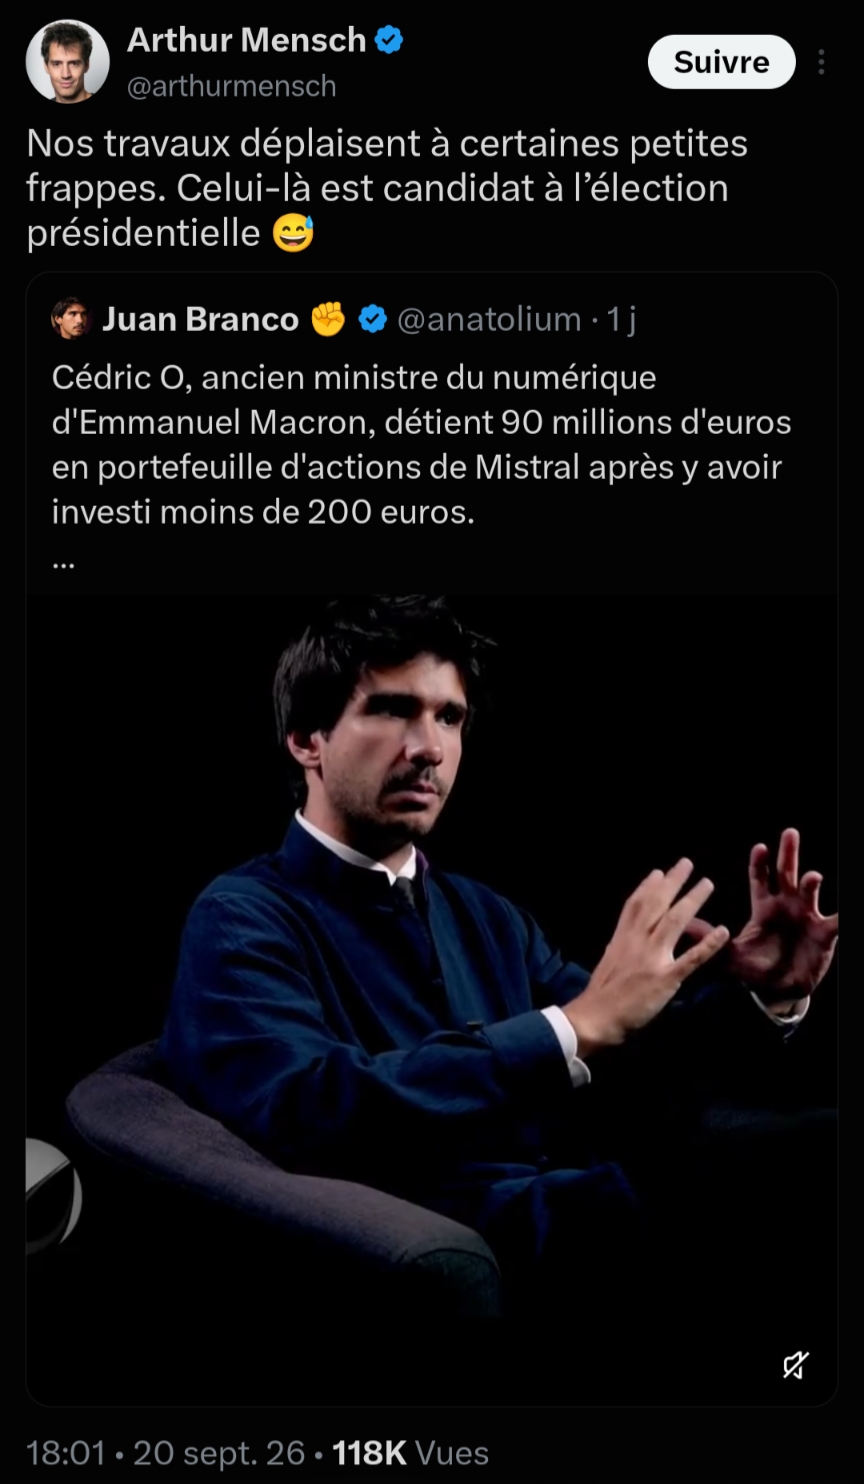
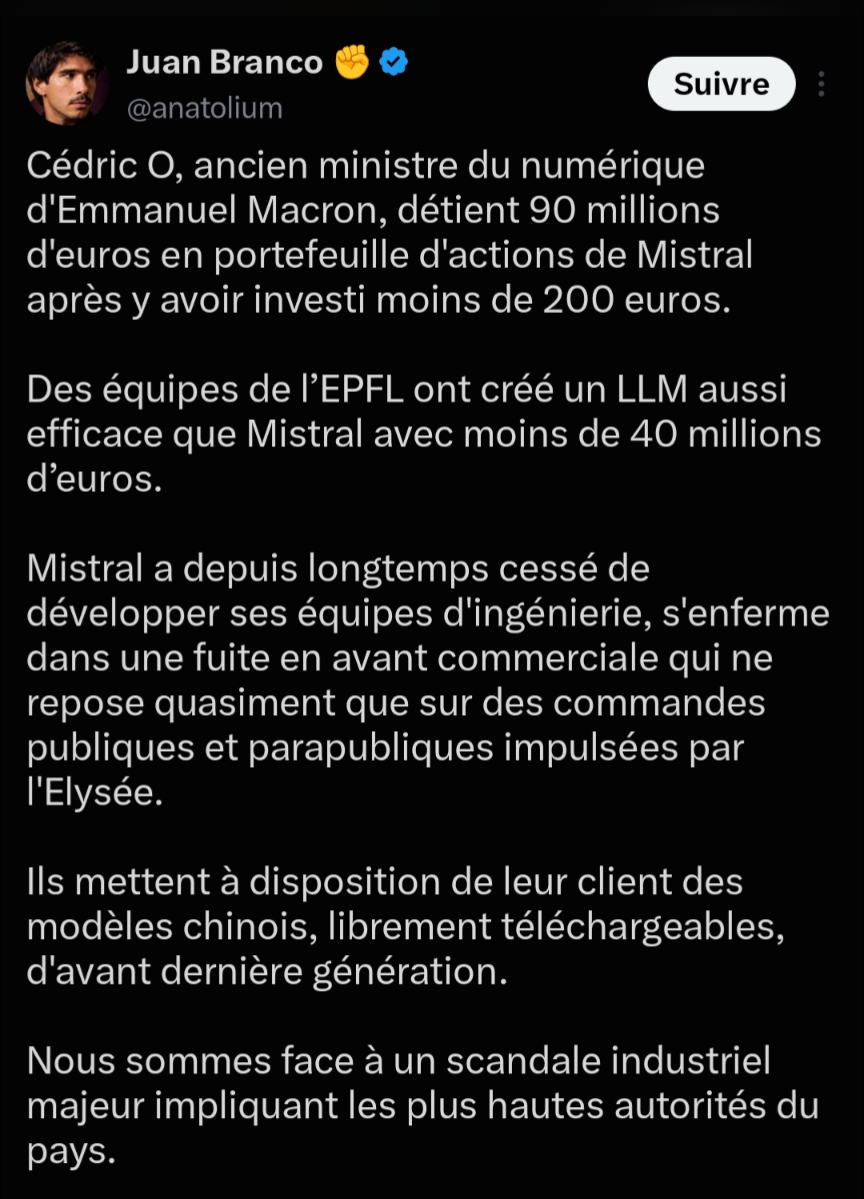
A-t-il tort ?


---------------

n°49847
MilesTEG1
Posté le 20-09-2026 à 19:23:07  profilanswer
 

Olivie a écrit :

A-t-il tort ?


Pas sûr !
Vu ce que j’ai comme résultats avec Vibe (Mistral), même ChatGPT gratuit ou Gemini font beaucoup mieux…
Je me suis pris un Google One Ai 5Go pour rien pendant 3 mois.
Ca fonctionne bien surtout en agent Antigravity.


---------------
Mes ventes : [FeedBack] http://forum.hardware.fr/hfr/Achat [...] 4599_1.htm
 Page :   1  2  3  4  5  ..  510  511  512  ..  555  556  557  558  559  560

Aller à :
Ajouter une réponse
 

Sujets relatifs
sécurité de l'IA / agentique et des Devs en roue libre 
Plus de sujets relatifs à : [Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)