Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4018 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  75  76  77  78  79  80
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°52048
the_fennec
f3nn3cUs z3rd4
Posté le 03-10-2026 à 12:47:18  profilanswer
 

Reprise du message précédent :

moyen_moins a écrit :


c'est ce que j'ai vu en vidéo aussi hier soir :jap:
mais bon, tant qu'on peut en profiter en avance :o


Tout fait :jap: après j'ai un peu la flemme car ya c'est du python et c'est toujours le merdier et qu'on plus ya pas de clustering, donc je suis juste avec un GPU.


---------------
Faudra que je teste un jour :o
n°52053
moyen_moin​s
chat réincarné
Posté le 03-10-2026 à 13:02:15  profilanswer
 

par contre, il y a un truc que je pige pas : j'utilise qwen 3.8 27B gsq rco sur un projet perso, j'ai 25t/s en pg, je l'utilise dans opencode branché sur le mcp home assitant, j'ai 13t/s (à peine) :??:
genre c'est le mtp qui doublerait le pg ? [:paysan]


Message édité par moyen_moins le 03-10-2026 à 13:02:28
n°52093
the_fennec
f3nn3cUs z3rd4
Posté le 03-10-2026 à 18:28:36  profilanswer
 

Oui, le MTP marche sur de la génération qui est facile a prédire, genre du code. Si c'est de la génération de texte, le MTP marche moins bien, voire pas du tout. Ça peut même devenir plus lent que sans si tu as un acceptance rate très bas et un draft-n-max élevé.


---------------
Faudra que je teste un jour :o
n°52143
ionik
Posté le 04-10-2026 à 10:20:42  profilanswer
 

Dites je repasse par la, des gens ont tester colibri sur de gros modèle ? Et avec du Ryzen 395+ par exemple sur de gros modèle et un gros contexte.


Ce retour d'expérience m'intéresserait car si ça pouvait être viable pour du code ça serait très intéressant pour moi.


Merci.


Ps : c'est quoi l'offre la plus intéressante actuellement en prix pour avoir 128Go ou plus de ram (ou pas loin) comme le Ryzen 395+, et si possible un lien vers une bonne offre.


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°52157
neo world
Posté le 04-10-2026 à 13:40:04  profilanswer
 

ionik a écrit :

Dites je repasse par la, des gens ont tester colibri sur de gros modèle ? Et avec du Ryzen 395+ par exemple sur de gros modèle et un gros contexte.
 
Ce retour d'expérience m'intéresserait car si ça pouvait être viable pour du code ça serait très intéressant pour moi.
 
Merci.
 
Ps : c'est quoi l'offre la plus intéressante actuellement en prix pour avoir 128Go ou plus de ram (ou pas loin) comme le Ryzen 395+, et si possible un lien vers une bonne offre.


j'ai fait du colibri avec kimi k3 avec mon strix halo : environ 1,8 token / seconde en pre processing et en token generation. C'est pas loin de l'inutilisable malgré deux SSD NVME (6GO/s de bande passante)
 
Mais c'est rigolo à tester. Qwen3.8 flash Next se sent parfaitement chez lui en Q4 avec Gufo ou Halogen :
 
https://i.redd.it/9lw4fgl6a6sh1.png
 
Si tu te sens aventureux tu as moyen de faire tourner Mimo ou GLM 5.3 :
https://www.reddit.com/r/LocalLLaMA [...] b_mini_pc/
 
Le moins cher en strix halo c'est bosgamepc :
https://www.bosgamepc.com/products/ [...] ai-max-395
attention il prend en moyenne 70 balles par mois (je l'ai eu à 2200€ en avril)


Message édité par neo world le 04-10-2026 à 13:40:18
n°52164
ionik
Posté le 04-10-2026 à 15:14:13  profilanswer
 

Ok merci de l'information, de toute façon la solution en MAX 395 est la plus rentable actuellement non ?


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°52165
Bitman
STAY APART
Posté le 04-10-2026 à 15:14:42  profilanswer
 

ptain le mac ok 32go ca prends des gros modeles, mais qu'est ce que c'est lent :/

n°52170
moyen_moin​s
chat réincarné
Posté le 04-10-2026 à 19:13:17  profilanswer
 

J'ai reçu ma r9700 pro ai [:totoz]
J'ai pas le temps de tester ça aujourd'hui...  :(

n°52176
the_fennec
f3nn3cUs z3rd4
Posté le 04-10-2026 à 20:58:18  profilanswer
 

Bon je suis pas le dernier a chier sur le vibeslop, mais la Strata euuuu
1100 en prefil, des pointes a 50/s en TG sur ma 4060Ti et il prends que 24GB de RAM avec le Qwen Next Coder!
 
https://i.imgur.com/BRI6Yto.png
 
J'ai mis claude-code a bosser.
 
Le setup c'est un peu le bordel, mais ça se fait bien quand même.


---------------
Faudra que je teste un jour :o
n°52178
gremi
Vieux con des neiges d'antan
Posté le 04-10-2026 à 21:01:38  profilanswer
 

moyen_moins a écrit :


J'ai vu que c'était compatible avec AMD et pas que NVIDIA.
Faut que je teste avec Qwen flash.


ça ne marche QUE avec celui là :D


---------------
In aligot we trust.
n°52184
Bitman
STAY APART
Posté le 04-10-2026 à 22:11:14  profilanswer
 

dites je galere la sur mon mac, des que j'envoie des requetes un peu compliquées, il tourne en boucle jusqu'a remplir le contexte et se noie
par ex j'ai balancé 5 bilans bio, il me fait bien l'analyse (qwen ou medgemma) mais ca recommence jusqu'a saturer, la je suis avec omlx, si vous avez une idée ?

n°52185
the_fennec
f3nn3cUs z3rd4
Posté le 04-10-2026 à 22:20:35  profilanswer
 

Ça peut être un modèle pourris, un contexte trop compressé/pollué, des paramètres.
C'est quoi ton hard, ton modèle, les paramètres, ton agent?


---------------
Faudra que je teste un jour :o
n°52186
Bitman
STAY APART
Posté le 04-10-2026 à 22:23:56  profilanswer
 

mac mini M6 / 32go
serveur OMLX qui a qwen 3.8:27b 4b :o ou gpt oss 20b mxfp4 QS8 :D
contexte 32k


Message édité par Bitman le 04-10-2026 à 22:43:22
n°52189
the_fennec
f3nn3cUs z3rd4
Posté le 04-10-2026 à 22:41:58  profilanswer
 

Qwen 3.8:28b 4b, ça existe pas ou c'est un modèle bidouillé. GPT OSS c'est un vieux tromblon.
 
Je connais pas trop les MLX, mais essaye ça pour voir:
https://huggingface.co/lmstudio-com [...] B-MLX-4bit


---------------
Faudra que je teste un jour :o
n°52191
pop_pop
System.NoBeerException
Posté le 04-10-2026 à 22:43:53  profilanswer
 

the_fennec a écrit :

Bon je suis pas le dernier a chier sur le vibeslop, mais la Strata euuuu
1100 en prefil, des pointes a 50/s en TG sur ma 4060Ti et il prends que 24GB de RAM avec le Qwen Next Coder!
 
https://i.imgur.com/BRI6Yto.png
 
J'ai mis claude-code a bosser.
 
Le setup c'est un peu le bordel, mais ça se fait bien quand même.


j'ai voulu essayé strata, mais pas moyen de faire accepter à vs2026 de s'y connecter. J'arrive à ajoute l'endpoint, mais il refuse d'ajouter le model.  :sarcastic:

Message cité 1 fois
Message édité par pop_pop le 04-10-2026 à 22:44:05
n°52192
Bitman
STAY APART
Posté le 04-10-2026 à 22:43:59  profilanswer
 

c est celui la :D Qwen3.8-27B-4bit

n°52193
the_fennec
f3nn3cUs z3rd4
Posté le 04-10-2026 à 22:51:07  profilanswer
 

pop_pop a écrit :


j'ai voulu essayé strata, mais pas moyen de faire accepter à vs2026 de s'y connecter. J'arrive à ajoute l'endpoint, mais il refuse d'ajouter le model.  :sarcastic:


Strata sait pas charger un modèle via l'API, essaye de voir quel nom de modèle il expose et mets le même dans VS. Ou essaye le param alias en le lançant. En tout cas claude marche sans soucis, et mon modèle s'appelle "default".
 

Bitman a écrit :

c est celui la :D Qwen3.8-27B-4bit


T'as quoi comme paramètres? genre température etc.
C'est quoi ton agent?


---------------
Faudra que je teste un jour :o
n°52203
moyen_moin​s
chat réincarné
Posté le 04-10-2026 à 23:32:03  profilanswer
 

gremi a écrit :


ça ne marche QUE avec celui là :D


Ça tombe bien, je veux le tester  :D

n°52205
totosssfr
Pousse-testa
Posté le 04-10-2026 à 23:39:53  profilanswer
 

Bonsoir tout le monde.
Je suis de retour avec ma doublette d'intel arc b60 pro.
Je me suis focalisé sur la fiabilité plutôt que la vitesse et je pense que tout est ok.


Modèle : qwen 3.8 27b fp8 "officiel"
Moteur : vllm-openai-xpu 0.30
Réglages spécifiques:
Tensor-parallelism (tp) = 2 avec xpu-graph fonctionel (équivalent de cuda graph)
Mtp : 2 token en plus
Actuellement : 65k token de contexte fp8 autorisant 3 requêtes concurrentes.
Le budget total est de 205k token avec une utilisation mémoire gpu calée sur 0.92.


Perfs:
Prefill : 900 t/s d'après llama-benchy
Génération : 14 tg/s toujours d'après llama-benchy


A l'utilisation, l'activation du mtp améliore beaucoup la rapidité ressentie à l'utilisation.
On est globalement au dessus des 14 tg/s relevés par llama-benchy (de l'ordre de 20 tg/s et des pointes au dessus de 35 tg/s)


Ces faibles perfs sont, je pense dues à la liaison pcie gen 3 x8 entre les deux gpu qui ne permet pas de les exploiter au max.


2 points qui m'ont fait galèrer :
Faire fonctionner le tensor parallelism avec xpu graph, c'est un peu la loterie (avec un qwen 3.8 int 4 et vllm 0.29, je dépassais les 35 tg/s). Passage en 0.30, KO. Repassage en 0.29 KO toujours.
Vllm indique qu'xpu est experimental avec tp>=2 mais des utilisateurs signalent qu'en fp8 c'est fonctionnel. C'est ce que j'ai constaté moi aussi.
L'autre point beaucoup plus relou : trouver l'extension vs code adéquat.
Roocode: n'a jamais réussi un appel. A part lister les modèles disponibles, rien ne fonctionnait.
Continue.dev : tout fonctionne sauf qu'il coupe net au bout d'un moment (env. 5 min) alors que le serveur vllm est ok. Il a quand même réussi à réaliser le tetris dans le navigateur parfaitement fonctionnel mais je devais le relancer à la main à chaque fois qu'il s'arrêtait.
Cline: configuration simple (bibliothèque de mcp! ) Je lui ai commandé un mcp pour interroger ebay. Il a turbiner pendant 2h15 pour réaliser un conteneur docker mcp ebay.
Il faut que je valide la livraison mais à première vue, il enterre les deux autres.
Sur les 2h15, le serveur a consommé env. 360w avec des pointes à 404w.


Ça reste raisonnable pour moi mais on doit pouvoor améliorer ça.
La faible conso des b60 était (avec leur prix) un critère important.


Prochaine étape : utiliser vs code server sur une vm ubuntu et voir ce qu'on peut en tirer.


@+


---------------
Pousse tarasse forever.
n°52242
Pipould's
Posté le 05-10-2026 à 11:42:16  profilanswer
 

totosssfr a écrit :

Bonsoir tout le monde.
Je suis de retour avec ma doublette d'intel arc b60 pro.
Je me suis focalisé sur la fiabilité plutôt que la vitesse et je pense que tout est ok.
 
Modèle : qwen 3.8 27b fp8 "officiel"
Moteur : vllm-openai-xpu 0.30
Réglages spécifiques:
Tensor-parallelism (tp) = 2 avec xpu-graph fonctionel (équivalent de cuda graph)
Mtp : 2 token en plus
Actuellement : 65k token de contexte fp8 autorisant 3 requêtes concurrentes.
Le budget total est de 205k token avec une utilisation mémoire gpu calée sur 0.92.
 
Perfs:  
Prefill : 900 t/s d'après llama-benchy
Génération : 14 tg/s toujours d'après llama-benchy
 
 
A l'utilisation, l'activation du mtp améliore beaucoup la rapidité ressentie à l'utilisation.
On est globalement au dessus des 14 tg/s relevés par llama-benchy (de l'ordre de 20 tg/s et des pointes au dessus de 35 tg/s)
 
Ces faibles perfs sont, je pense dues à la liaison pcie gen 3 x8 entre les deux gpu qui ne permet pas de les exploiter au max.
 
2 points qui m'ont fait galèrer :
Faire fonctionner le tensor parallelism avec xpu graph, c'est un peu la loterie (avec un qwen 3.8 int 4 et vllm 0.29, je dépassais les 35 tg/s). Passage en 0.30, KO. Repassage en 0.29 KO toujours.
Vllm indique qu'xpu est experimental avec tp>=2 mais des utilisateurs signalent qu'en fp8 c'est fonctionnel. C'est ce que j'ai constaté moi aussi.
L'autre point beaucoup plus relou : trouver l'extension vs code adéquat.
Roocode: n'a jamais réussi un appel. A part lister les modèles disponibles, rien ne fonctionnait.
Continue.dev : tout fonctionne sauf qu'il coupe net au bout d'un moment (env. 5 min) alors que le serveur vllm est ok. Il a quand même réussi à réaliser le tetris dans le navigateur parfaitement fonctionnel mais je devais le relancer à la main à chaque fois qu'il s'arrêtait.
Cline: configuration simple (bibliothèque de mcp! ) Je lui ai commandé un mcp pour interroger ebay. Il a turbiner pendant 2h15 pour réaliser un conteneur docker mcp ebay.
Il faut que je valide la livraison mais à première vue, il enterre les deux autres.
Sur les 2h15, le serveur a consommé env. 360w avec des pointes à 404w.
 
Ça reste raisonnable pour moi mais on doit pouvoor améliorer ça.
La faible conso des b60 était (avec leur prix) un critère important.
 
Prochaine étape : utiliser vs code server sur une vm ubuntu et voir ce qu'on peut en tirer.
 
 
@+


Regardes:
https://www.launch80.com/a/52e84b17 [...] 05c3a75d66
 
https://github.com/Wrapzii/k8v4-xpu

n°52250
moyen_moin​s
chat réincarné
Posté le 05-10-2026 à 13:31:20  profilanswer
 

me semblait avoir épluché les perfs du b60 et c'était pas ouf et très chiant à avoir surtout.
j'avais trouvé du B65 à 1200€ et je me posais la question.

n°52252
speedboyz3​0
Guide Michelin :o
Posté le 05-10-2026 à 13:39:12  profilanswer
 

moyen_moins a écrit :

me semblait avoir épluché les perfs du b60 et c'était pas ouf et très chiant à avoir surtout.
j'avais trouvé du B65 à 1200€ et je me posais la question.


Chiant niveau soft non ? Ça a bien progressé je crois.
B60/65/70 intéressant oui :jap:

n°52253
moyen_moin​s
chat réincarné
Posté le 05-10-2026 à 13:43:37  profilanswer
 

bah sur amazon, il y avait du B65 pas excessif alors il y a 3-4j :)

n°52254
totosssfr
Pousse-testa
Posté le 05-10-2026 à 13:44:30  profilanswer


Merci !
Je vais potasser tout ça.


---------------
Pousse tarasse forever.
n°52255
totosssfr
Pousse-testa
Posté le 05-10-2026 à 13:52:41  profilanswer
 

moyen_moins a écrit :

me semblait avoir épluché les perfs du b60 et c'était pas ouf et très chiant à avoir surtout.
j'avais trouvé du B65 à 1200€ et je me posais la question.


Ma première b60 vient de matériel.net (680€ je crois grâce à une promo).
La seconde vient de galaxus.fr à 719€.
Il me semble qu'elles ont pris 100€ depuis.


Pour le support, je confirme que ça fonctionne mieux maintenant qu'au début.


Je suis parti sur vllm car intel dérive leur conteneur perso depuis vllm.
Vllm marche bien aussi en accès concurrents donc tu peux laisser max-num-request sur 2: ton agent codage consomme une requête et tu peux quand même continuer à l'interroger via un autre outil sans désagrément.


Je guette le support xpu pour qwen 3.8 flash next même si le qwen 3.8 27b me convient bien actuellement.


---------------
Pousse tarasse forever.
n°52277
the_fennec
f3nn3cUs z3rd4
Posté le 05-10-2026 à 20:32:26  profilanswer
 

How Is This Frontier Class 177B Model So Fast for Local Agents?
https://www.youtube.com/watch?v=6WLBmP-tZ0Q
Codacus
 
Il teste Strata et explique comment il marche.
 

Spoiler :

avec des vrais bouts de llama.cpp dedans :o


---------------
Faudra que je teste un jour :o
n°52279
lapin
Posté le 05-10-2026 à 20:57:13  profilanswer
 
n°52281
neo world
Posté le 05-10-2026 à 21:12:40  profilanswer
 

the_fennec a écrit :

How Is This Frontier Class 177B Model So Fast for Local Agents?
https://www.youtube.com/watch?v=6WLBmP-tZ0Q
Codacus
 
Il teste Strata et explique comment il marche.
 

Spoiler :

avec des vrais bouts de llama.cpp dedans :o


Oh punaise il s’est filmé !  :pt1cable:  
 
C’est mieux que Qwen 3.8 flash next ou je peux arreter la l’interêt pour le modèle ? :D

n°52282
chris282
id steam/psn : chris282_fr
Posté le 05-10-2026 à 21:17:15  profilanswer
 

the_fennec a écrit :

How Is This Frontier Class 177B Model So Fast for Local Agents?
https://www.youtube.com/watch?v=6WLBmP-tZ0Q
Codacus
 
Il teste Strata et explique comment il marche.
 

Spoiler :

avec des vrais bouts de llama.cpp dedans :o


c'est pas un peu pourri strat ?  
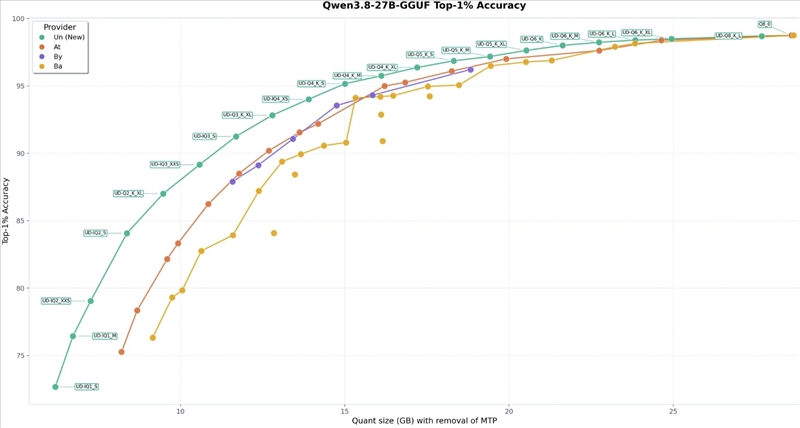
car je regarde le repo Github et ca tourne en IQ2_XS ou en IQ3_XXS typiquement  
tout ce qui est en dessous de Q4 en quantization pour moi c'est non : 90% de précision c'est le minimum
 
https://rehost.diberie.com/Picture/Get/r/559584

n°52285
the_fennec
f3nn3cUs z3rd4
Posté le 05-10-2026 à 21:26:26  profilanswer
 

chris282 a écrit :


c'est pas un peu pourri strat ?  
car je regarde le repo Github et ca tourne en IQ2_XS ou en IQ3_XXS typiquement  
tout ce qui est en dessous de Q4 en quantization pour moi c'est non : 90% de précision c'est le minimum
 
https://rehost.diberie.com/Picture/Get/r/559584


Oui mais ça va viiiite :o
 
J'ai pas trop gratté, mais j'avais de très bons (mais lents) résultats avec IQ3_XXS et llama.cpp. La j'ai joué avec coder et c'est pas mal.
J'essaye de charger le Q2, mais ça plante.
 
Je voudrais le remettre a bosser a la suite de Qwen 3.8 pour comment il s'en sort.
 
Est-ce qu'il vaut mieux 80% de 177B ou 100% de 27B, j'ai pas la réponse :D


---------------
Faudra que je teste un jour :o
n°52294
the_fennec
f3nn3cUs z3rd4
Posté le 05-10-2026 à 22:37:08  profilanswer
 

C'est bon j'ai réussi a charger le q2_0!
 
J'ai eu besoin d'ajouter:

Code :
  1. --vram-reserve-mib 500 --context 110000 --kv int8 --draft-vocab en


Niveau perf c'est un peu n'importe quoi, dans le bon sense :pt1cable: et je suis toujours en dessous de 30GB de RAM!
Prefill a plus de 1k et gen qui fait des pointes a 90/s.
https://i.imgur.com/QQZTrnY.png
 
J'ai monté ma VM a 35GB de RAM, peut être que je pourrais charger IQ2_XS ...
Pour un projet qui a deux semaines c'est quand même fort.
 
Bon je vais le laisser bosser la nuit sur le Linux pour Amiga et voir si il tient encore le coup.


---------------
Faudra que je teste un jour :o
n°52296
moyen_moin​s
chat réincarné
Posté le 05-10-2026 à 22:52:48  profilanswer
 

C'est la version coder ou bien la classique ?

n°52297
the_fennec
f3nn3cUs z3rd4
Posté le 05-10-2026 à 23:17:44  profilanswer
 

Classique avec coder ça tiens en 24GB de RAM


---------------
Faudra que je teste un jour :o
n°52312
ionik
Posté le 06-10-2026 à 07:31:37  profilanswer
 

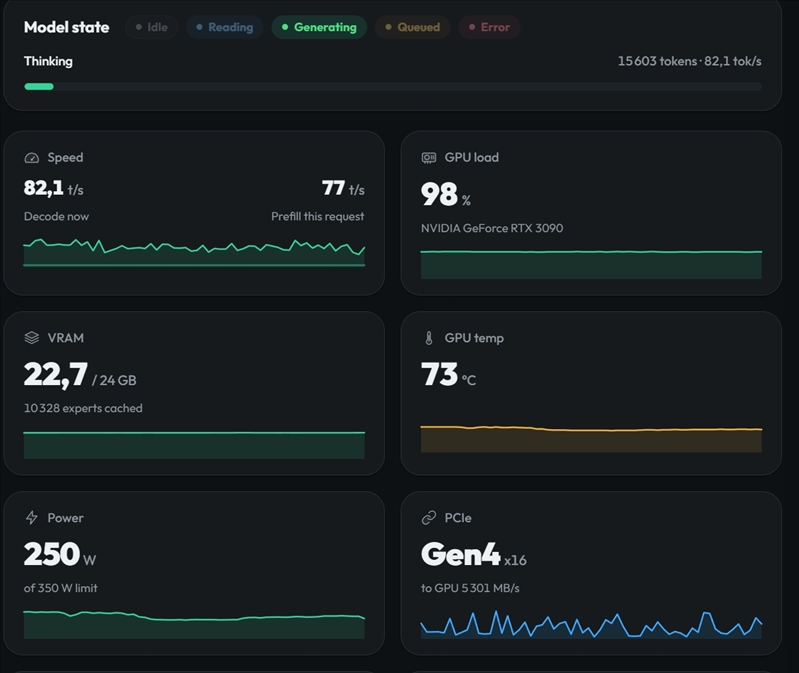
J'ai tester strata en IQ2S avec contexte de 356k avec cache 16Go et 8 requête max, avec une 3090 24 Go et 60 Go de ram utilisé (environ).
 
ça marche pas mal mais il faudrait du q4 minimum mais je ne pense pas que j'y arrive avec le système utilisé a côté (même si j'ai 128 Go de ram)
 
https://rehost.diberie.com/Picture/Get/r/559631

Message cité 1 fois
Message édité par ionik le 06-10-2026 à 07:32:30

---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°52314
chris282
id steam/psn : chris282_fr
Posté le 06-10-2026 à 08:12:52  profilanswer
 

the_fennec a écrit :

C'est bon j'ai réussi a charger le q2_0!


J'ai eu besoin d'ajouter:

Code :
  1. --vram-reserve-mib 500 --context 110000 --kv int8 --draft-vocab en
 

Niveau perf c'est un peu n'importe quoi, dans le bon sense :pt1cable: et je suis toujours en dessous de 30GB de RAM!
Prefill a plus de 1k et gen qui fait des pointes a 90/s.
https://i.imgur.com/QQZTrnY.png


J'ai monté ma VM a 35GB de RAM, peut être que je pourrais charger IQ2_XS ...
Pour un projet qui a deux semaines c'est quand même fort.


Bon je vais le laisser bosser la nuit sur le Linux pour Amiga et voir si il tient encore le coup.


90 token/sec de decode en soit c'est très bon


sympa cette image de recap de performance, tu l'as avec quel outil ?

Message cité 1 fois
Message édité par chris282 le 06-10-2026 à 08:13:40
n°52325
the_fennec
f3nn3cUs z3rd4
Posté le 06-10-2026 à 11:10:44  profilanswer
 

chris282 a écrit :


90 token/sec de decode en soit c'est très bon
 
sympa cette image de recap de performance, tu l'as avec quel outil ?


Surtout avec une simple RTX 4060ti !
C'est intégré a Strata, tu vas juste sur le host/port et t'as un tab pour le chat, un autre pour ces stats et un dernier pour des info/options.
 
Il q2 a bien tenu toute la nuit, mais Claude a été trop gourmand en contexte pour la compaction alors ça a stoppé. Il fait des fois un prompt trop gros pour que la compaction reste dans les 110k.


---------------
Faudra que je teste un jour :o
n°52329
tfpsly
Sly
Posté le 06-10-2026 à 12:31:39  profilanswer
 

Et comment est la qualité de ton Qwen 3.8Next en Q2 vs Qwen 3.8 ? Utilisable, similaire, meilleure?

n°52332
moyen_moin​s
chat réincarné
Posté le 06-10-2026 à 13:51:07  profilanswer
 

ionik a écrit :

J'ai tester strata en IQ2S avec contexte de 356k avec cache 16Go et 8 requête max, avec une 3090 24 Go et 60 Go de ram utilisé (environ).
 
ça marche pas mal mais il faudrait du q4 minimum mais je ne pense pas que j'y arrive avec le système utilisé a côté (même si j'ai 128 Go de ram)
 
https://rehost.diberie.com/Picture/Get/r/559631


même du iq4_xs ?

n°52334
ionik
Posté le 06-10-2026 à 14:17:51  profilanswer
 

moyen_moins a écrit :


même du iq4_xs ?


J'ai pas tester encore en q4, il faudrait que je teste ça mais pendant mes tests ça semblais pas trop mal quand même.
 
J'ai comparé des audits sur des commits entre codex et Qwen et il relevé pas mal de chose similaire, mais je pense qu'un q4 (même si c'est un peu plus long serait mieux je pense)
 
Mais niveau conso ça envoie pas mal :o


---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°52342
neo world
Posté le 06-10-2026 à 15:29:24  profilanswer
 

https://www.usine-digitale.fr/intel [...] KBGX4.html
un MoU de 1000 milliards de paramètres made in France
 

Citation :

L’équipe de la start-up va d’ailleurs plus loin, en affirmant que Mistral Large 4 figurera, une fois ses poids publiés, parmi les meilleurs modèles ouverts au monde, et qu’il sera, de loin, le plus performant modèle ouvert développé en Europe comme aux États-Unis. « C’est un modèle qui va significativement réduire le gap entre nos modèles et les meilleurs modèles qui existent aujourd’hui. Nous allons sortir un modèle qui est essentiellement au même niveau que les meilleurs modèles chinois d’il y a un mois ou deux »


https://external-content.duckduckgo.com/iu/?u=https%3A%2F%2Fi.pinimg.com%2Foriginals%2F5b%2Fb9%2Fe5%2F5bb9e5cc2e77534b6e50793348c0a7a9.jpg&f=1&nofb=1&ipt=15428455cb82cacdabd3ed4754c15e07ff5aaff59edb3b702bf7a141ae4e194f&ipo=images

Message cité 1 fois
Message édité par neo world le 06-10-2026 à 15:31:00
n°52347
chris282
id steam/psn : chris282_fr
Posté le 06-10-2026 à 16:07:45  profilanswer
 

the_fennec a écrit :


Surtout avec une simple RTX 4060ti !
C'est intégré a Strata, tu vas juste sur le host/port et t'as un tab pour le chat, un autre pour ces stats et un dernier pour des info/options.
 
Il q2 a bien tenu toute la nuit, mais Claude a été trop gourmand en contexte pour la compaction alors ça a stoppé. Il fait des fois un prompt trop gros pour que la compaction reste dans les 110k.


propre, encouragements
 

 Page :   1  2  3  4  5  ..  75  76  77  78  79  80

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)