Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
6789 connectés 


Ma famille de modèles préferée du quotidien ...
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  78  79  80  81  82  83
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°52884
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 11:40:55  profilanswer
 

Reprise du message précédent :

alanou a écrit :


Arrête j'en ai vu à 80€ sur leboncoin  :o


en neuf ou même ebay, rien de dispo à moins :heink:
edit: lbc et les annonces qui ont 3ans mais pas fermées, t'es sûr de ton coup ?
sur lbc, je vois plus souvent des config complètes qu'autre chose mais j'essaierai de mieux regarder :jap:

Message cité 1 fois
Message édité par moyen_moins le 09-10-2026 à 11:48:28
n°52887
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 11:42:10  profilanswer
 

b-tzu a écrit :


C’est quoi bifurcation ? La mortar elle a une bifurcation ? Que je la revende bien  :lol:


c'est splitter le port 16X pcie 4.0 du CPU en 2 ports pcie 4.0 8X :)


Message édité par moyen_moins le 09-10-2026 à 11:48:46
n°52890
alanou
Remembering M.P.
Posté le 09-10-2026 à 11:56:51  profilanswer
 

moyen_moins a écrit :


en neuf ou même ebay, rien de dispo à moins :heink:  
edit: lbc et les annonces qui ont 3ans mais pas fermées, t'es sûr de ton coup ?
sur lbc, je vois plus souvent des config complètes qu'autre chose mais j'essaierai de mieux regarder :jap:


Ben genre celle ci était une annonce d'hier, mais forcément déjà partie : https://www.leboncoin.fr/ad/accesso [...] 3284459023
 
https://www.leboncoin.fr/ad/accesso [...] 3277414617
https://www.leboncoin.fr/ad/ordinateurs/3274265270
https://www.leboncoin.fr/ad/accesso [...] 3259854277
 
Mets une alerte, parceque les modèles moins daubesques qu'une MSI ont l'air de partir hyper vite évidemment


---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°52908
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 13:32:21  profilanswer
 

C'est sûr que si je pars sur du MSI :whistle:
perso, c'est Gigabyte ou Asus, le reste, moyen confiance.

n°52919
the_fennec
f3nn3cUs z3rd4
Posté le 09-10-2026 à 14:32:55  profilanswer
 

moyen_moins a écrit :

Je voulais trouver une cm am4 en x570, c'est devenu introuvable ou a 500€+  :pt1cable:  
Même les b550 avec bifurcation sont au même prix. La folie...


J'ai choppé une ASUS TUF GAMING B550-PLUS WI-FI II pour 93 euros pendant les prime days:
https://www.amazon.fr/dp/B09LVQYGXH
 
Bon par contre le second port c'est PCIE 3.0 seulement.
 
Elle de retour a 130 euros maintenant.

Message cité 1 fois
Message édité par the_fennec le 09-10-2026 à 14:36:13

---------------
Faudra que je teste un jour :o
n°52920
the_fennec
f3nn3cUs z3rd4
Posté le 09-10-2026 à 14:37:30  profilanswer
 

moyen_moins a écrit :

C'est sûr que si je pars sur du MSI :whistle:
perso, c'est Gigabyte ou Asus, le reste, moyen confiance.


Mon server actuel est en MSI b450 et tourne h24 depuis un moment sans soucis.


---------------
Faudra que je teste un jour :o
n°52928
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 15:13:38  profilanswer
 

the_fennec a écrit :


J'ai choppé une ASUS TUF GAMING B550-PLUS WI-FI II pour 93 euros pendant les prime days:
https://www.amazon.fr/dp/B09LVQYGXH


Bon par contre le second port c'est PCIE 3.0 seulement.


Elle de retour a 130 euros maintenant.


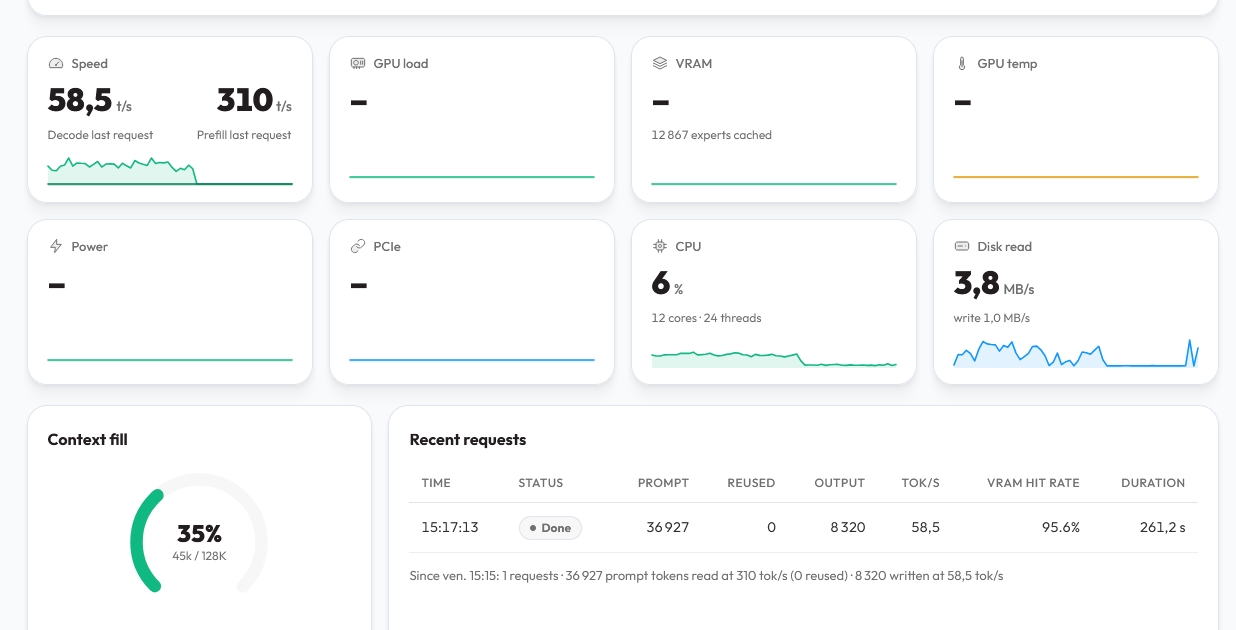
sur la mienne, le port pcie 16x le plus proche du port géré par le cpu est en pcie 3.0 2x je viens de vérifier, la 9700pro est bien passée en 2x.


je vais voir si ça change quelque chose sur strata, à mon avis non, je dois être trop bridé par la RAM en DDR4.


edit:
https://rehost.diberie.com/Picture/Get/f/560514
edit²: qwen 3.8 flash iq3_s

Message cité 4 fois
Message édité par moyen_moins le 09-10-2026 à 15:40:31
n°52934
chris282
id steam/psn : chris282_fr
Posté le 09-10-2026 à 16:02:31  profilanswer
 

moyen_moins a écrit :


sur la mienne, le port pcie 16x le plus proche du port géré par le cpu est en pcie 3.0 2x je viens de vérifier, la 9700pro est bien passée en 2x.
 
je vais voir si ça change quelque chose sur strata, à mon avis non, je dois être trop bridé par la RAM en DDR4.
 
edit:
https://rehost.diberie.com/Picture/Get/f/560514
edit²: qwen 3.8 flash iq3_s


en pcie 3.0 2x tu va être fortement bridé (et la vitesse de la ddr4 ne sera pas ton goulot d'étranglement)

n°52935
chris282
id steam/psn : chris282_fr
Posté le 09-10-2026 à 16:03:57  profilanswer
 

si vous cherchez des cartes meres pour une workstation IA, venez faire un tour ici, j'ai commencé un référencement assez correct :
 "Sujet : Choisir sa carte mère Workstation (ATX, E-ATX & SSI) tous sockets"
https://forum.hardware.fr/forum2.ph [...] w=0&nojs=0


moi je me suis commandé la ASUS PROART B850-CREATOR WiFi Neo a 235 euros, elle est passée a 317 euros chez amazon. elle a l'avantage de l'évolutivité avec 2 slots PCIE X16 GEN5


Message édité par chris282 le 09-10-2026 à 16:14:44
n°52936
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 16:15:02  profilanswer
 

chris282 a écrit :


en pcie 3.0 2x tu va être fortement bridé (et la vitesse de la ddr4 ne sera pas ton goulot d'étranglement)


ouais ben globalement j'ai pris 10t/s en passant d'un 1x en 2x.
pour l'instant c'est tout à fait utilisable en l'état :)


edit: j'ai que de la DDR4 donc les cm AM4 avec un bon chipset, ça commence à devenir rare si on cherche pas une MSI :o


Message édité par moyen_moins le 09-10-2026 à 16:15:56
n°52965
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 18:37:02  profilanswer
 

bon, j'ai eu droit à mon 1er  


Error: prompt (98524 tokens) + max tokens (32583) exceeds the context (131072); requests are never truncated. Send a smaller max_tokens (at most 32540 here), or add "fit_max_tokens": true to the model's strata-<model>.json to shorten it to the room left (#545)


je tente 192K de contexte [:paysan]

Message cité 1 fois
Message édité par moyen_moins le 09-10-2026 à 18:37:26
n°52978
the_fennec
f3nn3cUs z3rd4
Posté le 09-10-2026 à 20:55:54  profilanswer
 

moyen_moins a écrit :


sur la mienne, le port pcie 16x le plus proche du port géré par le cpu est en pcie 3.0 2x je viens de vérifier, la 9700pro est bien passée en 2x.
 
je vais voir si ça change quelque chose sur strata, à mon avis non, je dois être trop bridé par la RAM en DDR4.
 
edit:
https://rehost.diberie.com/Picture/Get/f/560514
edit²: qwen 3.8 flash iq3_s


T'es comment niveau occupation de RAM? Etrange ton disk read a 3M/s, peut être t'es en mmap et tu viens de charger le modèle.
 

moyen_moins a écrit :

bon, j'ai eu droit à mon 1er  


Error: prompt (98524 tokens) + max tokens (32583) exceeds the context (131072); requests are never truncated. Send a smaller max_tokens (at most 32540 here), or add "fit_max_tokens": true to the model's strata-<model>.json to shorten it to the room left (#545)


je tente 192K de contexte [:paysan]


Ouais j'ai eu ça aussi. Tu peux changer le contexte dans le fichier json de config strata-iq3_s.json pour pas monter trop haut, mets ton contexte coté agent +32k qui est le max output pas défaut.


---------------
Faudra que je teste un jour :o
n°52979
moyen_moin​s
chat réincarné
Posté le 09-10-2026 à 20:58:48  profilanswer
 

74/96GB de pris actuellement.
j'suis en config par défaut de strata, je viens de màj (j'avais quelques versions de retard).
192K de contexte, j'ai tout qui charge, 256K, crash au prompt processing.


j'ai envie de tester la iq4_xs d'unsloth mais avec la chance que j'ai, c'est le contexte qui va pêcher :/


Message édité par moyen_moins le 09-10-2026 à 20:59:27
n°52980
the_fennec
f3nn3cUs z3rd4
Posté le 09-10-2026 à 21:23:44  profilanswer
 

Teste, c'est vite fait!


---------------
Faudra que je teste un jour :o
n°52998
moyen_moin​s
chat réincarné
Posté le 10-10-2026 à 00:23:19  profilanswer
 

A priori, max contexte bug sur la r9700pro sous windows (OS de merde). :fou:
224k ok pr contre.
Pour le moment, environ 320 t/s pp et 52 t/s tg.
Quelques bizarreries en français mais globalement ça marche plutôt pas mal en xhigh, plus utilisable que qwen 3 8 27B. :jap:


J'espère avoir le temps de tester l'iq4_xs ce weekend :)

n°53011
the_fennec
f3nn3cUs z3rd4
Posté le 10-10-2026 à 10:41:26  profilanswer
 

Je pense que Strata a un soucis avec la taille du contexte, avec llama.cpp je mets 110k coté claude et llama et ça marche. Avec Strata j'arrive au même soucis que tu as posté. Finalement j'ai mis 200k coté Strata et 150K coté claude et ça marche, j'ai pas de baisse de vitesse! 1k/s en PP et 100/s en TG avec Q2 :love:.
 
Je viens de mettre Caomfox et je laisse claude se chercher un deuxième GPU :lol:
https://github.com/adambenhassen/crw-camofox
 
Je lui ait dit de chercher sur ebay, amazon et aliexpress et ça marche plutôt pas mal!

Message cité 1 fois
Message édité par the_fennec le 10-10-2026 à 10:42:05

---------------
Faudra que je teste un jour :o
n°53013
Pipould's
Posté le 10-10-2026 à 10:53:46  profilanswer
 

speedboyz30 a écrit :


Le mac c'est petit, ça consomme rien et quand je voudrai changer, je le rapporte chez Apple sans me prendre la tête.
 
Avec ta config tu pars déjà sur 6000W rien que pour les GPU, et t'as que 64Gb de ram.
Le tout sans les avantages d'un système NVIDIA / CUDA.  
 
Ca donne quoi en tarif complet un full build avec 2x9700 + 64Gb de ram ddr5 ?
 
OMLX fait des progrès de dingue depuis quelques mois.
Et avec 128Gb je peux mettre Qwen 3.8 Flash Next en Q4 avec pas mal de place pour le contexte et encore beaucoup de marge pour les apps et le système.  
Combiné avec un ssd qui tape dans les 12~13,000 Mb/s et 10GbE c'est vraiment hyper équilibré je trouve.
 
 [:zyzz:1]


Il faut voir ca de maniere differente...  
 
Un Mac / DGX / Strix, c'est plus la machine que tu vas laisser h24, faut pas que tu sois presse...  
 
Un fixe va plutot te permettre de bosser efficacement quand tu ne veux pas attendre...  
 
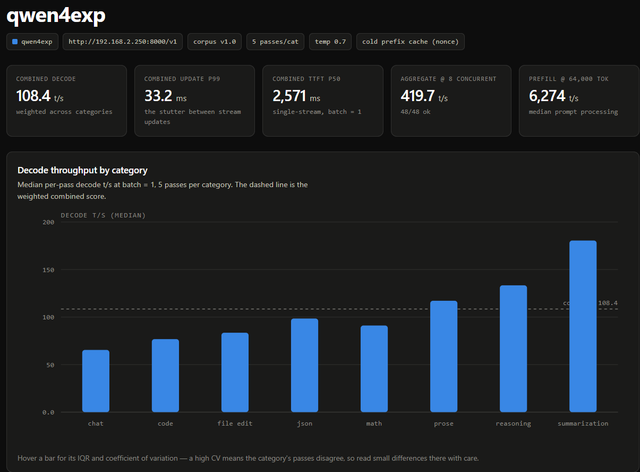
T'as demande un tarif complet: boitier 100, alim 100, cpu 150, mb 250, ram 600, gpu's 1800*2, nvme 150 = 5000 balles
 
Pour 5000 balles t'as ca:  
 
https://i.ibb.co/m51hJGvM/image.png
 
Apres, t'as aussi 80w en idle.
 
En inference c'est surement du meme ordre de joule / token qu'une petite box.  
 

n°53014
the_fennec
f3nn3cUs z3rd4
Posté le 10-10-2026 à 10:55:44  profilanswer
 

REA: Reverse Engineer Anything
https://github.com/morluto/rea
 

Citation :

See a feature in an app that you want in your own product? Ask your agent to investigate it with REA. It can inspect the app without its source code, explain how the feature works, show the evidence, and build a version for your project.
 
REA connects your agent to tools for inspecting native binaries, JavaScript and Electron apps, .NET assemblies, and websites. You can also use the same tools from your terminal. Analysis runs locally, and results include the evidence and limitations behind each conclusion.
 
Setup registers REA with your agent and installs matching workflow instructions. Native analysis can use an existing Hopper, Ghidra, or IDA installation; setup can optionally install Hopper with approval. Static JavaScript analysis needs no native analysis engine.


J'ai un peu peur que ça soit le merdier niveau install, mais ça me bote bien de tester... un jour :o


---------------
Faudra que je teste un jour :o
n°53017
Pipould's
Posté le 10-10-2026 à 11:09:43  profilanswer
 

moyen_moins a écrit :


sur la mienne, le port pcie 16x le plus proche du port géré par le cpu est en pcie 3.0 2x je viens de vérifier, la 9700pro est bien passée en 2x.
 
je vais voir si ça change quelque chose sur strata, à mon avis non, je dois être trop bridé par la RAM en DDR4.
 
edit:
https://rehost.diberie.com/Picture/Get/f/560514
edit²: qwen 3.8 flash iq3_s


Les 9700 ai pro sont tres sensibles a la vitesse du port pcie. en dessous de PCIE5 4x / 4.0 8x ou 3.0 16x

n°53018
Pipould's
Posté le 10-10-2026 à 11:12:16  profilanswer
 

moyen_moins a écrit :


sur la mienne, le port pcie 16x le plus proche du port géré par le cpu est en pcie 3.0 2x je viens de vérifier, la 9700pro est bien passée en 2x.
 
je vais voir si ça change quelque chose sur strata, à mon avis non, je dois être trop bridé par la RAM en DDR4.
 
edit:
https://rehost.diberie.com/Picture/Get/f/560514
edit²: qwen 3.8 flash iq3_s


Et passe sur radiance, si tout ton model et le kv tiens sur la carte, tu seras a 3k de prefill et 150tg de generation.

n°53019
moyen_moin​s
chat réincarné
Posté le 10-10-2026 à 11:21:10  profilanswer
 

Pipould's a écrit :


Les 9700 ai pro sont tres sensibles a la vitesse du port pcie. en dessous de PCIE5 4x / 4.0 8x ou 3.0 16x


Je le savais mais je pensais pas à ce point.
La plateforme est vieille et limitée :/

Pipould's a écrit :


Et passe sur radiance, si tout ton model et le kv tiens sur la carte, tu seras a 3k de prefill et 150tg de generation.


Ah ? Je vais regardais je connais pas.

n°53020
moyen_moin​s
chat réincarné
Posté le 10-10-2026 à 11:23:19  profilanswer
 

the_fennec a écrit :

REA: Reverse Engineer Anything
https://github.com/morluto/rea

 
Citation :

See a feature in an app that you want in your own product? Ask your agent to investigate it with REA. It can inspect the app without its source code, explain how the feature works, show the evidence, and build a version for your project.


REA connects your agent to tools for inspecting native binaries, JavaScript and Electron apps, .NET assemblies, and websites. You can also use the same tools from your terminal. Analysis runs locally, and results include the evidence and limitations behind each conclusion.


Setup registers REA with your agent and installs matching workflow instructions. Native analysis can use an existing Hopper, Ghidra, or IDA installation; setup can optionally install Hopper with approval. Static JavaScript analysis needs no native analysis engine.


J'ai un peu peur que ça soit le merdier niveau install, mais ça me bote bien de tester... un jour :o


J'avoue ça fait partie de ces trucs qui font peur aux gens : plus rien n'est à toi, même pas ton idée (qui peut prendre du temps à être copiée). En 1 prompt mal branlé mais avec le bon skills, c'est réglé en 5min.

Message cité 1 fois
Message édité par moyen_moins le 10-10-2026 à 11:24:18
n°53021
Pipould's
Posté le 10-10-2026 à 11:34:43  profilanswer
 

moyen_moins a écrit :


Je le savais mais je pensais pas à ce point.
La plateforme est vieille et limitée :/


moyen_moins a écrit :


Ah ? Je vais regardais je connais pas.


Sur du TP=1 c'est peut etre un peu limite...
 
Mais avec 32GB tu devrais pouvoir faire tourner du 27b avec un contexte raisonable.
 
https://codeberg.org/StillDeadcode/ [...] ranch/main
 

n°53022
moyen_moin​s
chat réincarné
Posté le 10-10-2026 à 11:35:31  profilanswer
 

the_fennec a écrit :

Je pense que Strata a un soucis avec la taille du contexte, avec llama.cpp je mets 110k coté claude et llama et ça marche. Avec Strata j'arrive au même soucis que tu as posté. Finalement j'ai mis 200k coté Strata et 150K coté claude et ça marche, j'ai pas de baisse de vitesse! 1k/s en PP et 100/s en TG avec Q2 :love:.
 
Je viens de mettre Caomfox et je laisse claude se chercher un deuxième GPU :lol:
https://github.com/adambenhassen/crw-camofox
 
Je lui ait dit de chercher sur ebay, amazon et aliexpress et ça marche plutôt pas mal!


t'arrives à avoir des trucs de qualité avec du Q2 ? :??:

n°53023
the_fennec
f3nn3cUs z3rd4
Posté le 10-10-2026 à 13:48:38  profilanswer
 

moyen_moins a écrit :


t'arrives à avoir des trucs de qualité avec du Q2 ? :??:


Clairement ça marche bien, la il a tourné pendant plusieurs heures en faisant des recherches avec Camofox, zéro tool calls de foiré et le rapport est très bon, tout est cohérent même si quand j'ai parlé de Qwen Next il a visé le vieux 80B. Je l'ai relancé avec 300/400 de budget et j'ai mentionné Strata et Qwen3.8-flash-next en lui demandant la perle rare à ajouter à un ma 4060Ti. Je vois qu'il a commencé par inspecter le repo de Strata.
 
 
Extrait du premier rapport (il fait 56Ko) ci-dessous, les liens sont bons dans les sections de recherche, mais la il n'y a que la version courte:

Code :
  1. ## §Verdict final — classement des 16 voies pour Qwen3-Next-80B-A3B, budget 300 €                                     
  2.                                                                                                                          
  3.   # │Voie                                         │VRAM            │Bande pas…│Coût vér…│Mod requis            │Decode es…
  4.   ──┼─────────────────────────────────────────────┼────────────────┼──────────┼─────────┼──────────────────────┼──────────
  5.   1 │2x Tesla P100 16 Go (eBay.fr  178209716178 ) │32 Go HBM2      │~716 GB/s…│235,78 €…│soufflerie, Above-4G,…│30–50 t/s
  6.   2 │2x Tesla K80 24 Go (eBay.fr  358699426751 )  │48 Go GDDR5 (4 …│~960 GB/s │243,66 € │patch  llamacpp-keple…│20–30 t/s
  7.   3 │2x AMD MI25 16 Go (eBay.fr  146711520286  / …│32 Go HBM2      │~2 TB/s   │222–246 €│soufflerie, Vulkan (g…│25–40 t/s
  8.   4 │4x Quadro P4000 8 Go (enchère eBay.fr  17853…│32 Go GDDR5     │~864 GB/s │~236 € (…│aucun (cartes actives)│20–30 t/s
  9.   5 │4x P104-101 flashé 4→8 Go                    │32 Go GDDR5     │~928 GB/s │240–280 €│flash BIOS (risque de…│20–30 t/s
  10.   6 │4x Quadro P2000 5 Go (eBay.fr  237088058738 )│20 Go GDDR5     │~768 GB/s │252 €, l…│aucun (77 W/carte, PS…│15–25 t/s
  11.   7 │3x RX 580 8 Go (AliExpress  1005012842097051…│24 Go GDDR5     │~768 GB/s │267 € (3…│Vulkan (gfx803 abando…│15–25 t/s
  12.   8 │1x K40 12 Go + 64 Go RAM ( 137465873065  + 2…│12 Go           │12 Go GPU…│223,67 € │patch Kepler          │15–20 t/s…
  13.   9 │1x M40 24 Go (eBay.fr  407273502269 , blower…│24 Go GDDR5     │240 GB/s  │289,10 € │aucun (blower fourni) │10–15 t/s
  14.   10│2x Radeon Pro V340L (eBay.fr  ?_nkw=radeon+p…│32 Go HBM2      │~2 TB/s   │311 €    │soufflerie, bug clock…│30–45 t/s
  15.   11│1x Radeon VII 16 Go (294,00 €, de Chine)     │16 Go HBM2      │1 TB/s    │294 €    │gfx906, ROCm/Vulkan   │15–25 t/s
  16.   12│1x RX 6600 8 Go (eBay.fr  398445907073 , du …│8 Go GDDR6      │256 GB/s  │271,25 € │RDNA2, ROCm 6.x       │8–12 t/s 
  17.   13│Q2_K sur le Ryzen 5650GE seul                │0 Go            │45–55 GB/…│0 €      │aucun                 │5–8 t/s 
  18.   14│Intel Arc B580                               │12 Go           │448 GB/s  │hors bud…│—                     │—       
  19.   15│CMP 170HX déverrouillée                      │64 Go HBM2e     │~1 GB/s (…│hors bud…│Falcon + soudure      │—       
  20.   16│CMP 50HX 10 Go                               │10 Go           │—         │412,69 € │—                     │—       
  21.                                                                                                                          
  22.   Recommandation : voie 1 (2x Tesla P100 16 Go, 235,78 €). C'est la seule qui combine : 32 Go de HBM2 (la bande passante 
  23.   la plus élevée par euro dépensé après Kepler), CUDA natif sans aucun patch ni firmware, Q4_K_M de Qwen3-Next qui tient 
  24.   entièrement (48,5 Go = 32 Go GPU + 16,5 Go d'experts dans les 32 Go de RAM du 5650GE), et un decode estimé 30–50 t/s. Le
  25.   vendeur cybergarage (100 %, 605 avis) a 57 annonces ≤ 250 € : la disponibilité est durable, contrairement au K80 («   
  26.   C'est le dernier »).                                                                                                   
  27.                                                                                                                          
  28.   Si l'on veut 48 Go et le meilleur €/Go : voie 2 (2x K80, 243,66 €, 4,58 €/Go), en acceptant le fork CUDA 11.4 ( -     
  29.   DGGML_CUDA_GRAPHS=OFF , GCC ≤ 10) ou Vulkan. Les mesures publiées du fork sur MoE (pp ~28 / tg ~25 sur GPT-OSS-20B, pp 
  30.   ~22                                                                                                                   
  31.   / tg ~20 sur Gemma4-26B-A4B, une seule carte = 2×GK210) sont cohérentes avec 20–30 t/s sur Qwen3-Next.                 
  32.                                                                                                                          
  33.   Si l'on refuse tout mod, toute soufflerie et toute alimentation : voie 6 (4x Quadro P2000 5 Go, 252 €) — 20 Go, CUDA   
  34.   natif, 308 W, aucun outillage. Q3_K_S (34,6 Go) avec  --n-cpu-moe 14 .                                                 
  35.                                                                                                                          
  36.   Commandes types (voie 1, 2 cartes P100) :                                                                             
  37.                                                                                                                          
  38.     # préfill rapide, decode réparti sur les 2 GPU (bande passante additionnée, ~0 trafic PCIe)                         
  39.     llama.cpp -m qwen3-next-80b-a3b-q4_k_m.gguf -ng 4096 -sm layer -mg 2 \                                               
  40.       --n-cpu-moe 16 -t 12 -c 8192                                                                                       
  41.     # mono-GPU de référence (recommandation du Vulkan Scoreboard)                                                       
  42.     llama.cpp -m qwen3-next-80b-a3b-q4_k_m.gguf -ng 4096 -sm none -mg 1 --n-cpu-moe 16


Message édité par the_fennec le 10-10-2026 à 13:49:07

---------------
Faudra que je teste un jour :o
n°53024
the_fennec
f3nn3cUs z3rd4
Posté le 10-10-2026 à 14:09:46  profilanswer
 

moyen_moins a écrit :


J'avoue ça fait partie de ces trucs qui font peur aux gens : plus rien n'est à toi, même pas ton idée (qui peut prendre du temps à être copiée). En 1 prompt mal branlé mais avec le bon skills, c'est réglé en 5min.


C'était déjà le cas pour les grosses boites, des qu'un truc buzz les GAFAs le copie sans jamais être inquiétés depuis longtemps. La ça inverse le truc, genre le gars qui a "copié" la suite Adobe en 3 prompts :o. Après il y a copié/vibé et supporter un produit. Combien de repos vibecodés sur Github n'auront jamais aucun autre commit? Faire un proto sur une idée, c'est 20% du taf', encore moins avec l'IA, le vrai boulot c'est de maintenir un truc stable et utilisable.


---------------
Faudra que je teste un jour :o
n°53025
moyen_moin​s
chat réincarné
Posté le 10-10-2026 à 14:30:59  profilanswer
 

ouais, ça rend le code jetable je trouve.
 
j'ai fait (vibecodé :o) un projet, c'est (très) loin d'être parfait mais j'essaie de faire vivre le projet quand je trouve des bugs ou des trucs à améliorer mais c'est tellement de niche...
 
par contre, je trouve qu'en très peu de temps on a fait de ces progrès en local... [:mouais]

n°53026
the_fennec
f3nn3cUs z3rd4
Posté le 10-10-2026 à 14:39:05  profilanswer
 

Merci Qwen :o
(et Strata :D)


---------------
Faudra que je teste un jour :o
n°53028
tfpsly
Sly
Posté le 10-10-2026 à 16:06:08  profilanswer
 

moyen_moins a écrit :


t'arrives à avoir des trucs de qualité avec du Q2 ? :??:


Avoir un modèle plus large semble compenser la perte de la quantization. Et surtout Qwen Flash-Next réfléchit moins longtemps/mieux que 3.8. Sur une carte 12gb, Strata+Qwen 127B bat Qwen3.8 27B - en vitesse et en qualité :
NetworkCoder - Watch This Before You Buy Next AI Hardware
https://i.ytimg.com/vi/3_7WB44_x0I/hq720.jpg?sqp=-oaymwEcCNAFEJQDSFXyq4qpAw4IARUAAIhCGAFwAcABBg==&rs=AOn4CLA5lfqa8aDD-vjfQ-JzW9oAbRIUSw

Message cité 1 fois
Message édité par tfpsly le 10-10-2026 à 16:08:53
n°53029
Pipould's
Posté le 10-10-2026 à 16:41:05  profilanswer
 

moyen_moins a écrit :


Je le savais mais je pensais pas à ce point.
La plateforme est vieille et limitée :/

 
moyen_moins a écrit :


Ah ? Je vais regardais je connais pas.


https://i.ibb.co/dwtmhnhH/Screenshot-2026-10-10-16-39-40-964-com-discord.jpg

n°53044
moyen_moin​s
chat réincarné
Posté le 11-10-2026 à 00:50:27  profilanswer
 

Faut que je quitte Windows

n°53049
chris282
id steam/psn : chris282_fr
Posté le 11-10-2026 à 05:52:55  profilanswer
 

ca y est mon Qwen3.6-35B-A3B est opérationnel. une idée de bench facile a lancer que vous aimeriez que je fasse tourner ? idéalement pas un truc qui dure 2heures pour ne pas trop faire chauffer / consommer de watts non plus
 
pour l'instant les premiers résultats sont satisfaisants :)

n°53050
chris282
id steam/psn : chris282_fr
Posté le 11-10-2026 à 05:59:53  profilanswer
 

tfpsly a écrit :


Avoir un modèle plus large semble compenser la perte de la quantization. Et surtout Qwen Flash-Next réfléchit moins longtemps/mieux que 3.8. Sur une carte 12gb, Strata+Qwen 127B bat Qwen3.8 27B - en vitesse et en qualité :
NetworkCoder - Watch This Before You Buy Next AI Hardware
https://i.ytimg.com/vi/3_7WB44_x0I/ [...] W9oAbRIUSw


j'étais dubitatif, mais le verdict de grok est tombé :

 
Citation :

Oui, l’affirmation est globalement correcte pour le setup précis montré dans la vidéo de NetworkCoder
(...)


Pourquoi ça marche (et ce que dit la communauté / les benchmarks)


Le modèle plus large compense la quantization : Flash-Next est un MoE 125B (total ~180B avec les n-gram embeddings). Même en quantisation agressive (IQ2/IQ3 via Strata ou GSQ-RCO), les benchmarks officiels de Qwen le placent au-dessus ou au niveau du 27B dense sur les tâches agentiques (ex. DeepSWE 1.1 : 58,7 vs 42,2 ; SWE-bench Pro : 62,5 vs 61,7 ; SWE-bench Multilingual nettement mieux). La sparsité (peu de paramètres actifs) + la capacité totale font le travail.


Il « réfléchit moins longtemps / mieux » : La vidéo utilise la fine-tune Swift 1.5 (UkisAI). Celle-ci réduit fortement les tokens de thinking (jusqu’à ~55-63 % en mode xhigh) avec une perte d’accuracy très faible (<1 % sur certains tests). C’est exactement ce que le post social décrit. Le base Flash-Next peut overthink ; Swift corrige ça.
Strata (moteur open-source de Niko1221) rend le 125B utilisable sur 12 Go en gardant les experts « chauds » en VRAM, les autres en RAM système, et en calculant les misses sur le CPU. Sur RTX 5070 12 Go, les chiffres officiels Strata vont de ~53 tok/s (IQ3_S, meilleure qualité) à ~94 tok/s (Q2_0, plus agressif).


a voir dans la vraie vie avec des vrais cas d'utilisation donc

Message cité 1 fois
Message édité par chris282 le 11-10-2026 à 10:39:16
n°53060
ionik
Posté le 11-10-2026 à 10:26:13  profilanswer
 

strata marche pas trop mal je trouve
 
https://rehost.diberie.com/Picture/Get/r/560942
 
Niveau retour d'information avec Qwen Next IQ2 sur du code, les résultat d'un audit de code avec claude code ne sont pas mauvais je trouve.

Message cité 3 fois
Message édité par ionik le 11-10-2026 à 10:27:41

---------------
Recette cookeo | Recette de cuisine | Extension chrome HFR
n°53061
tfpsly
Sly
Posté le 11-10-2026 à 10:31:44  profilanswer
 

chris282 a écrit :


j'étais dubatatif, mais le verdict de grok est tombé :  
 

Citation :

Oui, l’affirmation est globalement correcte pour le setup précis montré dans la vidéo de NetworkCoder
(...)
 
.


Si grok confirme, c'est que c'est faux :o

n°53062
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 10:39:00  profilanswer
 

moyen_moins a écrit :

Faut que je quitte Windows


ça oui, c'est obligé :o
 
Entre Win10 EOL; Win11 tout pourris; la chute de vente des PC; SteamOS; et les Mac qui deviennent "bon marché"; les chiffres vont pas être bon cette année pour MS :lol:


---------------
Faudra que je teste un jour :o
n°53063
chris282
id steam/psn : chris282_fr
Posté le 11-10-2026 à 10:40:05  profilanswer
 

ionik a écrit :

strata marche pas trop mal je trouve
 
https://rehost.diberie.com/Picture/Get/r/560942
 
Niveau retour d'information avec Qwen Next IQ2 sur du code, les résultat d'un audit de code avec claude code ne sont pas mauvais je trouve.


j'ai rien compris ? qui fait l'audit du code : strata+qwen ou bien claude ?

n°53064
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 10:41:50  profilanswer
 

ionik a écrit :

strata marche pas trop mal je trouve
 
https://rehost.diberie.com/Picture/Get/r/560942
 
Niveau retour d'information avec Qwen Next IQ2 sur du code, les résultat d'un audit de code avec claude code ne sont pas mauvais je trouve.


Je suis en Q2 et je me tate a passer mon server a 128GB de RAM ... alors que je viens tout juste d'acheter 2x16GB :pt1cable:
 
Faudrait que je trouve 4x32GB de DDR4 ECC pas chère vu que mon Ryzen Pro supporte l'ECC.


---------------
Faudra que je teste un jour :o
n°53065
the_fennec
f3nn3cUs z3rd4
Posté le 11-10-2026 à 10:42:51  profilanswer
 

chris282 a écrit :


j'ai rien compris ? qui fait l'audit du code : strata+qwen ou bien claude ?


Il audit le code généré par Qwen avec Claude.


---------------
Faudra que je teste un jour :o
n°53068
Pipould's
Posté le 11-10-2026 à 11:32:40  profilanswer
 

moyen_moins a écrit :

Faut que je quitte Windows


Tu peux regarder https://github.com/mw00/project-maya pour windows mais generallement TP=1 et windows c'est pas dingue dingue
 
De maniere generale windows c'est... complique ?

n°53069
Pipould's
Posté le 11-10-2026 à 11:33:27  profilanswer
 

ionik a écrit :

strata marche pas trop mal je trouve
 
https://rehost.diberie.com/Picture/Get/r/560942
 
Niveau retour d'information avec Qwen Next IQ2 sur du code, les résultat d'un audit de code avec claude code ne sont pas mauvais je trouve.


Une fois l'audit termine, demande lui un audit de l'audit... il va encore trouver des trucs...  :cry:

 Page :   1  2  3  4  5  ..  78  79  80  81  82  83

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)