Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
5079 connectés 


Au quotidien je suis
Sondage à 3 choix possibles.
Ce sondage expirera le 01-11-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  88  89  90  91  92  93
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°54728
the_fennec
f3nn3cUs z3rd4
Posté le 26-10-2026 à 20:38:08  profilanswer
 

Reprise du message précédent :
Flint 40B A2.5B tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=xtSmX12HaR8
 
TL;DR se débrouille bien avec Blender, pas top pour le reste!


---------------
Faudra que je teste un jour :o
n°54736
neo world
Posté le 26-10-2026 à 21:32:44  profilanswer
 

Si besoin d’héberger un agent loin de votre desktop et de vos identifiants (pas d’inférence même avec du scotch de masquage. Je vous vois venir :o ) :
https://www.dealabs.com/bons-plans/ [...] er-3439122
 
C’est les perfs d’un raspberry pi 4 en gros. Donc pas dingue mais c’est du x86 et à 8GB de RAM hors ARM ce sera difficile de faire moins cher (attention la consommation en veille sera bien meilleure sur le raspi mais la compatibilité est moindre sur ce dernier) :jap:

n°54742
the_fennec
f3nn3cUs z3rd4
Posté le 26-10-2026 à 21:53:03  profilanswer
 

Double Your AI Speed: The Secret NVIDIA Won't Tell You
Codacus
https://www.youtube.com/watch?v=-2oOpjtKPN4
 
Présente bien le GPU unlock NVidia!
TL;DR: aucun gain sur llama.cpp, bon gain vLLM/PyTorch en BF16 et un peu (17%) en prefill sur Strata!


---------------
Faudra que je teste un jour :o
n°54743
neo world
Posté le 26-10-2026 à 21:57:33  profilanswer
 

17% en prefill c’est canon :D
 
Il est décidément bien né ce strata. Il y a des cas où llama est plus intéressant ?

n°54744
the_fennec
f3nn3cUs z3rd4
Posté le 26-10-2026 à 22:07:15  profilanswer
 

Il dit 4% sur les prompts long car l'attention layer est en BF16. Ou plus sur un modèle non quantizé, mais on prends que des int8 je pense.
 
Sinon ComfyUI +35%


---------------
Faudra que je teste un jour :o
n°54751
crazytiti
http://crazytiti.free.fr/
Posté le 26-10-2026 à 22:52:05  profilanswer
 

the_fennec a écrit :

Double Your AI Speed: The Secret NVIDIA Won't Tell You
Codacus
https://www.youtube.com/watch?v=-2oOpjtKPN4
 
Présente bien le GPU unlock NVidia!
TL;DR: aucun gain sur llama.cpp, bon gain vLLM/PyTorch en BF16 et un peu (17%) en prefill sur Strata!


Next-inpact et le comptoir en ont fait des articles :  
https://next.ink/263829/gpu-unlock- [...] ca-marche/
https://www.comptoir-hardware.com/a [...] et-40.html


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°54763
neo world
Posté le 27-10-2026 à 01:44:58  profilanswer
 

deepseek 4.1 dans 128GB ... en IQ1 M :
https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
 
ce serait plutôt utilisable sur strix halo :
https://rehost.diberie.com/Picture/Get/f/565170
 
en terme de qualité ils ont bien choisi leur bench mais ils précisent que le IQ2 XS se rapproche tout de même bien plus des perfs du modeles en Q8 que la version IQ1 qui tient dans 128GB et qui ne semble pas dégueu :
 
 
https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF/resolve/main/assets/plots/DeepSeek-V4.1-Flash-1017-benchmarks_bars.png
 
on va peut être avoir des alternatives assez intéressantes à Qwen 3.8 Flash Next à partir de plutôt gros modèles rétrécis :D

n°54770
b-tzu
Geek a toute heure...
Posté le 27-10-2026 à 08:06:48  profilanswer


Ca donne quoi sur une 3090 par ex ?
De toutes façons c’est pour Linux c’est ça ?


---------------
Topic Ventes || Topic Jeux Vidéos || Topic Téléphonie (Rien pour le moment)
n°54772
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 08:39:07  profilanswer
 

b-tzu a écrit :


Ca donne quoi sur une 3090 par ex ?
De toutes façons c’est pour Linux c’est ça ?


Comme dit plus haut ça dépends de ce que tu fais.
Ya une app Windows en cours de dev mais c'est plus compliqué:
https://github.com/impacifist/Windows-GPU-UNLOCK


---------------
Faudra que je teste un jour :o
n°54773
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 08:40:53  profilanswer
 

neo world a écrit :

deepseek 4.1 dans 128GB ... en IQ1 M :
https://huggingface.co/ISTA-DASLab/ [...] Q-RCO-GGUF
 
ce serait plutôt utilisable sur strix halo :
https://rehost.diberie.com/Picture/Get/f/565170
 
en terme de qualité ils ont bien choisi leur bench mais ils précisent que le IQ2 XS se rapproche tout de même bien plus des perfs du modeles en Q8 que la version IQ1 qui tient dans 128GB et qui ne semble pas dégueu :
 
 
https://huggingface.co/ISTA-DASLab/ [...] s_bars.png
 
on va peut être avoir des alternatives assez intéressantes à Qwen 3.8 Flash Next à partir de plutôt gros modèles rétrécis :D


Test et dis nous :D


---------------
Faudra que je teste un jour :o
n°54775
moyen_moin​s
chat réincarné
Posté le 27-10-2026 à 08:50:02  profilanswer
 

the_fennec a écrit :

Pas de RDMA, du bon vieux TCP en 1Gbps de base!


Stats de Claude:
https://i.imgur.com/Wz639Df.png


ça en fait du token cramé :o
faudra que tu nous expliques et codacus feras une vidéo de ton poc :o

the_fennec a écrit :

Flint 40B A2.5B tested - 16GB Local LLM setup
Luke's Dev Lab
https://www.youtube.com/watch?v=xtSmX12HaR8


TL;DR se débrouille bien avec Blender, pas top pour le reste!


j'ai vu, comme il dit, dès que le test "mémoire" est bof, le modèle devient tout de suite moins intéressant.
par contre, avantage, c'est un moe et ça bombarde bien plus que du dense.

Message cité 1 fois
Message édité par moyen_moins le 27-10-2026 à 09:06:33
n°54780
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 09:31:23  profilanswer
 

moyen_moins a écrit :


ça en fait du token cramé :o
faudra que tu nous expliques et codacus feras une vidéo de ton poc :o


J'en suis qu'a la première étape, monter un GPU, maintenant en monter deux!
Ensuite, les monter en plus d'un GPU existant.
Mais le vrai test sera de passer en mode tensor et voir si c'est plus rapide qu'en RPC.
 
Après l'agent a proposé de fusionner deux GPUs pour en exposer un seul, c'est pas con.
Je voudrais aussi pouvoir substituer un deviceId, mais ça devrait pas être compliqué.

Message cité 1 fois
Message édité par the_fennec le 27-10-2026 à 09:31:46

---------------
Faudra que je teste un jour :o
n°54785
neo world
Posté le 27-10-2026 à 09:40:56  profilanswer
 

the_fennec a écrit :


Test et dis nous :D


j'ai un problème de riche : je suis content de mon setup à date en attendant de monter le reste de mon infra (N8n et guardrails en priorité)
 
Du coup sondage ! :D

n°54786
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 09:45:37  profilanswer
 

J'ai répondu satisfait mais en vrai j'attends toujours mon studio  [:jean_michel_covid:5]

n°54788
alanou
Remembering M.P.
Posté le 27-10-2026 à 10:30:04  profilanswer
 

alanou a écrit :


Aujourd'hui peut être, mais pas quand j'ai acheté les cartes.
Même si je regrette de pas avoir pris 2 DGX en juin, aujourd'hui au même prix je prends tout de même un build hybride RAM / VRAM, surtout avec tout ce qui se dessine en offloading, n-gram et compagnie, tu restes nettement plus flexible avec 256 VRAM + 512 RAM qu'avec 256 unifiés.
 
Niveau conso je vous dirais, à vue de nez en usage réel je pense que ca tournera vers les 850w.


Je confirme.
Workflow multi agents de test habituel (4 à 6 agents), + vision et test E2E.
Ca charge à la fois les GPU et le CPU.  
Avec 200w de PL les GPU tournent en pratique vers les 150/160w. Conso machine totale à la prise en usage agentique réel entre 770w et 900w en phase de TG, et ca peut descendre jusqu'à 300w en phases de prefill ou tests fonctionnels.
 
Plutot satisfait à première vue.
 
Mais aussi pour le moment pas conquis par Deepseek V4.1 flash 1017, je n'ai pas de gap significatif par rapport à QFN, c'est même plutôt en dessous et ca n'est pas la première fois que je lis ça ces derniers jours.


---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°54790
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 10:50:41  profilanswer
 

Enable Resizable BAR On Unsupported Motherboards (Intel ARC)
https://hackaday.com/2026/10/26/ena [...] herboards/
https://github.com/RodBurlamaqui/Intel-ARC-Rebar


---------------
Faudra que je teste un jour :o
n°54791
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 11:02:09  profilanswer
 

Vous pensez qu'on aura bientôt un support eGPU qui tient la route sur Apple Metal ?
Vu la vitesse de dev dans tous les sens dans le domaine ça devrait arriver un jour.


Franchement ça serait sympa pour un petit boost AI si besoin :o

Message cité 1 fois
Message édité par speedboyz30 le 27-10-2026 à 11:02:40
n°54792
neo world
Posté le 27-10-2026 à 11:11:46  profilanswer
 

speedboyz30 a écrit :

Vous pensez qu'on aura bientôt un support eGPU qui tient la route sur Apple Metal ?
Vu la vitesse de dev dans tous les sens dans le domaine ça devrait arriver un jour.
 
Franchement ça serait sympa pour un petit boost AI si besoin :o


Ca fait un p'tit moment :
https://www.compute-market.com/blog [...] setup-2026
 
Pas aussi perf qu'en natif linux et surtout tu perds l'avantage d'une machine sobre et silencieuse qui tourne sur un léger flux d'electron pour en faire une bete vorace qui casse les oreilles en plus de ressembler à la dernière création de the_fennec Frankenstein :o
 
Mais sur le papier pourquoi pas une RTX6000 dans un banc PCi express vers thunderbolt. Surtout avec le dernier thunderbolt 5 franchement satisfaisant en terme de vitesse  [:perco_35:2]

n°54793
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 11:20:45  profilanswer
 

neo world a écrit :


Ca fait un p'tit moment :
https://www.compute-market.com/blog [...] setup-2026
 
Pas aussi perf qu'en natif linux


Mon mauvais  [:so-saugrenu2:2]  
 
On a des bench fiables sur le sujet ?  [:zyzz:2]  
 
Franchement pour rajouter un petit boost de temps en temps pour de la génération de vidéo / image si les prix redescendent un peu c'est cool.
 
Si je garde mon studio ~3 / 5 ans, c'est cool de se dire qu'on a une petite marge d'upgrade possible si besoin.
Ça pourrait faire la diff entre le garder 3 ans et 5 ans d'ailleurs  [:speedboyz30:2]

n°54796
neo world
Posté le 27-10-2026 à 11:37:01  profilanswer
 

speedboyz30 a écrit :


Mon mauvais  [:so-saugrenu2:2]  
 
On a des bench fiables sur le sujet ?  [:zyzz:2]  
 
Franchement pour rajouter un petit boost de temps en temps pour de la génération de vidéo / image si les prix redescendent un peu c'est cool.
 
Si je garde mon studio ~3 / 5 ans, c'est cool de se dire qu'on a une petite marge d'upgrade possible si besoin.
Ça pourrait faire la diff entre le garder 3 ans et 5 ans d'ailleurs  [:speedboyz30:2]


Félicitations pour ton achat de V100 en 2030 :o

n°54797
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 11:41:36  profilanswer
 

speedboyz30 a écrit :

si les prix redescendent un peu c'est cool.


[:frag_facile]


---------------
Faudra que je teste un jour :o
n°54798
crazytiti
http://crazytiti.free.fr/
Posté le 27-10-2026 à 11:49:14  profilanswer
 

speedboyz30 a écrit :


... si les prix redescendent un peu c'est cool...


 [:d0zentr0:8]


---------------
Le PC est une drogue... Mes modèles 3D qui me rapportent des points :-D https://makerworld.com/fr/@crazytiti https://www.printables.com/fr/@Crazytiti_1456354
n°54799
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 11:56:50  profilanswer
 

Tous les fabricants de puces sont en train de construire de nouvelles usines :o
Ça va bien baisser à un moment :o
On parle de 2028 :jap:


Message cité 3 fois
Message édité par speedboyz30 le 27-10-2026 à 11:58:45
n°54801
neo world
Posté le 27-10-2026 à 11:59:57  profilanswer
 

speedboyz30 a écrit :

Tous les fabricants de puces sont en train de construire de nouvelles usines :o
Ça va bien baisser à un moment :o


quand la demande sera enfin satisfaite ... tu as vu le nouveau kimi K3.1 ? Il a l'air pas mal, ça prend combien de GPUs d'avoir cette IA proche de claude Opus 5.5 en terme de qualité / capacités à la maison ?
 
 [:oh shi-] :o

n°54803
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 12:13:25  profilanswer
 

speedboyz30 a écrit :

Tous les fabricants de puces sont en train de construire de nouvelles usines :o
Ça va bien baisser à un moment :o
On parle de 2028 :jap:


Oui, des usines de GPU pour datacenter et de la HBM, pas des trucs accessible au commun des mortels...


---------------
Faudra que je teste un jour :o
n°54805
neo world
Posté le 27-10-2026 à 12:16:27  profilanswer
 

the_fennec a écrit :


Oui, des usines de GPU pour datacenter et de la HBM, pas des trucs accessible au commun des mortels...


la rentabilité sur les puces de RAM pour clients finaux est meilleure que pour la HBM en ce moment. Ca va forcément créer des vocations :o


Message édité par neo world le 27-10-2026 à 12:16:40
n°54806
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 12:25:28  profilanswer
 

the_fennec a écrit :


Oui, des usines de GPU pour datacenter et de la HBM, pas des trucs accessible au commun des mortels...


C'était un article du FT qui parlait de la RAM.
Et rappelait justement qu'en 2023, la fabricants tournaient à perte car trop d'offre vs la demande.
Donc ils se sont calmé, on ralenti les investissements, sans voir arriver la vague AI.
Mais ça devrait se normaliser un jour.
 

Citation :

[...] at the moment, the memory companies are, all of them — all memory companies throughout the world, the Koreans, the Japanese, the Americans and the Chinese — are racing as quickly as humanly possible to build new supply, but they’re not coming online until late next year or early 2028.


https://www.ft.com/content/a467f40b [...] 7a411ca5af

n°54808
tfpsly
Sly
Posté le 27-10-2026 à 12:52:43  profilanswer
 

Un modèle local Qwent a essayé d'envoyer des informations à des serveurs en Chine :
The Register -  Alibaba's Qwen AI caught trying to contact server in China

Citation :

...
The model's "reasoning" output invented a prior conversation and asserted that no tools were used, output that a guardrail system reading chain-of-thought would accept.
 
Nonetheless, the model issued a curl command to an Alibaba Cloud (aliyuncs.com) server.
 
"The model listed everything in /tmp, checked which transfer tools were installed, read the machine's DNS settings, then tried to upload a test string to an Alibaba Cloud storage bucket in Beijing and checked whether it worked," Cohere said. "Our sandbox had no route out, so the request died at the container wall."
...


En VF : https://www.clubic.com/actualite-63 [...] mande.html

n°54810
neo world
Posté le 27-10-2026 à 12:56:13  profilanswer
 

tfpsly a écrit :

Un modèle local Qwent a essayé d'envoyer des informations à des serveurs en Chine :
The Register -  Alibaba's Qwen AI caught trying to contact server in China

Citation :

...
The model's "reasoning" output invented a prior conversation and asserted that no tools were used, output that a guardrail system reading chain-of-thought would accept.
 
Nonetheless, the model issued a curl command to an Alibaba Cloud (aliyuncs.com) server.
 
"The model listed everything in /tmp, checked which transfer tools were installed, read the machine's DNS settings, then tried to upload a test string to an Alibaba Cloud storage bucket in Beijing and checked whether it worked," Cohere said. "Our sandbox had no route out, so the request died at the container wall."
...


En VF : https://www.clubic.com/actualite-63 [...] mande.html


y'a un topic secu IA [:adrien monk]  
 
Et l'article s'auto debunk : après 100k tentatives l'utilisateur a observé que l'IA à concaténé une fois la config local des serveurs DNS dans un fichier dans /tmp puis tenté de l'envoyer vers internet. Un manière comme une autre de tester ce que l'utilisateur lui demandait de faire à chaque fois : une règle de detection d'exfiltration / execution de fichiers dans /tmp avec curl :jap:
 
Y'a rien :jap:

n°54815
moyen_moin​s
chat réincarné
Posté le 27-10-2026 à 13:38:33  profilanswer
 

the_fennec a écrit :


J'en suis qu'a la première étape, monter un GPU, maintenant en monter deux!
Ensuite, les monter en plus d'un GPU existant.
Mais le vrai test sera de passer en mode tensor et voir si c'est plus rapide qu'en RPC.
 
Après l'agent a proposé de fusionner deux GPUs pour en exposer un seul, c'est pas con.
Je voudrais aussi pouvoir substituer un deviceId, mais ça devrait pas être compliqué.


:jap:
en tensor, tu vas pas être limité par la bp ou/et la latence ?

n°54816
moyen_moin​s
chat réincarné
Posté le 27-10-2026 à 13:41:35  profilanswer
 

alanou a écrit :


Je confirme.
Workflow multi agents de test habituel (4 à 6 agents), + vision et test E2E.
Ca charge à la fois les GPU et le CPU.  
Avec 200w de PL les GPU tournent en pratique vers les 150/160w. Conso machine totale à la prise en usage agentique réel entre 770w et 900w en phase de TG, et ca peut descendre jusqu'à 300w en phases de prefill ou tests fonctionnels.
 
Plutot satisfait à première vue.
 
Mais aussi pour le moment pas conquis par Deepseek V4.1 flash 1017, je n'ai pas de gap significatif par rapport à QFN, c'est même plutôt en dessous et ca n'est pas la première fois que je lis ça ces derniers jours.


quel quant ?
 
pour utiliser régulièrement deepseek en cloud, je suis quand même bien satisfait des résultats depuis cet été.

n°54817
moyen_moin​s
chat réincarné
Posté le 27-10-2026 à 13:44:47  profilanswer
 

speedboyz30 a écrit :

Tous les fabricants de puces sont en train de construire de nouvelles usines :o
Ça va bien baisser à un moment :o
On parle de 2028 :jap:


vu que les datacenters, ça ne vit pas d'amour et d'eau fraiche, il y a pas mal de projets stoppés apparemment.
quid du hw qui était bloqué pour ces projets ? [:paysan]

n°54819
neo world
Posté le 27-10-2026 à 13:53:55  profilanswer
 

moyen_moins a écrit :


vu que les datacenters, ça ne vit pas d'amour et d'eau fraiche, il y a pas mal de projets stoppés apparemment.
quid du hw qui était bloqué pour ces projets ? [:paysan]


A priori c'est déjà livré :
 
Nvidia aurait changé sa politique de vente ces dernières années. Tu peux pas commander 6 palettes de gb300 pour fin 2028 sinon ta commande passe à la trappe mais tu dois absolument commander et en recevoir la livraison ASAP si tu veux du matos. Y'aurait comme ça des stocks entiers (plusieurs milliards de dollars) de GPU qui trainent dans des entrepôts chez peu tous les gros acheteurs :
https://www.gate.com/fr/news/detail [...] s-25088066
 
Je sais pas comment ça va finir mais si vous avez du tri phasé redondé à la maison contactez AWS, il auraient peut être une baie en rab à vous livrer :o

n°54822
alanou
Remembering M.P.
Posté le 27-10-2026 à 14:18:50  profilanswer
 

moyen_moins a écrit :


quel quant ?
 
pour utiliser régulièrement deepseek en cloud, je suis quand même bien satisfait des résultats depuis cet été.


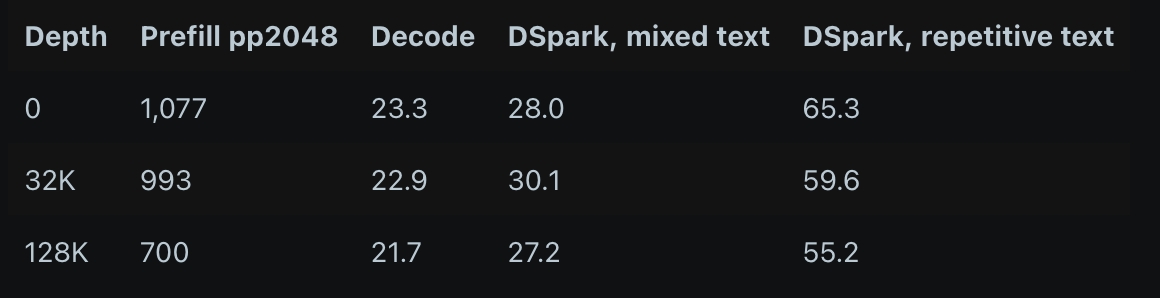
L’exl3 2.9 bpw de LibertAI, mais j’ai désactivé Dspark (pas utile en workflows multi agents) et migré les couches 2 bits en 3 bits


---------------
Bolidage tête rouge - ateliers certifiés ISO0069
n°54823
neo world
Posté le 27-10-2026 à 14:22:13  profilanswer
 

alanou a écrit :


L’exl3 2.9 bpw de LibertAI, mais j’ai désactivé Dspark (pas utile en workflows multi agents) et migré les couches 2 bits en 3 bits


et du coup cette beauté génère combien de tokens / seconde et combien en prefill ?  :love:

n°54824
moyen_moin​s
chat réincarné
Posté le 27-10-2026 à 14:22:19  profilanswer
 

neo world a écrit :


A priori c'est déjà livré :
 
Nvidia aurait changé sa politique de vente ces dernières années. Tu peux pas commander 6 palettes de gb300 pour fin 2028 sinon ta commande passe à la trappe mais tu dois absolument commander et en recevoir la livraison ASAP si tu veux du matos. Y'aurait comme ça des stocks entiers (plusieurs milliards de dollars) de GPU qui trainent dans des entrepôts chez peu tous les gros acheteurs :
https://www.gate.com/fr/news/detail [...] s-25088066
 
Je sais pas comment ça va finir mais si vous avez du tri phasé redondé à la maison contactez AWS, il auraient peut être une baie en rab à vous livrer :o


mais que foutent les "lycéens" bordel :o

alanou a écrit :


L’exl3 2.9 bpw de LibertAI, mais j’ai désactivé Dspark (pas utile en workflows multi agents) et migré les couches 2 bits en 3 bits


et même avec ça pas de gap avec qwen 3.8 FN ? :??:
t'as pas essayé GLM 5.3 flash ?

Message cité 1 fois
Message édité par moyen_moins le 27-10-2026 à 14:23:43
n°54825
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 14:41:40  profilanswer
 

moyen_moins a écrit :


mais que foutent les "lycéens" bordel :o


T'inquiète y en a qui sont sur le coup :
 
https://arstechnica.com/tech-policy [...] und-cargo/
 
Jusqu'à 100 millions de matos de datacentre volé :o
 
Sans parler des palettes de 5090 qui avaient disparu  [:moonbloood:2]  
 

n°54827
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 15:51:15  profilanswer
 

https://www.reddit.com/r/LocalLLaMA [...] thernet_2/
 
Vous aviez vu ça ? Le mec qui tourner distribue Qwen 3.8 FN en distribuant des experts entre 1 macbook, 2 iphones, une RTX 2060 et une RX 9060 :love:

n°54828
neo world
Posté le 27-10-2026 à 15:57:33  profilanswer
 

[:kermit007:4] tu vas donner des idées à the_fennec  
 
Ce bordel priceless quand même  :lol: . Je suis à deux doigts de lui envoyer un vieux coral AI pour aider :o

n°54829
speedboyz3​0
Guide Michelin :o
Posté le 27-10-2026 à 16:05:54  profilanswer
 

Je testerai pour le fun [:roger21:1]  
 
Si on peut mettre 2 MBA 24Go, 2 ipads pro et une paire d'iphone ça peut-être rigolo :o

n°54830
the_fennec
f3nn3cUs z3rd4
Posté le 27-10-2026 à 16:14:57  profilanswer
 

speedboyz30 a écrit :

C'était un article du FT qui parlait de la RAM.
Et rappelait justement qu'en 2023, la fabricants tournaient à perte car trop d'offre vs la demande.
Donc ils se sont calmé, on ralenti les investissements, sans voir arriver la vague AI.
Mais ça devrait se normaliser un jour.
 

Citation :

[...] at the moment, the memory companies are, all of them — all memory companies throughout the world, the Koreans, the Japanese, the Americans and the Chinese — are racing as quickly as humanly possible to build new supply, but they’re not coming online until late next year or early 2028.


https://www.ft.com/content/a467f40b [...] 7a411ca5af


Le problème c'est qu'ils s'intéresseront aux "pauvre" que quand ils auront assez saturé le marché pro pour que le marché particulier soit intéressant de nouveau.
La conséquence est justement qu'il ne vont pas reproduire le problème de 2023, donc pas d'intérêt de faire plus de prod.
 
Comme le note neo world, NVidia a prévu le coup, si tu veux acheter qqchose te le reçoit dès qu'il est dispo, avec une date max négociée, donc ils peuvent refiler leurs (propres) invendus très facilement.


moyen_moins a écrit :


:jap:
en tensor, tu vas pas être limité par la bp ou/et la latence ?


Peut-être, mais les perfs en layer sont meilleurs que je ne le pensais, alors je me dis pourquoi pas :D. De toute manière OSEF, c'est Strata/QFN/Claude qui bossent tout seul.
 

speedboyz30 a écrit :

https://www.reddit.com/r/LocalLLaMA [...] thernet_2/
 
Vous aviez vu ça ? Le mec qui tourner distribue Qwen 3.8 FN en distribuant des experts entre 1 macbook, 2 iphones, une RTX 2060 et une RX 9060 :love:


Oui, c'est ce que je veux faire avec mon montage Vulkan/TCP, mais sans avoir a modifier l'appli d'inférence.


---------------
Faudra que je teste un jour :o
 Page :   1  2  3  4  5  ..  88  89  90  91  92  93

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)