Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
3970 connectés 


Je génère ...
Sondage à 3 choix possibles.
Ce sondage expirera le 20-09-2026 à 10:00


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  45  46  47  ..  60  61  62  63  64  65
Auteur Sujet :

Infra IA : aide au choix et troubleshot de LLM Locaux

n°46305
extenue1
Posté le 26-08-2026 à 01:23:44  profilanswer
 

Reprise du message précédent :


Merci , on peut esperer faire tourner quoi correctement a ton avis avec le Mini M6 32 GB ?

n°46308
AllenMadis​on
Oracle du Keb's
Posté le 26-08-2026 à 07:39:52  profilanswer
 

XprtZ a écrit :


12K€ et quasi le double pour 512go  [:galom]
 
Qui achète ?  [:catalonix:10]


Ces prix sont scandaleux :o
 
Tu divises par 2 ça aurait été ultra compétitif et très tentant.


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46309
AllenMadis​on
Oracle du Keb's
Posté le 26-08-2026 à 07:42:35  profilanswer
 

extenue1 a écrit :


Merci , on peut esperer faire tourner quoi correctement a ton avis avec le Mini M6 32 GB ?


Rien de plus que ce qu'une 5090 fait tourner.


Le best bet rapport qualité/prix c'est d'attendre les prochains ryzen 495 Pro max+ avec 196go de ram


En l'état actuel de la situation, soit ça n'a pas assez de ram pour les gros modèles, soit c'est overpricé à base de 10k€ en premier prix. Je doute qu'AMD facture 10.000€ leur prochain cpu AI sachant que le 395 est plutot abordable.

Message cité 2 fois
Message édité par AllenMadison le 26-08-2026 à 07:44:35

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46311
neo world
Posté le 26-08-2026 à 08:05:49  profilanswer
 

the_fennec a écrit :


160GB de DDR6 :love:  
Manque que le prix, vu comment c'est partis, en 2027 on va être sur 50K euros :o


J’ai lu quelqu’un estimer son prix à 2k€. Je pense qu’il a regardé les prix de la ram de l’été 2025 pour faire son estimation :o

n°46312
AllenMadis​on
Oracle du Keb's
Posté le 26-08-2026 à 08:09:21  profilanswer
 

neo world a écrit :


J’ai lu quelqu’un estimer son prix à 2k€. Je pense qu’il a regardé les prix de la ram de l’été 2025 pour faire son estimation :o


Si seulement..... Il a du oublier un zéro :o


Message édité par AllenMadison le 26-08-2026 à 08:09:37

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46315
neo world
Posté le 26-08-2026 à 08:39:04  profilanswer
 

AllenMadison a écrit :


Rien de plus que ce qu'une 5090 fait tourner.  
 
Le best bet rapport qualité/prix c'est d'attendre les prochains ryzen 495 Pro max+ avec 196go de ram
 
En l'état actuel de la situation, soit ça n'a pas assez de ram pour les gros modèles, soit c'est overpricé à base de 10k€ en premier prix. Je doute qu'AMD facture 10.000€ leur prochain cpu AI sachant que le 395 est plutot abordable.


méfiez vous, les prix se sont envolés dernièrement sur à peu prêt tous les modèles occidentaux. La machine la plus abordable en 395+ prend 100€ tous les deux mois. Je pense que dans le meilleurs des cas il faudra s'attendre à 4000 balles (le prix du gb10) vu les 64GO supplémentaires par rapport à lui et j'imagine trois autres optimisations par ci par là.
 
Par contre si le marché est saturé avec la MI ai box, Apple et si la gb10 devient "désuète" (plus assez de ram) il pourrait y avoir de bonnes affaire à faire sur le 395+  :jap:

n°46322
croustx
Modoadorateur
Posté le 26-08-2026 à 09:40:46  profilanswer
 

the_fennec a écrit :

Faut pas hésiter a partager les liens HF et les retours :o


Je tourne avec huihui_ai/Qwen3.8-abliterated
 
 
Petit retour/comparo sur les versions abliterated de Qwen 3.8 27B :
 
huihui_ai (approche chirurgicale / conservatrice) :
- L'auteur privilégie la rétention des capacités cognitives et le mode de raisonnement (<think> ).
- Les premières couches (syntaxe et parsing de base), la tour de vision et les têtes MTP (Multi-Token Prediction) restent totalement intactes.
- Résultat : Excellent maintien des performances en dev/logique, tout en éliminant les refus standard (over-refusal). Très bon compromis pour un usage quotidien/agent.
 
OBLITERATUS (approche agressive / brute force) :
- Projection orthogonale systématique des vecteurs de refus appliquée sur l'intégralité des couches.
- Résultat : Taux de refus quasi nul (0% sur les suites de test, modèle 100% débridé), mais au prix d'une légère dégradation de la perplexité et de la précision sur le code pointu et les maths complexes.
 
En résumé :
Prenez huihui_ai par défaut pour coder et raisonner proprement sans refus absurdes ; passez sur OBLITERATUS uniquement si vous cherchez du uncensored total sans aucune friction.

n°46323
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 09:42:36  profilanswer
 

extenue1 a écrit :


Merci , on peut esperer faire tourner quoi correctement a ton avis avec le Mini M6 32 GB ?


Techniquement tu peux tabler sur 24GB max pour le modèle et le contexte, un chouilla plus en bidouillant. Donc un Qwen 27B/35B Q5/Q6 pas beaucoup mieux. Après faut voir la vitesse du SSD et si Apple a rajouté des trucs pour le streaming, ya peut être moyen d'avoir des modèles plus gros. Je suis curieux de voir ce que le m6 apporte de nouveau.
 

AllenMadison a écrit :


Rien de plus que ce qu'une 5090 fait tourner.  
Le best bet rapport qualité/prix c'est d'attendre les prochains ryzen 495 Pro max+ avec 196go de ram
 
En l'état actuel de la situation, soit ça n'a pas assez de ram pour les gros modèles, soit c'est overpricé à base de 10k€ en premier prix. Je doute qu'AMD facture 10.000€ leur prochain cpu AI sachant que le 395 est plutot abordable.


Aucun rapport, une 5090 c'est quasi 5000 euros, et a ce prix tu doit rajouter un système autour, donc au moins 7000 euros en tout, le m6 32GB est a 1500 ...
A ce prix t'as un un m5 Max avec 128GB...
 
Pareil pour les autres systèmes, pas du tout le même genre de prix.


---------------
Faudra que je teste un jour :o
n°46324
Amonchakai
Posté le 26-08-2026 à 09:44:18  profilanswer
 

Et les perfs sont les même ?  :o

n°46325
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 10:02:18  profilanswer
 

Amonchakai a écrit :

Et les perfs sont les même ?  :o


Je pense que le m5 sera beaucoup plus rapide pour un gros modèle genre 100GB la ou la 5090 pourra rien faire avec 32GB de VRAM et le peu de DDR5 que tu auras pu te payer. Après si ton modèle est un MoE tu peux faire des trucs.
 
Avec ta machine a 7000 balles tu peux même pas faire tourner Qwen 3.8 27B non quantifié, il fait 55GB! [:la chancla:1]


---------------
Faudra que je teste un jour :o
n°46326
Amonchakai
Posté le 26-08-2026 à 10:10:28  profilanswer
 

Ouais, si tu sors de la VRAM dispo et que le GPU se tourne les pouces a attendre, ça complique c'est sur ^^
 
En fait ma réflexion c'était surtout sur quel est l'objectif. En hobbyste fortuné, c'est bien, ça permets de jouer "que" pour 5k euros.  
Mais je me dis que quand c'est pour le boulot, faudrait aussi voir le cout horaire des gens qui attendent dans l'équation. Donc rajouter quelques 5090 et avoir une machine plus chère a l'achat vaut surement le cout.


Message édité par Amonchakai le 26-08-2026 à 10:24:04
n°46331
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 10:42:11  profilanswer
 

Le problème c'est que pour 5000 euros tu joues pas a grand chose niveau LLM, déjà ta que le GPU a ce prix. Si tu vas chez Apple, ou prends un Strix ou un Spark t'as un système complet, cohérent et bien supporté.
 
Pour le boulot, ça dépends de ce que tu fais, mais je me serais pas orienté vers des 5090. Vaut mieux partir sur des RTX PRO ou l'équivalent AMD.


---------------
Faudra que je teste un jour :o
n°46332
neo world
Posté le 26-08-2026 à 10:45:15  profilanswer
 

si quelqu'un connait un fournisseur de Jalapeno qu'il me fasse signe :o
https://openai.com/index/jalapeno-first-results/

n°46333
Amonchakai
Posté le 26-08-2026 à 10:46:31  profilanswer
 

Ouais je suis d’accord, à 5000 tu as pas le budget pour bosser ou faut faire avec les solution cloud.
 
Et pour jouer, bah ouais pourquoi pas les spark et Apple

Message cité 2 fois
Message édité par Amonchakai le 26-08-2026 à 10:46:52
n°46335
moyen_moin​s
chat réincarné
Posté le 26-08-2026 à 11:12:47  profilanswer
 

the_fennec a écrit :

35B-A3B tool calling benchmark: Original Qwen vs. KAT Coder, Ornith and Tiel-Coder
https://www.reddit.com/r/LocalLLaMA [...] l_qwen_vs/


Intéressant de voir des fine-tune de 35B faire mieux que 27B 3.6, mais en dessous de 3.8 ce qui est logique.
Je vais peut être tester un jour en fait :o

Spoiler :

mais pas demain


il y a un fine tune du 3.6 35B pour hermes et les tool calling que j'utilise aussi (j'ai vu qu'il était passé en V10).
edit: LuffyTheFox/Qwen3.6-35B-A3B-Uncensored-Genesis-Hermes-V10-GGUF


Message édité par moyen_moins le 26-08-2026 à 11:19:05
n°46336
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 11:13:09  profilanswer
 

Le truc surtout, c'est que si c'est pour le boulot, faut pas raisonner en coût d'achat mais en coût d'opération (et en HT)


Donc ton studio à ~5000 balles en capex, ça fait à peine 105 euros par mois sur 4 ans. Le prix d'un abo claude 5x.


Bon après faut s'imaginer la capacité d'un Claude x5 dans 4 ans vs ton mac studio dépassé quoi :o

Message cité 1 fois
Message édité par speedboyz30 le 26-08-2026 à 11:13:55
n°46337
croustx
Modoadorateur
Posté le 26-08-2026 à 11:20:40  profilanswer
 

speedboyz30 a écrit :

Le truc surtout, c'est que si c'est pour le boulot, faut pas raisonner en coût d'achat mais en coût d'opération (et en HT)
 
Donc ton studio à ~5000 balles en capex, ça fait à peine 105 euros par mois sur 4 ans. Le prix d'un abo claude 5x.
 
Bon après faut s'imaginer la capacité d'un Claude x5 dans 4 ans vs ton mac studio dépassé quoi :o


Et Claude sera peut-être à 300€/ mois dans 5 ans :o
 
En entreprise, faut aussi prendre en considération que tu ne vas pas envoyer tes data vers les USA

n°46338
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 11:24:13  profilanswer
 

croustx a écrit :

En entreprise, faut aussi prendre en considération que tu ne vas pas envoyer tes data vers les USA


Ça dépend quelle entreprise.
Le client potentiel du Studio c'est plus la PME du coin ou l’entrepreneur solo que la boîte de défense du cac 40.
Donc osef pour ceux là dans 99% des cas non ?
 
En terme d'output, je ne me rends pas compte si un studio à 5k sort quelque chose de comparable à un claude 5x cela dit.
(Modulo le temps de réponse qui sera toujours un peu plus long en local)
 
Vous avez une idée ?

n°46339
neo world
Posté le 26-08-2026 à 11:24:50  profilanswer
 

avec l'arrivée d'hardware spécialisé (TPU, jalapeno, l'équipe qu'est en train de monter ANthropic) on peut s'attendre à une belle optimisation si en plus les chinois continuent de monter des modèles solides avec trois GPU chopés au fond d'une cale de bateau et d'optimiser les coûts d'entrainement.
 
J'ai l'impression qu'on va vers une époque où le AI slope sera facile et peu couteux à produire par n'importe qui.  
 
Y'a de la marge encore pour de la vraie IA par contre et l'archi actuelle me semble peu efficiente pour y arriver chez les gros players comme à la maison

n°46340
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 11:28:39  profilanswer
 

Ils ont fait passer la bande passante de la RAM de 820 GB/s à 1.2 TB/s les cochons sur le M5 Ultra.
 
Combiné avec les GPU Neural Accelerators et un ssd 2x plus rapide ça promet ~30/50% de tokens/s en plus.

n°46342
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 11:33:59  profilanswer
 

neo world a écrit :

d'optimiser les coûts d'entrainement


Tu veux dire de pomper sur les modèles US ? :o

n°46343
neo world
Posté le 26-08-2026 à 11:38:06  profilanswer
 

c'est ce que disent les ricains. Les mêmes qui ont pompé les datas de tout le monde sans demander d'abord :D

n°46345
croustx
Modoadorateur
Posté le 26-08-2026 à 11:47:26  profilanswer
 

speedboyz30 a écrit :


Ça dépend quelle entreprise.
Le client potentiel du Studio c'est plus la PME du coin ou l’entrepreneur solo que la boîte de défense du cac 40.
Donc osef pour ceux là dans 99% des cas non ?


Je suis peut-être matrixié par mon domaine, mais je t'assure que PERSONNE ne veut que son fichier client ne sorte des murs de l'entreprise.

n°46347
neo world
Posté le 26-08-2026 à 11:48:53  profilanswer
 

Nouveau sondage  [:zagobar]

n°46349
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 11:51:52  profilanswer
 

Amonchakai a écrit :

Ouais je suis d’accord, à 5000 tu as pas le budget pour bosser ou faut faire avec les solution cloud.
 
Et pour jouer, bah ouais pourquoi pas les spark et Apple


Sachant que le prix d'introduction de la 5090 était de 2000 euros et aurais du descendre si on avait une économie comme avant. Les solutions basées sur NVidia sont difficilement rentables si on chercher autre chose que la perf pure.


---------------
Faudra que je teste un jour :o
n°46350
AllenMadis​on
Oracle du Keb's
Posté le 26-08-2026 à 11:52:03  profilanswer
 

Apres bon y'a Claude qui me refuse en ce moment de bosser sur des fichiers dont j'ai besoin, et qui me sort un refus strict alors qu'il avait déjà bossé dessus dans une session précédente.


1ere session : pas de problème on fonnnnnnce
2e session : je vois que ces fichiers sont potentiellement soumis à une licence alors je veux rien entendre patati patata c'est comme ça je changerai pas d'avis patati patata


J'ai beau lui expliquer que j'ai la licence sur ces fichiers + il a déjà bossé avant dessus, il a pris sa décision et s'entête dans sa mauvaise foi du genre "oui mais c'était une erreur de ma part dans la précédente session, je n'aurais pas du, patati patata va voir ailleurs patati patata c'est toujours non". Y'a rien a faire pour lui faire changer d'avis.


Voilà pourquoi je suis tenté de prendre une IA en local qui n'a pas ces foutues restrictions


Message édité par AllenMadison le 26-08-2026 à 11:52:48

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46351
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 11:55:25  profilanswer
 

croustx a écrit :

Je suis peut-être matrixié par mon domaine, mais je t'assure que PERSONNE ne veut que son fichier client ne sorte des murs de l'entreprise.


Ouais, mais généralement ces personnes n'ont aucun soucis à mettre leur fichiers sur OneDrive, Exchange365/Outlook...  


---------------
Faudra que je teste un jour :o
n°46354
neo world
Posté le 26-08-2026 à 12:07:03  profilanswer
 

Bon je note qu'on est un topic de riches IA-fauchés qui ne prévient pas quand on écrit n'importe quoi dans le sondage :o

n°46355
XprtZ
Profil : O.O
Posté le 26-08-2026 à 12:19:51  profilanswer
 

Moi j'avoue que ça me tente bien de prendre le truc à 13K bien que mon usage soit trèèèèèèèèèès limité maintenant mais bon, je suis freelance donc j'ai pas le même ressenti.
 
Si c'était en perso, par contre, c'était non à 100% :D
 
edit :entre hier et maintenant, on est passé d'une livraison le 20 octobre au... 20 novembre pour le 256go  [:clooney24]  
 
/FOMO  [:kabouk:2]


Message édité par XprtZ le 26-08-2026 à 12:24:11

---------------
PSN : XprtZ - BattleTag : XprtZ#2257 - 3DS : 2492-4109-3060
n°46357
Tronklou
❤❤ Vrp Bambulab à mi-temps ❤❤
Posté le 26-08-2026 à 12:25:29  profilanswer
 

Perso le local c'est :
1 pour faire mumuse
2 une geekerie


Mais aussi pouvoir faire du pr0n sans avoir la gendarmerie nationale qui toque a 7h du matin  :O


Par contre clairement, 32gb de vram et qwen ça commence a pouvoir suffire dans beaucoup de cas d'usage.
Mais en face les coûts d'inférence sont globalement de plus en plus bas au ratio perf/token grâce à la concurrence....
Et les abonnements aussi


---------------
Victime de girafophobie, mais se soigne.
n°46358
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 12:28:28  profilanswer
 

neo world a écrit :

Bon je note qu'on est un topic de riches IA-fauchés qui ne prévient pas quand on écrit n'importe quoi dans le sondage :o


Je pensais que "bablemeLes" était un mème de djeuns que j'étais trop vieux pour comprendre :o


---------------
Faudra que je teste un jour :o
n°46359
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 12:33:41  profilanswer
 

Tronklou a écrit :

Perso le local c'est :
1 pour faire mumuse
2 une geekerie
 
Mais aussi pouvoir faire du pr0n sans avoir la gendarmerie nationale qui toque a 7h du matin  :O  
 
Par contre clairement, 32gb de vram et qwen ça commence a pouvoir suffire dans beaucoup de cas d'usage.


Pareil :o
 
J'ai mon rig IA qui tourne juste pour voir ce a quoi il arrivera. Limite OSEF du résultat. La ça fait plus de 6 jours qu'il tourne sur le même prompt 2.5M de tokens. Je pense que je peux dire que CC est stable :o
Peut être que le mettrais a bosser sur ReactOS ensuite :D
 

Tronklou a écrit :


Mais en face les coûts d'inférence sont globalement de plus en plus bas au ratio perf/token grâce à la concurrence....
Et les abonnements aussi


C'est sur que pour bosser c'est pas rentable le local, mais pour s'amuser en YOLO c'est mieux.


Message édité par the_fennec le 26-08-2026 à 12:35:01

---------------
Faudra que je teste un jour :o
n°46360
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 12:33:49  profilanswer
 

4000 européens pour ça en tarif éducation :
 
Mac Studio avec puce M5 Max
CPU 18 cœurs, GPU 40 cœurs, Neural Engine 16 cœurs
64 Go de mémoire unifiée
1 To de stockage
 
 [:moonbloood:2]  
 
Ça commence à être sympa en local :o

n°46361
the_fennec
f3nn3cUs z3rd4
Posté le 26-08-2026 à 12:35:47  profilanswer
 

64Go ça tombe pas rond, il faut 128 :D


---------------
Faudra que je teste un jour :o
n°46362
neo world
Posté le 26-08-2026 à 12:37:28  profilanswer
 

c'est pas mal :D t'as toujours moins de ram que sur le strix halo mais ça devrait tourner deux fois plus vite. On a vu pire deal chez la pomme :D

n°46364
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 12:44:17  profilanswer
 

neo world a écrit :

c'est pas mal :D t'as toujours moins de ram que sur le strix halo mais ça devrait tourner deux fois plus vite. On a vu pire deal chez la pomme :D


Ouais c'est pas dégueulasse.  
 
Niveau revente sur un studio tu t'en sors mieux.
Et effectivement on devrait avoir au moins 2x plus de tokens/s.
(sans compter le risque de throttling sur se Strix Halo  :pfff: )

n°46365
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 12:46:42  profilanswer
 

the_fennec a écrit :

64Go ça tombe pas rond, il faut 128 :D


C'est jamais rond  [:leve le pied jeannot:1]

n°46366
neo world
Posté le 26-08-2026 à 12:48:54  profilanswer
 

https://rehost.diberie.com/Picture/Get/f/538931
 
Je trouve les nouveaux prix affligeants par rapport au M3 ultra mais en l'état du marché le deal est bon. Ca va peut être faire un peu bouger nvidia sur le haut de gamme (+ de VRAM ou une alternative plus competitive (gb20 ?) que le RTX pro 6000 avec plus de VRAM et un chouille moins de rapidité pour avoir quelque chose à aligner face à Apple

n°46367
neo world
Posté le 26-08-2026 à 12:50:03  profilanswer
 

speedboyz30 a écrit :


C'est jamais rond  [:leve le pied jeannot:1]


avec deux mac studio 512GB tu as un 1 TB de RAM si les chiffres ronds vous plaisent :o

n°46368
speedboyz3​0
Guide Michelin :o
Posté le 26-08-2026 à 12:54:47  profilanswer
 

neo world a écrit :

https://rehost.diberie.com/Picture/Get/f/538931


Je trouve les nouveaux prix affligeants par rapport au M3 ultra mais en l'état du marché le deal est bon. Ca va peut être faire un peu bouger nvidia sur le haut de gamme (+ de VRAM ou une alternative plus competitive (gb20 ?) que le RTX pro 6000 avec plus de VRAM et un chouille moins de rapidité pour avoir quelque chose à aligner face à Apple


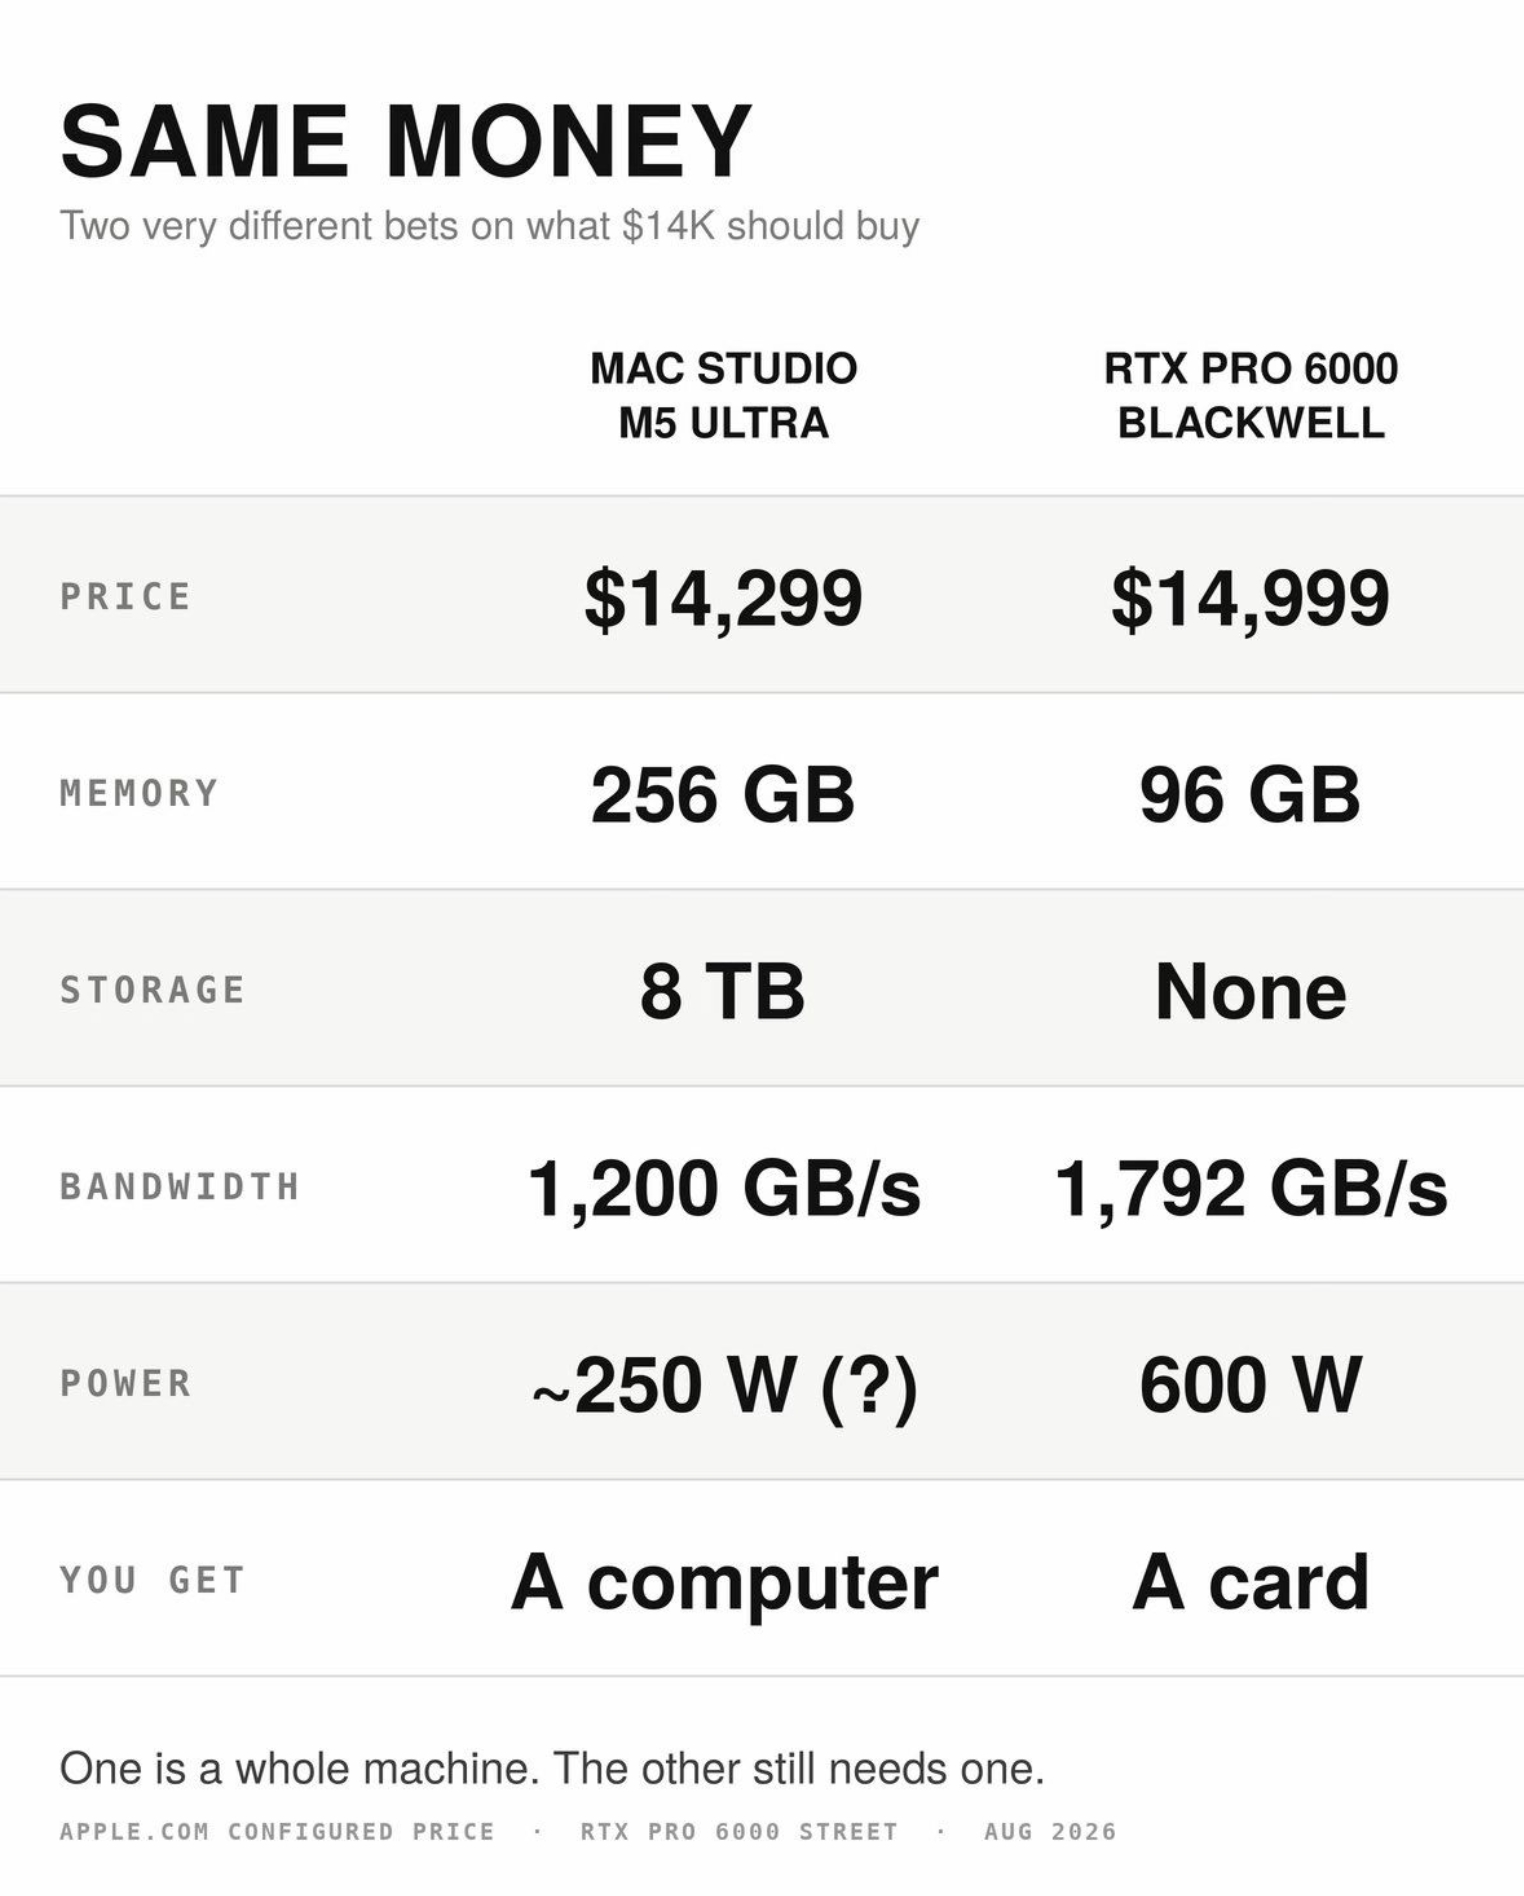
Surtout qu'en local aujourd'hui, il vaut mieux passer à 256Go de ram que de passer de 1.2Tb/s à 1.8Tb/s.


Après au lieu de same money, ils auraient dû faire same RAM et là ton Ultra il tombe à <7,000$  :love:


Message édité par speedboyz30 le 26-08-2026 à 13:00:47
n°46369
moyen_moin​s
chat réincarné
Posté le 26-08-2026 à 13:14:55  profilanswer
 

Question pour les pros ou amateurs éclairés :)


Pour un projet avec pas mal de RAG et de l'analyse de texte avec raisonnement (no code), quelle version de qwen 3.8 il vaut mieux prendre sachant que je souhaite contexte max et que j'ai que 30Go de VRAM dispo environ ? :o
J'hésite entre UD_IQ4_XS chez unsloth ou du UD_Q4_K_XL mais il y a 3Go de diff et la taille du contexte est vraiment un critère important.
En Q6, j'arrive à gratter que 66k de contexte par exemple :/

Message cité 1 fois
Message édité par moyen_moins le 26-08-2026 à 13:15:35
 Page :   1  2  3  4  5  ..  45  46  47  ..  60  61  62  63  64  65

Aller à :
Ajouter une réponse
 

Sujets relatifs
[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & cosécurité de l'IA / agentique et des Devs en roue libre
Plus de sujets relatifs à : Infra IA : aide au choix et troubleshot de LLM Locaux


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)