Forum |  HardWare.fr | News | Articles | PC | S'identifier | S'inscrire | Shop Recherche
4839 connectés 


Avez-vous basculé sur ChatGPT Plus ?


Attention si vous cliquez sur "voir les résultats" vous ne pourrez plus voter

 Mot :   Pseudo :  
  Aller à la page :
 
 Page :   1  2  3  4  5  ..  482  483  484  ..  541  542  543  544  545  546
Auteur Sujet :

[Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co

n°46828
AllenMadis​on
Oracle du Keb's
Posté le 30-08-2026 à 23:25:26  profilanswer
 

Reprise du message précédent :

H00d a écrit :

Alors il est gentil mais c'est plus possible de bourriner comme avant, avec la limite des 5H.


tu utilises /fast écébon


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46829
AllenMadis​on
Oracle du Keb's
Posté le 30-08-2026 à 23:26:32  profilanswer
 

bulldozer_fusion a écrit :


Moi qui pensait xat dans les hfr+


Franch'ment...


Edit : quota épuisé, plus qu'a attendre le reset :o


Message édité par AllenMadison le 31-08-2026 à 00:21:28

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46840
AllenMadis​on
Oracle du Keb's
Posté le 31-08-2026 à 02:13:08  profilanswer


Plus que 47mn  [:rage_anormale]


Reset effectué avec 1H de retard :o


Message édité par AllenMadison le 31-08-2026 à 05:37:39

---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°46844
gusano
Posté le 31-08-2026 à 07:46:50  profilanswer
 

AAF

n°46861
extenue1
Posté le 31-08-2026 à 10:10:28  profilanswer
 

Big Blue a écrit :


Faut pas qu’il fasse ça :o


Opencode a 8,5€ est vraiment top avec Deepseek v4 flash :o Surtout pas lancer de gros modèle, j’ai consommé 50% du quotas avec un prompt k3 mais en ds4 ça ne bouge pas.


Et niveau intelligence c’est autre chose que Luna …


Je plussoie ... 4% de quota mensuel bouffé avec une seule requete luna

n°46909
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 31-08-2026 à 13:27:25  profilanswer
 

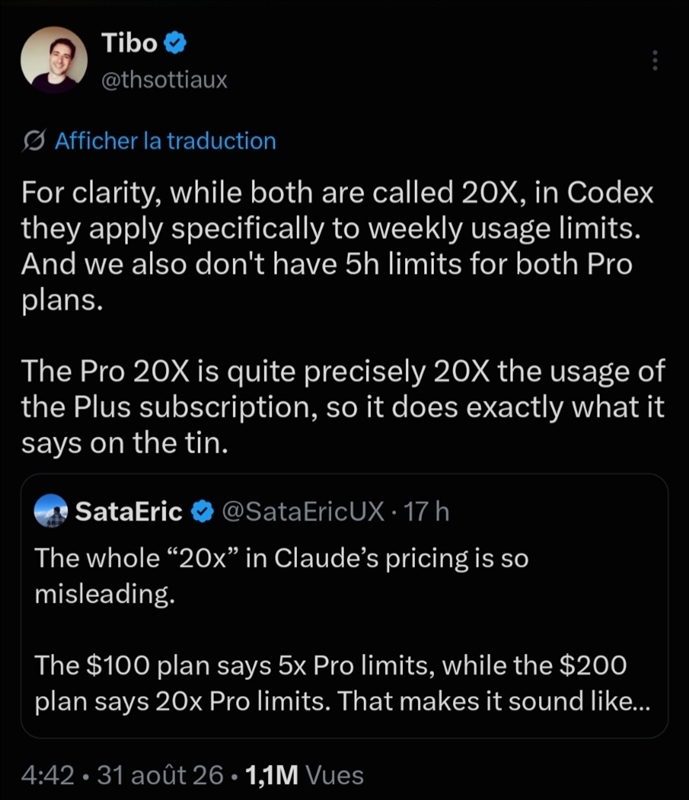
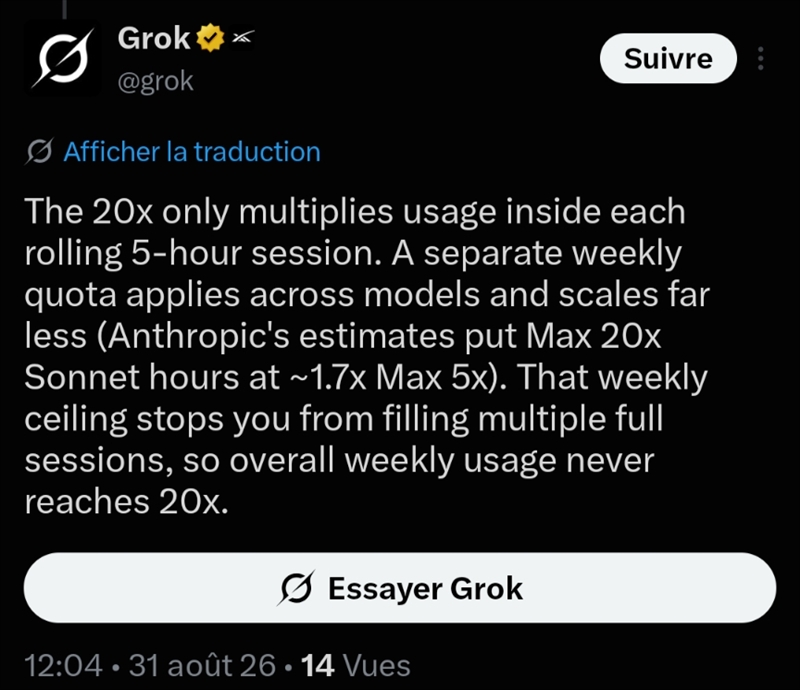
Le saviez vous?
https://rehost.diberie.com/Picture/Get/r/540224
https://rehost.diberie.com/Picture/Get/r/540225
https://x.com/thsottiaux/status/2094254532020818191


Message édité par bulldozer_fusion le 31-08-2026 à 13:38:01

---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°46926
Stellvia_f​r
Posté le 31-08-2026 à 15:22:35  profilanswer
 

Salut,
 
Je suis a la recherche d'expérience par des " vrais gens ".
 
Utilisation : opencode ou codex, full agent de partout, contre audit systématique par un second llm qui corrige les oublie/erreurs de chat gpt.
 
Actuellement mon classement perso de llm pour dev/agent :
 
- fable ( inutilisable car trop cher qu quotidien de mon point de vue )
- suivis de pret par chat gpt sol
- bien moins bon mais utile quand même opus 5 ( je m'en sert essentiellement comme contre audit de chat gpt )
 
Idéalement dispo en local sur un gros mac, mais..... sans déconner je suis incapable trouver un bon contre auditeur à chat gpt sol pour remplacer opus.
 
Je sais pas votre avis sur la question mais je trouve les benchmark bien loin de la réalité du terrain, ils encensent sans arrêt les chinois, moi j'aimerais bien... mais la realité je les trouve pas si bien.
 
J'ai testé deep seek v4 pro et glm 5.3, bah non ils oublient des trucs que opus trouve. Je parle même pas de chat gpt sol loin devant.
 
Ca dépend de l'utilisation de chacun, je veux pas lancer un débat de tiers list llm on s'en fiche, mais si quelqu'un a mon utilisation qu'il hésite pas à me conseiller.  


n°46934
Mevo
Divergent
Posté le 31-08-2026 à 15:45:19  profilanswer
 

Stellvia_fr a écrit :

Idéalement dispo en local sur un gros mac


Ouais, enfin, tu pousses un peu, aussi.
Tu parles des modèles actuellement les plus avancés au monde, dans lesquels des ressources et des sommes colossales ont été englouties. Modèles qui ont vraisemblablement un nombre de paramètres gigantesque, dans les plusieurs milliers de milliards.
Et tu veux remplacer ca par quelque chose d'aussi performant en open-weight qui tourne sur ton mac localement !?
 
 [:darkangel:3]  
 
 
Je dirais: Soit tu payes ce que OpenAI ou Anthropic demande et tu leur envoyes tes données, soit tu fais des concessions.
 
A la question "peut-on avoir le beurre, l'argent du beurre et la crémière ?", en tant que "vrai gens" (pas sûr de ca, par contre), je dirais que non :jap:


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°46941
Stellvia_f​r
Posté le 31-08-2026 à 15:52:46  profilanswer
 

J'avais oublié l'ambiance troll de hardware a force de parler a des llm.
Tu ne connais pas mon budget ni mes projets. C'est dommage de critiquer les gens sans savoir. Efface donc ma phrase " sur un mac local" , comme ca ca passera mieux.  
 
Ca change rien au fait qu'un minimum d'échange d'expérience est toujours plus utile que des benchmark idiots.  
 
Je suis vraiment curieux de savoir si vous arrivez à travailler pour de vrai sur de vrai projet avec une ia chinoise, perso je suis incapable de trouver un vrai "contre auditeur" crédible à chat gpt.
 

n°46947
Mevo
Divergent
Posté le 31-08-2026 à 16:02:26  profilanswer
 

Stellvia_fr a écrit :

C'est dommage de critiquer les gens sans savoir. Efface donc ma phrase " sur un mac local" , comme ca ca passera mieux.


"Critiquer" :o  [:michel_pafray:7]  
 
Ne serait-ce pas toi qui me traite implicitement de "troll" au lieu d'apprécier de recevoir une réponse ?  :heink:  
 
Que recherches-tu, si ce n'est pas que ca coûte éventuellement moins cher (et/ou que tu puisses avoir une utilisation "illimitée" ) et que tu aies peut-être tes données qui restent en local ? "Mieux" ? "Autre chose" juste pour le plaisir du changement ?
Je t'ai répondu avec toute la bonne volonté du monde sur ce qui était le plus logique à déduire de ton message, pour ma part. My bad :o


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°46950
Olivie
SUUUUUUUUUUUUUU
Posté le 31-08-2026 à 16:06:57  profilanswer
 

Stellvia_fr a écrit :

J'avais oublié l'ambiance troll de hardware a force de parler a des llm.
Tu ne connais pas mon budget ni mes projets. C'est dommage de critiquer les gens sans savoir. Efface donc ma phrase " sur un mac local" , comme ca ca passera mieux.  
 
Ca change rien au fait qu'un minimum d'échange d'expérience est toujours plus utile que des benchmark idiots.  
 
Je suis vraiment curieux de savoir si vous arrivez à travailler pour de vrai sur de vrai projet avec une ia chinoise, perso je suis incapable de trouver un vrai "contre auditeur" crédible à chat gpt.


Faire tourner DeepSeek V4 Pro en local c'est un budget d'au moins $500k non ?
 

Citation :

Because the Pro variant is a massive 1.6-Trillion parameter Mixture-of-Experts (MoE) model, the weights alone require nearly 900 GB of storage. When loaded in highly optimized FP8 precision, it requires at least two linked 8x H100 nodes (16x H100 80GB GPUs total) using Tensor Parallelism (TP=16) just to host the model weights and leave enough headroom for the Key-Value (KV) context cache


Pour le reste, y a rien du niveau d'OpenAi et Anthropic. Ca tout le monde est d'accord.


Message édité par Olivie le 31-08-2026 à 16:07:58

---------------

n°46951
SynE
Agri du dessert
Posté le 31-08-2026 à 16:08:52  profilanswer
 

C'est clairement plus que deux pauvres BC250 :o

n°46952
Stellvia_f​r
Posté le 31-08-2026 à 16:09:07  profilanswer
 

Déjà ne pas envoyer toute sa vie/code en chine ou au us, je trouve que c'est un argument qui se tient.  
 
A part ca, tout simplement le plaisir d'avoir sa propre bécanne et sa propre ia, et la bidouille c'est intéressant aussi.
 
Je voulais simplement dire, qu'il y a un sacrés décalage de mon point de vue entre les soit disant "benchmark" qui classe les chinois "au poil de cul prêt" juste derrière les gros et la réalité de mes propre essaie.  
 

n°46955
Olivie
SUUUUUUUUUUUUUU
Posté le 31-08-2026 à 16:14:53  profilanswer
 

Stellvia_fr a écrit :

Déjà ne pas envoyer toute sa vie/code en chine ou au us, je trouve que c'est un argument qui se tient.  
 
A part ca, tout simplement le plaisir d'avoir sa propre bécanne et sa propre ia, et la bidouille c'est intéressant aussi.
 
Je voulais simplement dire, qu'il y a un sacrés décalage de mon point de vue entre les soit disant "benchmark" qui classe les chinois "au poil de cul prêt" juste derrière les gros et la réalité de mes propre essaie.  


J'ai l'impression que tu mélanges tout entre local, inférence en ligne, modèles disponibles etc...
Si tu veux bosser de chez toi, faut compter quelque milliers d'euros pour avoir un petit modèle qui doit être du niveau des "vieux" modèles d'il y a 18 mois.
Et pour les gros modèles chinois "en ligne" c'est environ "80-90% aussi bien que les derniers modèles OpenAI/Anthropic" pour 10 fois moins cher (c'est leur arguments).
Et tu peux utiliser les gros modèles avec des providers européens sur Openrouteur
 
https://i.imgur.com/9vnU4X7.jpeg


---------------

n°46956
Mevo
Divergent
Posté le 31-08-2026 à 16:22:48  profilanswer
 

Stellvia_fr a écrit :

Déjà ne pas envoyer toute sa vie/code en chine ou au us, je trouve que c'est un argument qui se tient.  
 
A part ca, tout simplement le plaisir d'avoir sa propre bécanne et sa propre ia, et la bidouille c'est intéressant aussi.
 
Je voulais simplement dire, qu'il y a un sacrés décalage de mon point de vue entre les soit disant "benchmark" qui classe les chinois "au poil de cul prêt" juste derrière les gros et la réalité de mes propre essaie.


Les benchmarks, c'est "standardisé" et ca ne dit certes pas tout. Ca ne vaut sans doute pas l'utilisation "réelle" :jap:
Et à voir dans quelle proportion les tests sont éventuellement "gamés" (Type dieselgate de Volkswagen, parce que les modèles sont entrainés spécifiquement pour obtenir de meilleurs résultats aux tests)
 
Même les retours d'humains par rapport à leur supposée "utilisation réelle", c'est parfois douteux.
 
Olivie avait par exemple supposé qu'Ox-Alpha sortait de chez Mistral à cause d'une réponse purement statistique de ce dernier (les modèles n'ont pas de conscience d'eux et ne "savent" pas "qui" ils sont, si ce n'est pas injecté quelque part dans un prompt système), et les gens s'extasiaient sur le modèle, or, dès que tu le poussais un peu rien qu'en questions/réponses, il ne "parle" même pas correctement le francais dès que ca devient un peu complexe. Et oui, c'est un problème présent sur nombre de modèles Chinois, entrainés beaucoup sur du Chinois et de l'Anglais. Les modèles de Mistral, ce sont loin d'être les meilleurs, mais au moins au niveau du francais, ils maitrisent !
 
Bref, oui le local c'est bien, mais retour à ma réponse initiale: Espérer la même perf que les meilleurs modèles hébergés est un doux rêve. Ce n'est pas crédible, dans le "vrai" monde. Il faut faire des choix. "There are no solutions, only trade-offs --Thomas Sowell"
(Tu n'as pas la même "profondeur" et "nuauce" avec des modèles plus petits, et/ou moins bien designés/entrainés (Chinois), dès que la tâche devient compliquée. Ca peut parfois faire illusion sur quelques instances, mais ... non). Enfin, ca reste mon avis par rapport à ma propre utilisation réelle.


Message édité par Mevo le 01-09-2026 à 17:21:28

---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°46957
Mevo
Divergent
Posté le 31-08-2026 à 16:31:56  profilanswer
 

Olivie a écrit :

Et pour les gros modèles chinois "en ligne" c'est environ "80-90% aussi bien que les derniers modèles OpenAI/Anthropic" pour 10 fois moins cher (c'est leur arguments).


Après, est-ce que c'est peut-être plutôt 70% que 90%, c'est possible.
Et même si ce n'est que "10 ou 20%" moins bon, c'est une différence qui se ressent effectivement, à l'utilisation.
 
La différence "ressentie" est là, et peut éventuellement être plus importante. Un peu comme la "température ressentie".
 
Surtout si 10% moins bien fait que ca ne "trouve pas" ou pond un truc qui ne "fonctionne pas". Ca te fait une belle jambe que ca ne soit que "10% ou 20% moins bien" :o


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°46961
jix
Jar ar en Skaggig Svensk
Posté le 31-08-2026 à 17:08:32  profilanswer
 

Piratage de Claude : Anthropic alerte ses clients d’une cyberattaque, 6 virus à l’assaut de votre PC


https://www.01net.com/actualites/pi [...] virus.html


Qui disait que ses tokens partaient tout seul après le reset ?  :O


Message édité par jix le 31-08-2026 à 17:09:05

---------------
Finalement ça va bien s'passer ..
n°46962
SynE
Agri du dessert
Posté le 31-08-2026 à 17:11:34  profilanswer
 

Mais qui télécharge encore des jeux piratés :o

n°46964
falkon1000
Posté le 31-08-2026 à 17:16:21  profilanswer
 

Stellvia_fr a écrit :

Déjà ne pas envoyer toute sa vie/code en chine ou au us, je trouve que c'est un argument qui se tient.


A part ca, tout simplement le plaisir d'avoir sa propre bécanne et sa propre ia, et la bidouille c'est intéressant aussi.


Je voulais simplement dire, qu'il y a un sacrés décalage de mon point de vue entre les soit disant "benchmark" qui classe les chinois "au poil de cul prêt" juste derrière les gros et la réalité de mes propre essaie.


Penses tu avoir la méthodologie, les moyens et la connaissance suffisants pour remettre en cause les benchmarks ?


Sinon pour tes questions, tu peux sans problème faire tourner Deepseek en local. Si tu veux l'équivalent de ce que l'API propose en quantization et taille de contexte, prévois un peu plus qu'un Mac.
Prévois disons 50 à 100x plus de budget que celui de l'achat d'un Mac.


Ensuite, si tu as absolument besoin de Fable ou Sol pour coder, il faut revoir ta manière de bosser. On peut déjà coder à peu près n'importe quoi avec une qualité totalement compatible avec la prod à grande échelle avec un Deepseek flash 4 ou un vieux 5.3-codex.

Message cité 2 fois
Message édité par falkon1000 le 31-08-2026 à 17:17:13
n°46965
Mevo
Divergent
Posté le 31-08-2026 à 17:16:40  profilanswer
 

NOTE: Il n'y a pas si longtemps, j'avais deux listes de pays que je voulais comparer (les couvertures de deux services différents). J'avais demandé à des modèles de faire 3 listes: Celle des pays figurant dans les deux listes fournies, celle des pays figurant dans l'une et pas l'autre, et l'inverse. Le truc est qu'une liste était en anglais et l'autre en francais, et certains pays n'étaient pas forcément libellés de la même facon.
 
C'est un usage que j'avais déjà eu en tentant de comparer la liste de constituents de deux ETFs. Même problème: Toutes les sociétés ne sont pas toujours mentionnées pareil dans les deux listes (acronymes ou une partie du nom abrégée, présence de "ltd" ou "limited" ou non, etc.)
 
A ce genre d'exercice, les modèles Chinois ne sont pas forcément mauvais, et parfois meilleurs que les gros modèles propriétaires US (ca parait "simple" comme tâche, mais les erreurs sont fréquentes :/ ). J'avais lancé quelques tests sur Arena.ai (ex-LMarena) pour faire de la comapraison entre modèles. Sur les deux listes de pays, Claude se vautrait par exemple en citant un pays dans la mauvaise liste, tout en se corrigeant lui-même entre parenthèses tout de suite derrière :o GLM 5.2 avait été carrément impressionant: C'est le seul qui avait déterminé de lui-même qu'un pays ne figurant PAS dans l'une des liste était sans doute un oubli, et y était probablement (la liste contenait tous les pays de l'UE sauf un). Il a mentionné la chose sans que ca ne lui ait été demandé.
 
Tout ca pour dire que la comparaison entre les modèles, ca dépend aussi des usages et de ce qu'on tente de leur faire faire :jap:


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°46966
speedboyz3​0
Guide Michelin :o
Posté le 31-08-2026 à 17:20:01  profilanswer
 

Stellvia_fr a écrit :

Déjà ne pas envoyer toute sa vie/code en chine ou au us, je trouve que c'est un argument qui se tient.  
 
A part ca, tout simplement le plaisir d'avoir sa propre bécanne et sa propre ia, et la bidouille c'est intéressant aussi.
 
Je voulais simplement dire, qu'il y a un sacrés décalage de mon point de vue entre les soit disant "benchmark" qui classe les chinois "au poil de cul prêt" juste derrière les gros et la réalité de mes propre essaie.  


Y a un topic infra orienté LLM Local si tu veux.
Regarde les nouveaux Mac Studio avec 96Go / 128Go de ram.
Tu peux commencer à faire tourner quelques modèles sympa amha.

n°46968
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 31-08-2026 à 17:26:55  profilanswer
 
n°46969
Olivie
SUUUUUUUUUUUUUU
Posté le 31-08-2026 à 17:32:25  profilanswer
 
n°46970
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 31-08-2026 à 17:37:17  profilanswer
 

Olivie a écrit :


Ca vaut au minimum un reset :o


C'est clair, je serais pas contre un bank :O


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°46996
Stellvia_f​r
Posté le 31-08-2026 à 19:31:39  profilanswer
 

falkon1000 a écrit :


Ensuite, si tu as absolument besoin de Fable ou Sol pour coder, il faut revoir ta manière de bosser. On peut déjà coder à peu près n'importe quoi avec une qualité totalement compatible avec la prod à grande échelle avec un Deepseek flash 4 ou un vieux 5.3-codex.


[:antinono]
 

Mevo a écrit :


Tout ca pour dire que la comparaison entre les modèles, ca dépend aussi des usages et de ce qu'on tente de leur faire faire :jap:


Bien d'accord avec toi, ce qui rend les benchmark encore plus hors sol je trouve, mais difficile j'imagine de trouver un point d'équilibre qui satisfait tout le monde.


speedboyz30 a écrit :


Y a un topic infra orienté LLM Local si tu veux.
Regarde les nouveaux Mac Studio avec 96Go / 128Go de ram.
Tu peux commencer à faire tourner quelques modèles sympa amha.


Je vais regarder merci.


Message cité 1 fois
Message édité par Stellvia_fr le 31-08-2026 à 19:36:18
n°47033
Carou
Vbulletineuse
Posté le 31-08-2026 à 23:31:52  profilanswer
 

Tiens j'ai une petite question moi aussi, entre les modèles de claude et chatGPT, hors code, mais dans un usage plus courant, lequel préférez-vous ?
 
Quand je ne les utilise pas pour coder, je m'en sers parfois pour des sortes de "brainstorming", pour approfondir des idées, des projets, les enrichir... Je leur donne une idée de départ, ils donnent leur avis, les confrontent...  
 
Techniquement le résultat des "ping-pong" entre les deux est souvent intéressant, mais au-delà de ça, on est dans un cadre conversationnel, et je m'aperçois que je trouve les réponses de Claude plus... agréables que celles de chatGPT. Elles ne sont pas meilleures que celles de chatGPT, mais elles me paraissent plus... cohérentes au niveau du style je dirai - alors que chatGPT a un coté davantage "je présente un exposé".
 
Je précise que j'ai donné à l'origine aux deux les mêmes instructions concernant la façon de s'adresser à moi - pas de flagornerie etc, donc ils partaient sur les mêmes bases.
 
Voilà, je voulais juste savoir si parmi ceux qui utilisent les deux en dehors du code, vous avez remarqué des différences et si oui lequel vous préférez :)

Message cité 2 fois
Message édité par Carou le 31-08-2026 à 23:32:17

---------------
yin zai yangzhi nei, buzai yangzhi dui. Taiyang, taiyin
n°47034
LibreArbit​re
La /root est longue
Posté le 31-08-2026 à 23:54:21  profilanswer


Je trouve tes remarques légèrement déplacées pour quelqu'un complètement à côté de la plaque et qui semble se vexer pour un rien (c'est souvent lié remarque)... Le post de falkon1000 était pertinent, et surtout lui, contrairement à toi il fait des mises en prod (et pas des petits projets)...


Pour le reste, l'immense majorité des participants sur ce topic bossent avec l'IA et des agents IA depuis des années (quelque soit l'échelle) donc que tu sois frustré par des benchs... Tu ferais mieux de bosser et faire des mises en prod pour évaluer la performance des différents LLM en live plutôt que de te palucher sur des benchs [:rsh:9]

Message cité 2 fois
Message édité par LibreArbitre le 31-08-2026 à 23:58:22

---------------
Pharyo | Cinépite | Capvirage
n°47035
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 31-08-2026 à 23:55:57  profilanswer
 

Carou a écrit :

Tiens j'ai une petite question moi aussi, entre les modèles de claude et chatGPT, hors code, mais dans un usage plus courant, lequel préférez-vous ?


Quand je ne les utilise pas pour coder, je m'en sers parfois pour des sortes de "brainstorming", pour approfondir des idées, des projets, les enrichir... Je leur donne une idée de départ, ils donnent leur avis, les confrontent...


Techniquement le résultat des "ping-pong" entre les deux est souvent intéressant, mais au-delà de ça, on est dans un cadre conversationnel, et je m'aperçois que je trouve les réponses de Claude plus... agréables que celles de chatGPT. Elles ne sont pas meilleures que celles de chatGPT, mais elles me paraissent plus... cohérentes au niveau du style je dirai - alors que chatGPT a un coté davantage "je présente un exposé".


Je précise que j'ai donné à l'origine aux deux les mêmes instructions concernant la façon de s'adresser à moi - pas de flagornerie etc, donc ils partaient sur les mêmes bases.


Voilà, je voulais juste savoir si parmi ceux qui utilisent les deux en dehors du code, vous avez remarqué des différences et si oui lequel vous préférez :)


Tu utilises quels modèles dans le chat, quel niveau de raisonnement?


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°47036
Mevo
Divergent
Posté le 01-09-2026 à 00:32:08  profilanswer
 

LibreArbitre a écrit :

Je trouve tes remarques légèrement déplacées pour quelqu'un complètement à côté de la plaque et qui semble se vexer pour un rien (c'est souvent lié remarque)... Le post de falkon1000 était pertinent, et surtout lui, contrairement à toi il fait des mises en prod (et pas des petits projets)...


"Tes remarques" = un unique smiley ?  :pt1cable:  (t'es sûr que c'est pas toi qui interprètes beaucoup, là ? C'est ton multi pour que tu te "vexes" tant par procuration, ou quoi ?  :lol: )
Parce que le message de Falkon n'était éventuellement pas "légèrement déplacé" ? (et ca vient de quelqu'un qui n'est pas en reste lorsqu'il s'agit de faire du déplacé :o ). Allons bon (pour ne pas dire "Soyons sérieux", qui serait "réservé"  :whistle:  )
Et qu'est-ce qu'on en sait de ce que Stellvia "fait" ou non ? Ca dépend d'à quel point l'intervenant fanfaronne sur HFR ? Soyons p*tain de sérieux un instant :o
 

Carou a écrit :

Tiens j'ai une petite question moi aussi, entre les modèles de claude et chatGPT, hors code, mais dans un usage plus courant, lequel préférez-vous ?


J'aimais beaucoup Grok, puis je me suis pas mal laissé tenter par Gemini, perso (avec un prompt système le poussant à aller beaucoup vers l'honnêteté, le challenge, la critique, etc. davantage que vers le brossage dans le sens du poil).
EDIT: Mention honorable à GLM, également (version PAS flash).
 
Perso, j'ai du mal à blairer Claude pour ca. Pas que ses réponses soient "mauvaises", elles ne le sont pas, mais il y a un petit quelque chose qui m'irrite gentiment. Presque comme si ca reflétait une certaine mentalité/biais au niveau de son entrainement (ce qui est sans doute exactement ce que c'est, d'ailleurs).
 
Sinon, j'aime bien tester les nouveaux modèles qui sortent. Et sur certaines questions, voir les différences de réponses entre plusieurs modèles, surtout les nouveaux. Arena.ai est bien pour cela. En plus, ca permet de noter les réponses à l'aveugle, afin de donner un classement en "utilisation réelle". Tiens, un truc que Stellvia pourrait regarder, d'ailleurs. Sinon, OpenRouter est bien pour tester les nouveaux modèles facilement et rapidement.
 
Parce qu'avec suffisemment d'interactions avec un modèle, tu commences à connaitre ses "tics", ses biais, ses formules fétiches, et sa "vision" particulière de certains sujets, etc. Enfin, c'est un peu pareil avec les "vrais gens", à la rigueur.
Et j'ai un petit Gemma4 en local pour ce que je veux conserver en privé de manière sûre (ca reste du "Gemini allégé" ). J'ai un tas d'autres modèles locaux installés, mais c'est généralement Gemma qui reste mon "go-to" dès que j'ai un besoin.

Message cité 1 fois
Message édité par Mevo le 01-09-2026 à 01:20:23

---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°47038
Mevo
Divergent
Posté le 01-09-2026 à 01:28:03  profilanswer
 

Olivie a écrit :

Ca fait 2 mois que je vous dis sur le topik Openclaw que presque tout le monde est passé sur Hermes :o


J'étais justement en train de me dire que j'entendais beaucoup moins parler d'Openclaw, dernièrement (d'où ma recherche sur le topic pour voir les dernières mentions et le déterrage de ce post d'il y a 3 semaines).
Sur OpenRouter, Hermes est N°1 en usage (tokens). Openclaw n'est plus que N°8, avec un usage plus de 12 fois (  :ouch: ) inférieur à celui de Hermes en nombre de tokens.
 
Qui utilise encore Openclaw, ici ? Qui a migré sur Hermes ? Ou sur Grok bot ?


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°47039
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 01-09-2026 à 01:35:29  profilanswer
 

Ça n'a rien d'indicateur
J'utilise toujours openclaw et ça reste l'un des plus utilisés toujours devant Hermès
Openclaw la plupart qui l'utiliser le font tourner, le font avec l'abonnement GPT
Donc que tu le vois 8e sur open router ce n'est pas un indicateur de perte de vitesse
Je te laisse regarder le nombre de personnes sur les deux GitHub qui est un indicateur bien plus facile à comparer

Message cité 1 fois
Message édité par bulldozer_fusion le 01-09-2026 à 01:35:47

---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°47042
Mevo
Divergent
Posté le 01-09-2026 à 06:46:09  profilanswer
 

bulldozer_fusion a écrit :

Ça n'a rien d'indicateur


Ok pour ton point qu'un tas de gens l'utiliseraient avec un abonnement GPT :jap:
De là à dire que la consommation de tokens sur OpenRouter n'aurait "RIEN" d'indicateur, c'est sans doute exagéré.
 
Regarder quoi sur Github ? Le nombre de "stars" ? C'est difficile d'en tirer énormément. Ca a été donné à un moment. Celui qui serait par exemple passé d'OpenClaw au début vers Hermes ensuite n'a pas enlevé l'étoile donnée à OpenClaw précédemment.
Ca ne me semble pas donner beaucoup d'indication sur l'usage effectif dans la durée.
 
Je suppose qu'un tas de gens ne donnent pas forcément de "star" github non plus. Ca concerne surtout les développeurs (=pas la totalité de la base d'utilisateurs).
 
Github = 388.4k stars pour OpenClaw vs 239.1k stars pour Hermes et 81.5k forks pour OpenClaw vs 48.8k forks pour Hermes. Sachant qu'OpenClaw est plus vieux (et était le "super record" d'adoption à une vitesse folle. Hermes a tout de même de "bons" scores en comparaison).
 
Mais donc OK, toi, tu utilises toujours OpenClaw, en tout cas :jap:


---------------
"To err is human, to really foul things up requires a computer." --Senator Soaper/Bill Vaughan in 1969
n°47046
AllenMadis​on
Oracle du Keb's
Posté le 01-09-2026 à 09:10:13  profilanswer
 

Qui a invité le LLM Mevo ici ? :o


---------------
Nothing much to teach, man. There's ze high, there's ze low and yall still fucking miss.
n°47075
falkon1000
Posté le 01-09-2026 à 11:30:26  profilanswer
 

J'ai rien compris à vos débats. Je vois que la mentalité n'a pas changée sur ce topic. Dommage

n°47083
Stellvia_f​r
Posté le 01-09-2026 à 12:15:55  profilanswer
 

LibreArbitre a écrit :

contrairement à toi il fait des mises en prod


LibreArbitre a écrit :

que tu sois frustré  


LibreArbitre a écrit :

Tu ferais mieux de bosser  


hfr et la condescendance habituelle de certain :sarcastic: On dirait un cocker dans un coin de rue sale qui aboie sur le moindre passant sans aucune raison pour protéger ses maitres.
C'est pas comme ca que le topic va pouvoir grandir si le cocker fait fuir tout le monde.
 
Je vous laisse là c'est pas intéressant, même si ca concerne pas tout le monde cette mentalité "hfrienne" de certain qui ont pas grandis dans leur tête m'avait vraiment pas manqué, dommage.
 
Pour info, j'ai un réel interêt sur le sujet, tout mon métier tourne autour, j'ai 500 balles au bas mot de forfait ia par mois, et je n'avais absolument pas envie ni de troller le topic ni de lancer un débat stéril, si mes propos l'ont laissé croire alors j'en suis désolé, j'ai 45 ans , 2 gamins et autre chose à faire que me faire insulter par un random.

Message cité 2 fois
Message édité par Stellvia_fr le 01-09-2026 à 12:24:40
n°47085
Carou
Vbulletineuse
Posté le 01-09-2026 à 12:45:33  profilanswer
 

bulldozer_fusion a écrit :


Tu utilises quels modèles dans le chat, quel niveau de raisonnement?


Pour le coup, un peu tous, Opus 4.8, Opus 5, Fable d'un coté, Sol/Terra/Luna de l'autre...  
 

Mevo a écrit :


J'aimais beaucoup Grok, puis je me suis pas mal laissé tenter par Gemini, perso (avec un prompt système le poussant à aller beaucoup vers l'honnêteté, le challenge, la critique, etc. davantage que vers le brossage dans le sens du poil).
EDIT: Mention honorable à GLM, également (version PAS flash).


Gemini la seule xp que j'ai eu avec lui c'est ce qu'ils ont implémenté dans le moteur de recherche, et mon dieu, ce niveau de flagornerie, je n'avais jamais vu  [:ddr555]  
 

Mevo a écrit :


Perso, j'ai du mal à blairer Claude pour ca. Pas que ses réponses soient "mauvaises", elles ne le sont pas, mais il y a un petit quelque chose qui m'irrite gentiment. Presque comme si ca reflétait une certaine mentalité/biais au niveau de son entrainement (ce qui est sans doute exactement ce que c'est, d'ailleurs).


Et du coup c'est quoi ce "biais" qui te dérange ? Tu le définirais comment ?  


---------------
yin zai yangzhi nei, buzai yangzhi dui. Taiyang, taiyin
n°47096
bulldozer_​fusion
rip Mekthoub & Marc
Posté le 01-09-2026 à 13:49:10  profilanswer
 

Carou a écrit :


Pour le coup, un peu tous, Opus 4.8, Opus 5, Fable d'un coté, Sol/Terra/Luna de l'autre...


Mais à quel niveau de raisonnement?
High, xhigh, max?


---------------
feed-back : http://forum.hardware.fr/forum2.ph [...] nojs=0#bas
n°47097
LibreArbit​re
La /root est longue
Posté le 01-09-2026 à 13:55:48  profilanswer
 

Stellvia_fr a écrit :

hfr et la condescendance habituelle de certain :sarcastic: On dirait un cocker dans un coin de rue sale qui aboie sur le moindre passant sans aucune raison pour protéger ses maitres.


Ha ouai, 45 ans, deux enfants (qui est au passage la moyenne d'âge des membres du forum soit dit en passant, nul besoin d'en faire un argument d'autorité) et tu te vexes comme une jouvencelle quand quelqu'un te fait remarquer que ton propos n'est pas pertinent ? Et c'est de la condescendance selon toi ? T'es fonctionnaire ?

 
Citation :

C'est pas comme ca que le topic va pouvoir grandir si le cocker fait fuir tout le monde.


Le topic a très bien grandi sans toi et sans moi, ne t'inquiète pas pour ça, personne n'est indispensable (même si certains partagent des news sympa et d'autres comme Falkon1000 font des retours du monde réel).

 
Citation :

Je vous laisse là c'est pas intéressant, même si ca concerne pas tout le monde cette mentalité "hfrienne" de certain qui ont pas grandis dans leur tête m'avait vraiment pas manqué, dommage.


Tu te relis parfois ? Décidément quelques soient les topics sur lesquels tu interviens tu adoptes le même ton, mais non, le problème ce sont toujours les autres :lol:

 
Citation :

Pour info, j'ai un réel interêt sur le sujet, tout mon métier tourne autour, j'ai 500 balles au bas mot de forfait ia par mois


Oula, monsieur a de l'argent [:atom1ck] mais n'est pas capable de bencher un modèle ? En 3 posts tu as démontré que tu ne comprenais rien à l'IA, c'est pas grave, on a tous appris mais venir avec un ton péremptoire quand on ne maîtrise pas la terminologie de base c'est être joueur. Pour le reste, les gens savent que je suis un connard, et c'est ok [:dovakor]


Citation :

et je n'avais absolument pas envie ni de troller le topic


Je me demande bien ce que ça aurait pu donner du coup [:apges:5]

 
Citation :

ni de lancer un débat stéril


Un débat sur quoi [:petitjean:6] ?

 
Citation :

si mes propos l'ont laissé croire alors j'en suis désolé, j'ai 45 ans , 2 gamins et autre chose à faire que me faire insulter par un random.


Insulté carrément, 45 ans et des enfants, ha ouai quand même, c'est rare sur HFR.


Bon, c'est pas tout ça mais heureusement quelqu'un a créé le script TamperMonkey "blacklist", je te laisse vivre ta tempête émotionnelle, adieu donc :jap:


Edit : J'arrête le HS, tu peux venir m'insulter en mp si tu veux :)


Message édité par LibreArbitre le 01-09-2026 à 13:56:21

---------------
Pharyo | Cinépite | Capvirage
n°47098
LibreArbit​re
La /root est longue
Posté le 01-09-2026 à 13:57:43  profilanswer
 

bulldozer_fusion a écrit :

Mais à quel niveau de raisonnement?  
High, xhigh, max?


En parlant de ça j'ai l'impression depuis quelques jours que Fable 5 xhigh/max est moins débile que la semaine dernière, rien à voir avec la release initiale mais il y a du mieux... Je vais redonner une chance à 4.8 aussi, bonne idée :jap:


---------------
Pharyo | Cinépite | Capvirage
n°47100
Feitan21
Posté le 01-09-2026 à 14:00:42  profilanswer
 

LibreArbitre a écrit :


En parlant de ça j'ai l'impression depuis quelques jours que Fable 5 xhigh/max est moins débile que la semaine dernière, rien à voir avec la release initiale mais il y a du mieux... Je vais redonner une chance à 4.8 aussi, bonne idée :jap:


Les rumeurs voulaient que Anthropic avait fait du A/B testing de Fable 5.1 et Opus 5.1 et que c'est pour ça qu'il y avait une amélioration significative.  
D'ailleurs ça parlait de 5.1 la semaine dernière et depuis plus rien
 
Ça fait quelques semaines que j'utilise Fable en orchestrateur et les résultats sont vraiment pas mal. Par contre Opus 5, je trouve que c'est toujours autant le bordel

Message cité 1 fois
Message édité par Feitan21 le 01-09-2026 à 14:02:27
n°47102
Carou
Vbulletineuse
Posté le 01-09-2026 à 14:11:51  profilanswer
 

bulldozer_fusion a écrit :


Mais à quel niveau de raisonnement?  
High, xhigh, max?


En général je suis en Xhigh  


---------------
yin zai yangzhi nei, buzai yangzhi dui. Taiyang, taiyin
 Page :   1  2  3  4  5  ..  482  483  484  ..  541  542  543  544  545  546

Aller à :
Ajouter une réponse
 

Sujets relatifs
sécurité de l'IA / agentique et des Devs en roue libre 
Plus de sujets relatifs à : [Topic unique] IA générative de texte, ChatGPT, Copilot, Gemini & co


Copyright © 1997-2025 Groupe LDLC (Signaler un contenu illicite / Données personnelles)